
遇见数据集

CERN/colliderml-benchmark-results

收藏
Hugging Face2026-05-27 更新2026-05-10 收录
官方服务:

资源简介:

ColliderML基准测试结果数据集是一个用于存储ColliderML基准测试任务机器评分排行榜结果的集合。该数据集包含多个基准任务,如粒子追踪(tracking)、喷注分类(jets)、异常检测(anomaly)等,每个任务使用特定的数据集(如ttbar_pu200)并基于主要指标(如TrackML加权效率、AUC等)进行评分。数据以JSON文件形式组织,存储了提交ID、任务名称、提交者、分数、时间戳等信息,并自动由ColliderML后端推送。该数据集支持ColliderML排行榜空间的公开表格渲染,并允许模型通过配置文件链接回此数据集以在模型卡片中自动显示分数。

The ColliderML Benchmark Results dataset is a collection of machine-scored leaderboard results for ColliderML benchmark tasks. It includes multiple benchmark tasks such as tracking, jets, anomaly detection, etc., each using specific datasets (e.g., ttbar_pu200) and evaluated based on primary metrics (e.g., TrackML weighted efficiency, AUC). The data is organized in JSON files containing fields like submission ID, task name, submitter, scores, and timestamps, and is automatically pushed by the ColliderML backend. This dataset powers the public leaderboard table in the ColliderML leaderboard space and allows models to link back to it via configuration files for automatic score display on model cards.
提供机构:
CERN
搜集汇总
数据集介绍
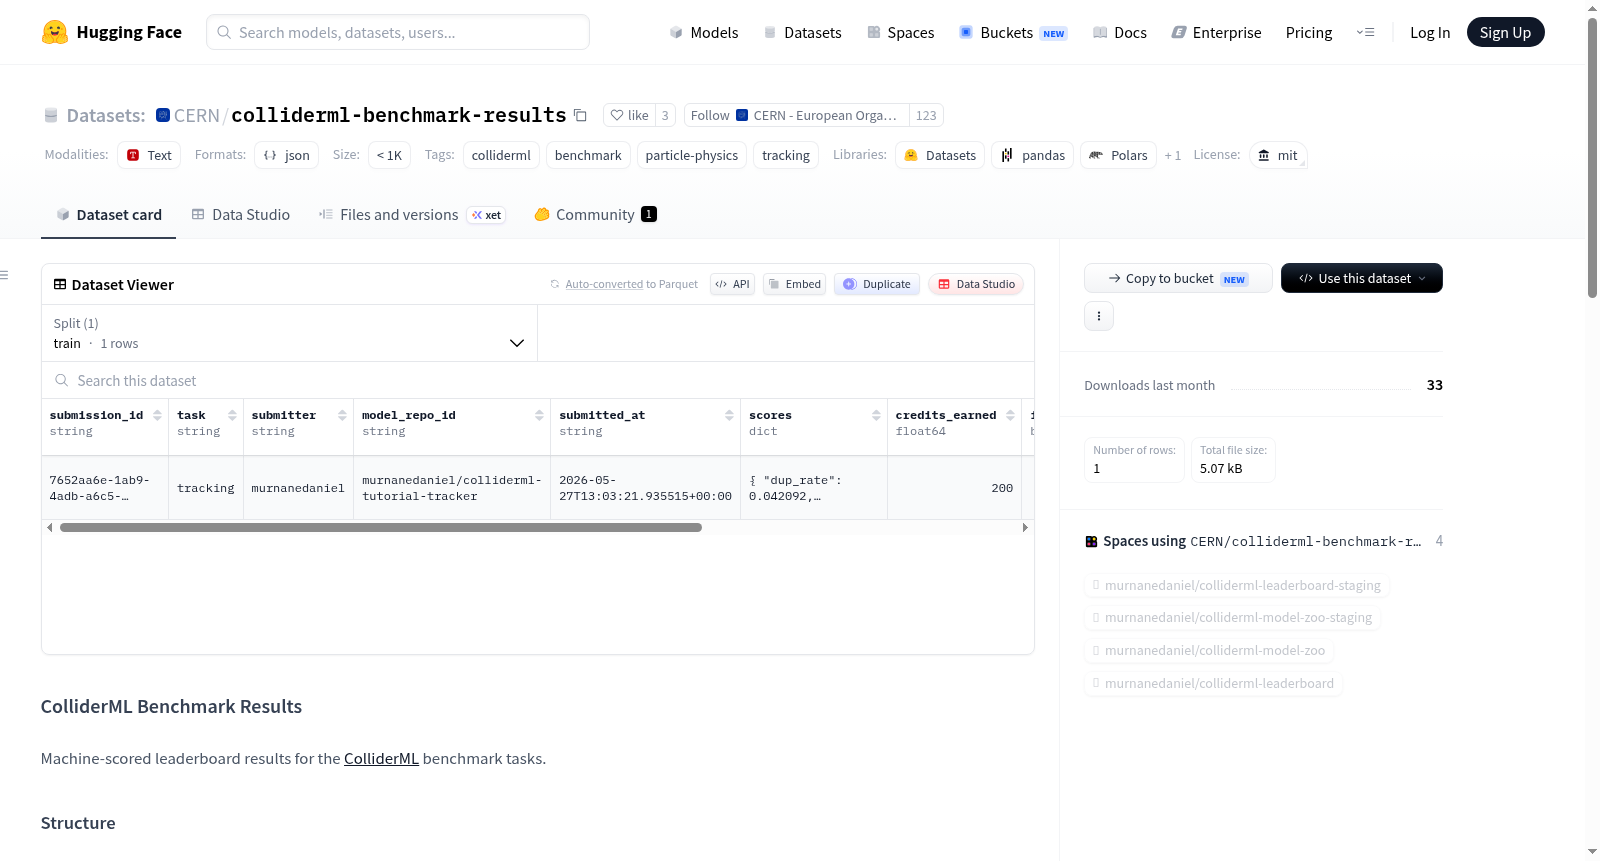
CERN/colliderml-benchmark-results 数据集图片
构建方式
ColliderML Benchmark Results数据集专为粒子物理领域的机器学习基准测试任务而构建,由ColliderML后端在每次提交评分后自动推送结果,确保数据的即时性与权威性。该数据集以JSON格式存储于`results/{task}/{username}/{predictions_sha256}.json`路径下,每条记录包含分配的唯一标识符、任务名称、提交者信息、可选的模型仓库链接、ISO 8601时间戳、评估得分字典、获得积分、是否为基准参考线以及提交文件的SHA-256哈希值,结构严谨且易于追溯。
特点
该数据集涵盖了六大关键基准任务,包括径迹重建、喷注分类、异常检测、推理延迟测量、参数预算下的径迹效率以及数据加载吞吐量,每项任务均关联特定主评估指标和数据集(如`ttbar_pu200`),全面反映了高能物理事件模拟的复杂场景。此外,数据集记录了基准参考线信息,便于对比算法创新,且通过预测文件的哈希值确保了可验证性与不可篡改性,为领域内的可重复研究提供了坚实保障。
使用方法
用户可直接从HuggingFace数据集仓库加载该JSON文件集合,通过`submission_id`或`task`字段过滤特定提交记录,利用`scores`字段提取最优化指标进行模型性能对比。集成了`.eval_results/colliderml_*.yaml`文件的模型会自动链接回此数据集,使模型卡页面同步展示排行榜得分。公有排行榜Space也实时读取该数据集渲染动态表格,社区贡献者可根据`model_repo_id`追溯具体模型,实现了从评估到展示的端到端无缝衔接。
背景与挑战
背景概述
ColliderML Benchmark Results数据集由CERN OpenDataDetector项目团队于近年创建,旨在为高能物理领域的机器学习模型提供标准化性能评估基准。该数据集聚焦于对撞机物理中的关键任务,如粒子径迹重建(tracking)、喷注分类(jets)、异常检测(anomaly)及推理延迟(tracking_latency)等,利用如ttbar_pu200等模拟数据集进行评测。作为ColliderML基准测试的结果存储库,它自动接收来自后端系统的打分结果,并通过HuggingFace Space呈现公开排行榜,为研究者提供可复现的对比平台。该数据集整合了模型提交、评分记录与基线参考,推动了机器学习在对撞机数据处理领域的应用与发展,成为连接实验物理与计算科学的重要桥梁。
当前挑战
该数据集所应对的核心领域挑战在于高能物理实验中,随着大型强子对撞机升级,数据产生速率呈指数级增长,传统算法难以满足实时处理需求,亟需高效的机器学习模型替代方案。构建过程中,团队面临多重困难:首先,需定义统一的评测指标与任务划分,确保不同提交结果间的公平可比性;其次,处理海量模拟数据(如ttbar_pu200)的存储与传输,保证基准测试的可重复性;最后,设计自动化的后端提交与评分机制,兼容多样化模型架构与提交格式,同时维护结果数据的完整性与防篡改能力。这些挑战的解决对于推动机器学习在高能物理中的可靠应用至关重要。
常用场景
经典使用场景
在粒子物理前沿领域,高性能数据集的构建与基准测试是推动机器学习模型发展的关键基石。ColliderML Benchmark Results数据集承载着对撞机物理中多项核心任务的自动化评分记录,其经典使用场景聚焦于为粒子追踪、喷注分类、异常检测及推理延迟等任务提供标准化的性能评估平台。研究人员通过提交模型预测结果,获取诸如TrackML加权效率、分类AUC及AUROC等关键指标,从而在统一框架下横向对比不同算法的优劣,推动粒子物理与深度学习交叉研究的规范化演进。
衍生相关工作
围绕此基准数据集,衍生出一系列具有广泛影响力的研究工作。基于追踪任务基线,多位学者提出了图神经网络(GNN)与Transformer架构在粒子重建中的变体,显著提升了复杂对撞环境下的效率与纯度。喷注分类任务则催生了针对含噪、非平衡数据的对比学习与自监督预训练方法。异常检测子任务更是推动了基于流模型、变分自编码器及异常感知损失的无监督新物理搜索框架的发展。这些工作不仅深化了对对撞机数据内在结构的理解,也反过来将粒子物理中遇到的稀疏图、多变量分布等共性难题馈入通用机器学习社区,实现了跨学科知识的双向赋能。
数据集最近研究
最新研究方向
在高能物理领域中,随着深度学习技术的迅猛发展,基于机器学习的粒子对撞机数据分析已成为前沿热点。ColliderML Benchmark Results数据集应运而生,专为系统评估与对比各类ML模型在粒子跟踪、喷注分类、异常检测等核心任务上的性能而设计。该基准测试不仅覆盖了TrackML加权效率、AUC等关键指标,还融入了推理延迟与数据加载吞吐量等实际部署考量,紧密关联当前大型强子对撞机(LHC)高亮度升级后对实时数据处理能力的需求。通过自动化的后台评分与HuggingFace平台的无缝集成,该数据集促进了模型卡间的可复现性与横向比较,推动了以ttbar_pu200等高保真模拟样本为载体的开放科学实践,加速了ML驱动的粒子物理研究从算法创新到实验验证的闭环迭代。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

