
Ti-Ma/TiMaGPT2-2018
收藏官方服务:
资源简介:
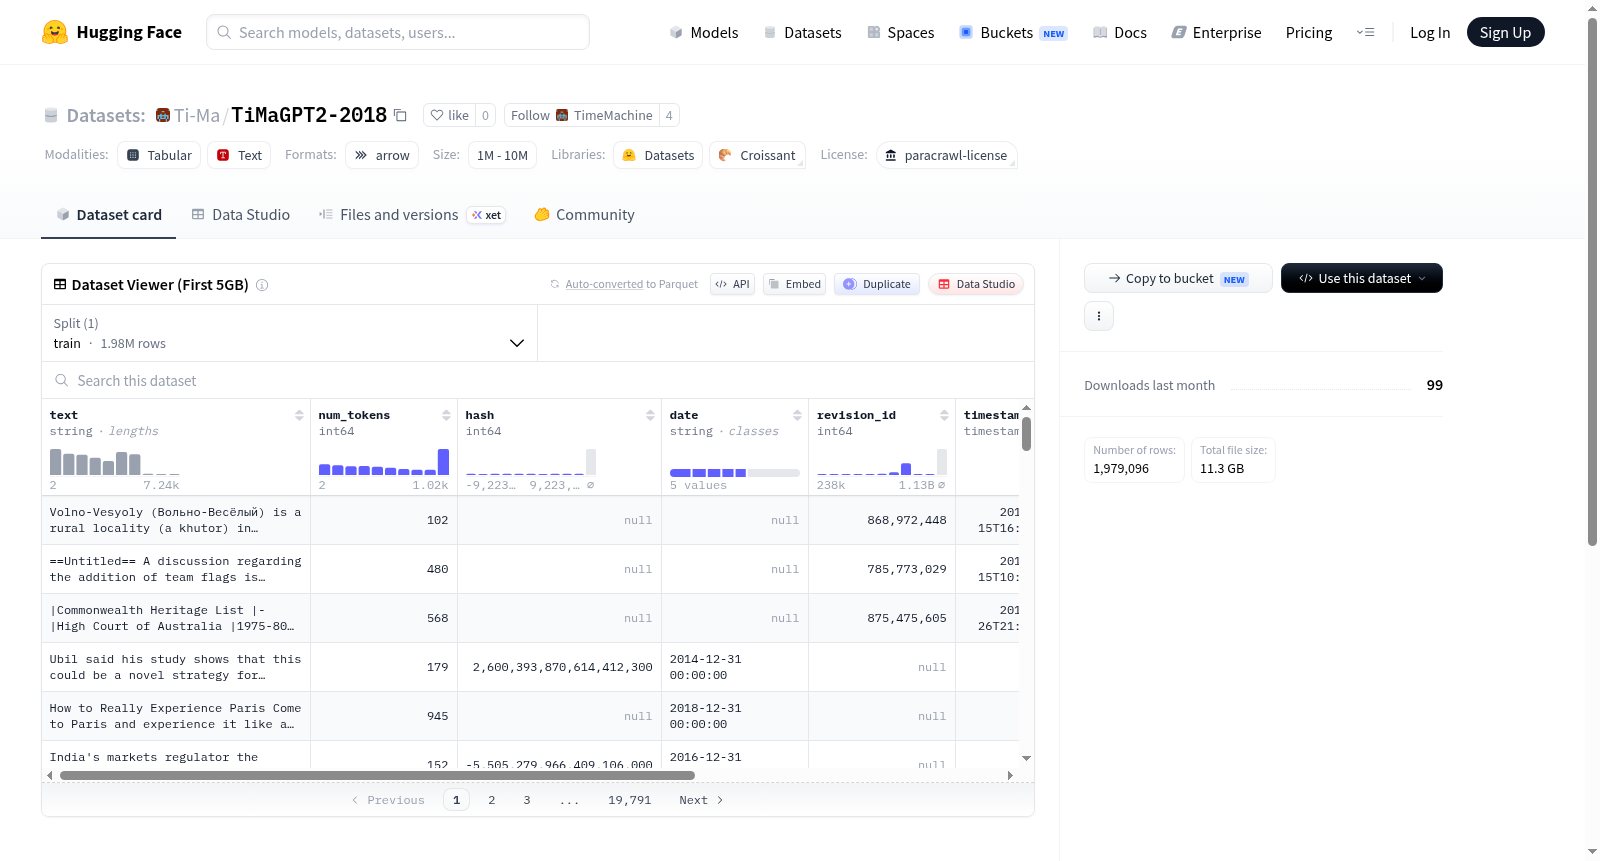
该数据集是基于截至2018年12月31日的历史数据构建的,数据来源包括WMT新闻数据集和Wikipedia。该数据集是用于训练GPT-2-small模型的训练数据集,并且在Huggingface平台上可用。数据集的许可与WMT新闻数据集相同,因为这是构建该训练数据集的两个数据集中限制较多的许可。
该数据集是基于截至2018年12月31日的历史数据构建的,数据来源包括WMT新闻数据集和Wikipedia。该数据集是用于训练GPT-2-small模型的训练数据集,并且在Huggingface平台上可用。数据集的许可与WMT新闻数据集相同,因为这是构建该训练数据集的两个数据集中限制较多的许可。
提供机构:
Ti-Ma原始信息汇总
数据集概述
数据来源
- 数据集由WMT News数据集(https://data.statmt.org/news-crawl/en/)和Wikipedia的历史数据构成,截止日期为2018年12月31日。
数据用途
- 该数据集是为训练基于GPT-2-small模型的训练数据集,可在Huggingface上获取,链接为:"TiMa/TiMaGPT2-2018"。
许可证
- 数据集遵循与WMT News数据集相同的许可证(https://data.statmt.org/news-crawl/README),该许可证为构成此训练数据集的所有数据源中较为严格的许可证。
引用要求
- 在使用此数据集进行任何下游应用时,请引用以下论文:
- 标题:Time Machine GPT
- 作者:Drinkall, Felix and Zohren, Stefan and Pierrehumbert, Janet
- 出版信息:Findings of the Association for Computational Linguistics: NAACL 2024, June 2024, Association for Computational Linguistics
搜集汇总
数据集介绍
构建方式
该数据集基于严格的历史数据截止原则构建,所有数据均采集自2018年12月31日之前的公开资源,主要来源于WMT新闻语料库与维基百科。为确保数据的时间一致性与历史纯净性,构建过程中严格筛选了时间戳信息,剔除了任何超出截止日期的内容。数据集采用了WMT新闻数据集的许可协议,因其在构成该训练数据的多个来源中具有相对严格的授权条款。最终形成的数据集被用于训练基于GPT-2-small架构的语言模型,并在HuggingFace平台上以‘TiMa/TiMaGPT2-2018’标识发布。
特点
该数据集的核心特征在于其严格的时间边界控制,所有语料均锚定于2018年及之前,从而为历史语言模型训练提供了纯净的时间切片。数据来源兼具新闻文本的时效性与百科知识的系统性,覆盖了广泛的社会、科技与文化领域。此外,数据集遵循WMT新闻数据集的许可协议,确保了合规使用的透明度。其规模与结构专为GPT-2-small模型优化,兼顾了训练效率与模型性能,是研究时间约束下语言演化与模型行为的理想基准。
使用方法
使用者可通过HuggingFace平台直接加载该数据集,利用‘datasets’库中的‘load_dataset’函数指定‘Ti-Ma/TiMaGPT2-2018’标识即可获取。加载后,数据以标准格式呈现,适用于文本生成、语言建模等下游任务。建议在使用前阅读随附的论文以了解构建细节与许可条款,并在任何衍生应用中引用相关文献。该数据集可直接作为GPT-2-small模型的训练输入,无需额外预处理,但用户可根据任务需求进行分词或格式调整。
背景与挑战
背景概述
在自然语言处理领域,语言模型的训练数据通常包含未来信息,导致模型在评估历史事件时产生偏差。为探究时间对齐对模型性能的影响,Felix Drinkall、Stefan Zohren与Janet Pierrehumbert于2024年构建了Ti-Ma/TiMaGPT2-2018数据集。该数据集完全基于截至2018年12月31日的历史数据,整合自WMT新闻语料库与维基百科,旨在为基于GPT-2-small架构的Time Machine GPT模型提供纯净的时间受限训练语料。通过严格限定数据的时间边界,该数据集为研究语言模型在时间维度上的泛化能力与因果推理提供了关键基准,推动了时间感知自然语言处理领域的发展。
当前挑战
该数据集面临的核心挑战源于其独特的时间约束设计。首先,在领域问题层面,传统语言模型常因训练数据混入未来信息而高估对历史事件的预测能力,Ti-Ma/TiMaGPT2-2018需解决如何在不依赖未来知识的前提下,使模型准确捕捉语言演化规律与历史语境。其次,在构建过程中,从WMT新闻语料库与维基百科中精确提取并过滤截至2018年的数据,需应对时间戳不完整、跨数据集许可协议冲突(如采用较严格的WMT新闻许可证)等工程难题。此外,确保数据规模足以支撑GPT-2-small训练的同时,避免因时间截断导致主题覆盖不足,也是平衡历史完整性与模型性能的重要挑战。
常用场景
经典使用场景
Ti-Ma/TiMaGPT2-2018数据集在自然语言处理领域中,经典使用场景集中于预训练语言模型的时间感知能力增强。该数据集以2018年12月31日为严格截断日期,整合了WMT新闻语料与维基百科的纯历史文本,构建了一个无未来信息污染的训练语料库。研究者常利用其时间对齐特性,训练如GPT-2-small等自回归模型,以探究模型在时间序列上的知识边界与语言演化规律。通过在此数据集上微调,模型能够捕捉特定历史时期的事件脉络与语义变迁,从而提升下游任务中的时间敏感推理能力。
衍生相关工作
基于Ti-Ma/TiMaGPT2-2018数据集,衍生了一系列聚焦于时间感知语言模型的前沿工作。其中,Time Machine GPT(TiMaGPT)作为直接产物,提出了时间对齐训练框架,并被后续研究扩展至多语言与跨领域场景。相关工作包括时间条件生成模型,通过显式编码时间戳提升文本生成的历史一致性;以及时间知识蒸馏方法,利用历史数据训练轻量级模型以适配实时应用。此外,该数据集还催生了时间偏差检测工具的开发,用于评估大语言模型在时间维度上的知识分布,推动了可信AI与模型可解释性领域的进展。
数据集最近研究
最新研究方向
TiMaGPT2-2018数据集聚焦于时间戳约束下的语言模型训练,其核心价值在于利用截至2018年底的静态历史数据,为探索语言模型的时间敏感性提供了独特基准。在当前大语言模型快速迭代的背景下,该数据集与“时间机器”研究范式紧密关联,致力于解决模型对时序信息遗忘与泛化能力的矛盾。通过限定训练数据的时间窗口,研究者可系统评估模型在知识截止日期后的表现退化,进而推动时间感知型语言模型的发展。这一方向对理解模型的知识固化机制、构建具备动态知识更新能力的系统具有重要意义,尤其在新闻生成、历史文本分析等需要严格时间对齐的任务中,TiMaGPT2-2018为评估模型的时空一致性提供了关键支撑。
以上内容由遇见数据集搜集并总结生成


