
MM-Hallu/HaELM
收藏官方服务:
资源简介:
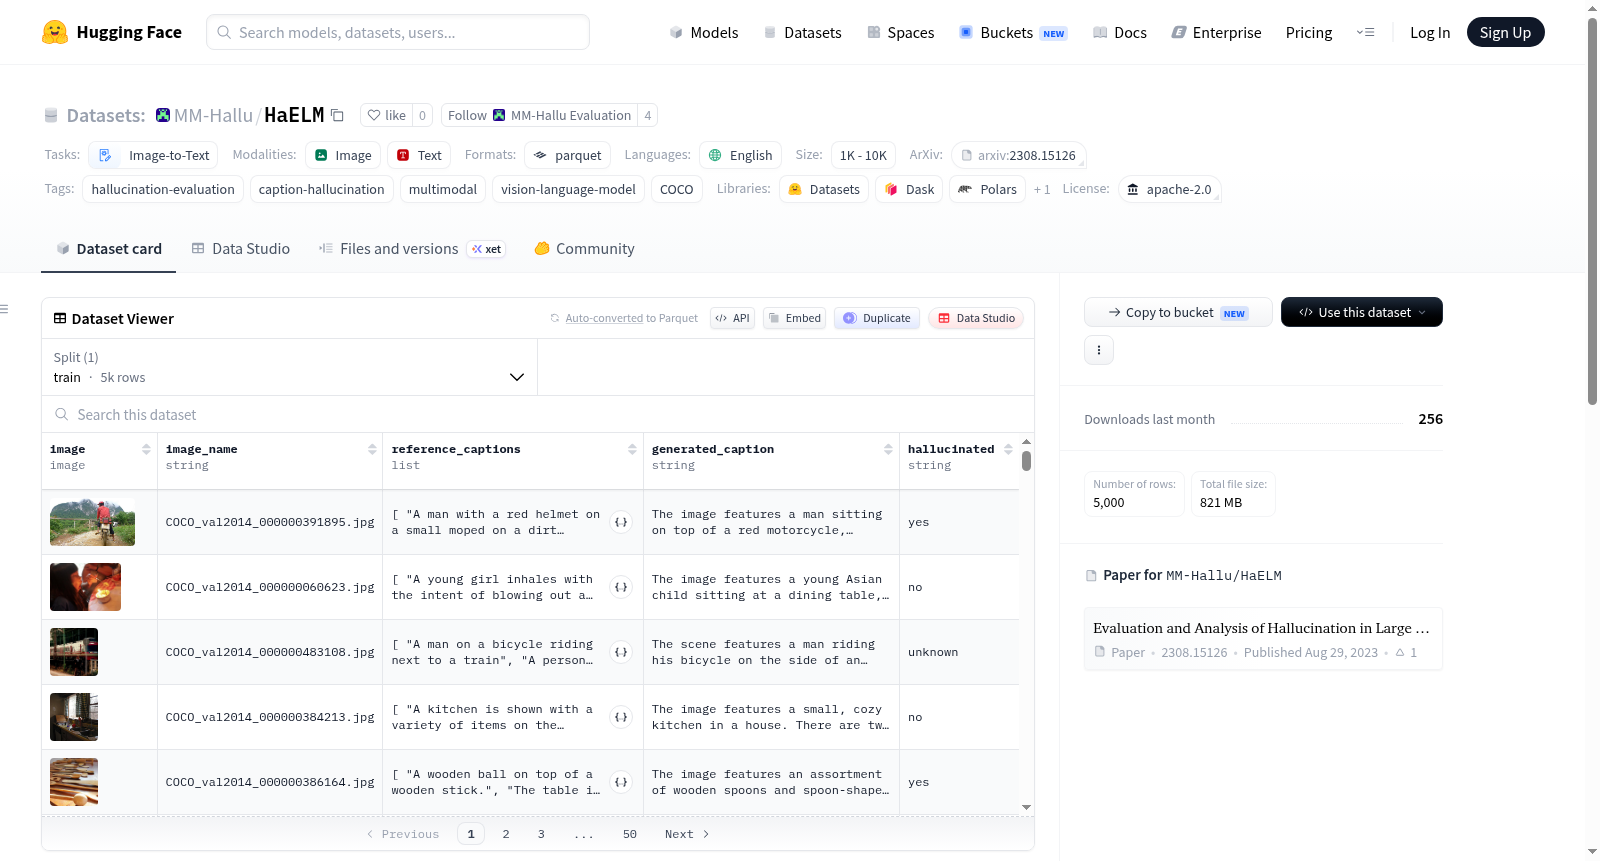
HaELM数据集包含5,000个来自COCO val2014的图像-描述对,用于评估视觉语言模型(VLM)图像描述中的幻觉现象。每个图像有2-5个人工编写的参考描述和一个由MLLM(mPLUG-Owl)生成的描述,用于比较幻觉现象。数据集的特征包括图像、图像名称、参考描述、生成的描述和幻觉标签(yes表示准确,no表示幻觉,unknown表示未知)。数据集的评估指标包括描述幻觉率和准确率。数据来源于HaELM(arXiv 2023)。
HaELM dataset contains 5,000 image-caption pairs from COCO val2014 for evaluating hallucination in VLM image descriptions. Each image has 2-5 human-written reference captions and an MLLM (mPLUG-Owl) generated caption for hallucination comparison. The dataset features include image, image name, reference captions, generated caption, and hallucination label (yes for accurate, no for hallucinated, or unknown). Evaluation metrics include caption hallucination rate and accuracy. The data is sourced from HaELM (arXiv 2023).
提供机构:
MM-Hallu搜集汇总
数据集介绍
构建方式
HaELM数据集源自COCO val2014子集,精心筛选了5,000对图像与描述文本。每幅图像均配备了2至5条由人工撰写的高质量参考描述,同时采用mPLUG-Owl多模态大语言模型生成对应的机器描述,构建形成涵盖准确性、幻觉与未知标签的对比评估基础。
使用方法
使用者可通过Hugging Face Datasets库加载HaELM,访问默认配置下的训练分片。数据包含图像、文件名、参考与生成描述及幻觉标签,便于进行描述准确率与幻觉率的定量计算,也可将生成描述与人工参考进行对比,评测并改进视觉语言模型的输出质量。
背景与挑战
背景概述
HaELM数据集由研究者于2023年基于arXiv论文构建,旨在系统评估多模态大语言模型(MLLM)在图像描述任务中的幻觉现象。随着视觉语言模型(如mPLUG-Owl)的快速发展,模型生成的描述与真实图像内容之间的偏差——即语言幻觉——成为制约模型可靠性的核心问题。该数据集从COCO val2014中精选5000张图像,每张图像配有多个人工撰写的参考描述与模型生成描述,通过对比标注来量化幻觉率。其提出为幻觉检测提供了标准化基准,推动了视觉语言模型可信度研究的发展。
当前挑战
HaELM数据集面临的主要挑战包括:其一,领域层面需解决MLLM生成描述中对象属性、空间关系及存在性等幻觉问题,例如模型误将不存在的物体编入描述;其二,数据构建中需处理标注歧义性,如参考描述间的语义差异导致幻觉标签判定困难,以及‘unknown’类别对模糊案例的覆盖不充分;其三,5000样本规模限制了幻觉模式的多样性覆盖,难以泛化至长尾场景或复杂推理任务。此外,标签依赖人工与自动对比的混合策略可能引入主观偏差,影响评估客观性。
常用场景
经典使用场景
在视觉语言模型(VLM)蓬勃发展的时代,生成式多模态模型虽能产出流畅的图像描述,却时常陷入‘幻觉’困境——描述中出现图像中并不存在的对象或属性。HaELM数据集正是为精准量化这一顽疾而量身打造。它基于经典的COCO val2014数据集,精心筛选出5,000张图像,每张图像配有2-5条人工撰写的参考描述作为金标准,同时引入mPLUG-Owl模型生成的自动描述。通过比对生成描述与人工描述之间的语义吻合度,研究人员可以系统评估VLM是否存在‘胡说八道’的倾向。该数据集最经典的使用场景,便是作为衡量模型描述真实性与准确性的标准化测试集,为视觉语言模型在物体识别、属性判定等具体维度上的幻觉发生率提供可靠且可复现的评估基准。
解决学术问题
视觉语言模型中的幻觉问题一直是制约其可信落地的核心学术瓶颈。传统评价指标如CIDEr或BLEU虽能反映语义相关性,却无法区分描述中的信息是完全杜撰还是合理推断。HaELM数据集通过构建‘人工参考-模型生成’的对比框架,将研究问题转化为可计算的二分类任务,精准区分准确描述与幻觉描述。该数据集解决了三个关键学术难题:一是缺乏标准化的幻觉检测基准,导致不同论文的评估结果难以横向比较;二是缺乏细粒度的幻觉类型标注,致使研究者难以定位模型犯错的具体模态——是物体误判还是空间关系混淆;三是缺乏开放环境下的鲁棒性评估数据,HaELM基于自然场景的COCO图像,有效模拟了真实应用中的多样性。这一数据集的发布,推动了多模态模型从‘唯流畅论’向‘唯真实论’的研究范式转变,为设计去幻觉训练策略与校准算法提供了不可或缺的评估工具。
实际应用
在实际产业应用中,视觉语言模型的描述幻觉可能引发严重的安全隐患,例如在智能辅助驾驶系统中,模型若有路况描述的虚假信息,将直接危及驾驶安全。HaELM数据集在落地场景中扮演着‘质量监察员’的角色。智能医疗影像报告生成模型可以借助HaELM的评估框架,检测报告中是否虚构了病灶或异常结构,从而提升诊断描述的可靠性。电商领域的商品图自动描述系统亦可通过HaELM类似的评估逻辑,确保生成文案不出现商品属性张冠李戴的误读。此外,面向视障人士的辅助视觉叙述设备,更需要依赖高保真度的场景描述,HaELM提供的方法论能够有效筛选出幻觉率低于阈值的模型,从源头保障用户体验。新闻媒体或社交平台在利用VLM生成带文本的图像摘要时,也可部署HaELM风格的监控模块,实时拦截包含虚构事实的描述,维护信息的真实性与公信力。可以说,每一个需要‘看见并说出真相’的AI场景,都能从HaELM的数据设计理念中汲取评估智慧。
数据集最近研究
最新研究方向
HaELM数据集聚焦于多模态大语言模型(MLLM)在图像描述任务中的幻觉现象评估。其精心构建的5000对COCO图像与文本样本,每张图像均配备人工参考描述与mPLUG-Owl模型生成描述,并通过二元标签(准确/幻觉/未知)量化输出偏差。这一设计呼应了视觉语言领域对模型鲁棒性日益增长的关切,尤其在自动驾驶、医疗影像分析等高风险场景中,模型生成的虚构内容可能引发严重决策失误。HaELM通过系统化标注幻觉样本,推动了去幻觉微调策略与评估指标的发展,例如基于对比学习的幻觉抑制方法,为构建可信赖的视觉语言系统提供了关键基准资源,直接关联当前多模态模型安全性与可解释性的前沿探索。
以上内容由遇见数据集搜集并总结生成


