electricsheepafrica/africa-traditional-medicine-safety
收藏资源简介:
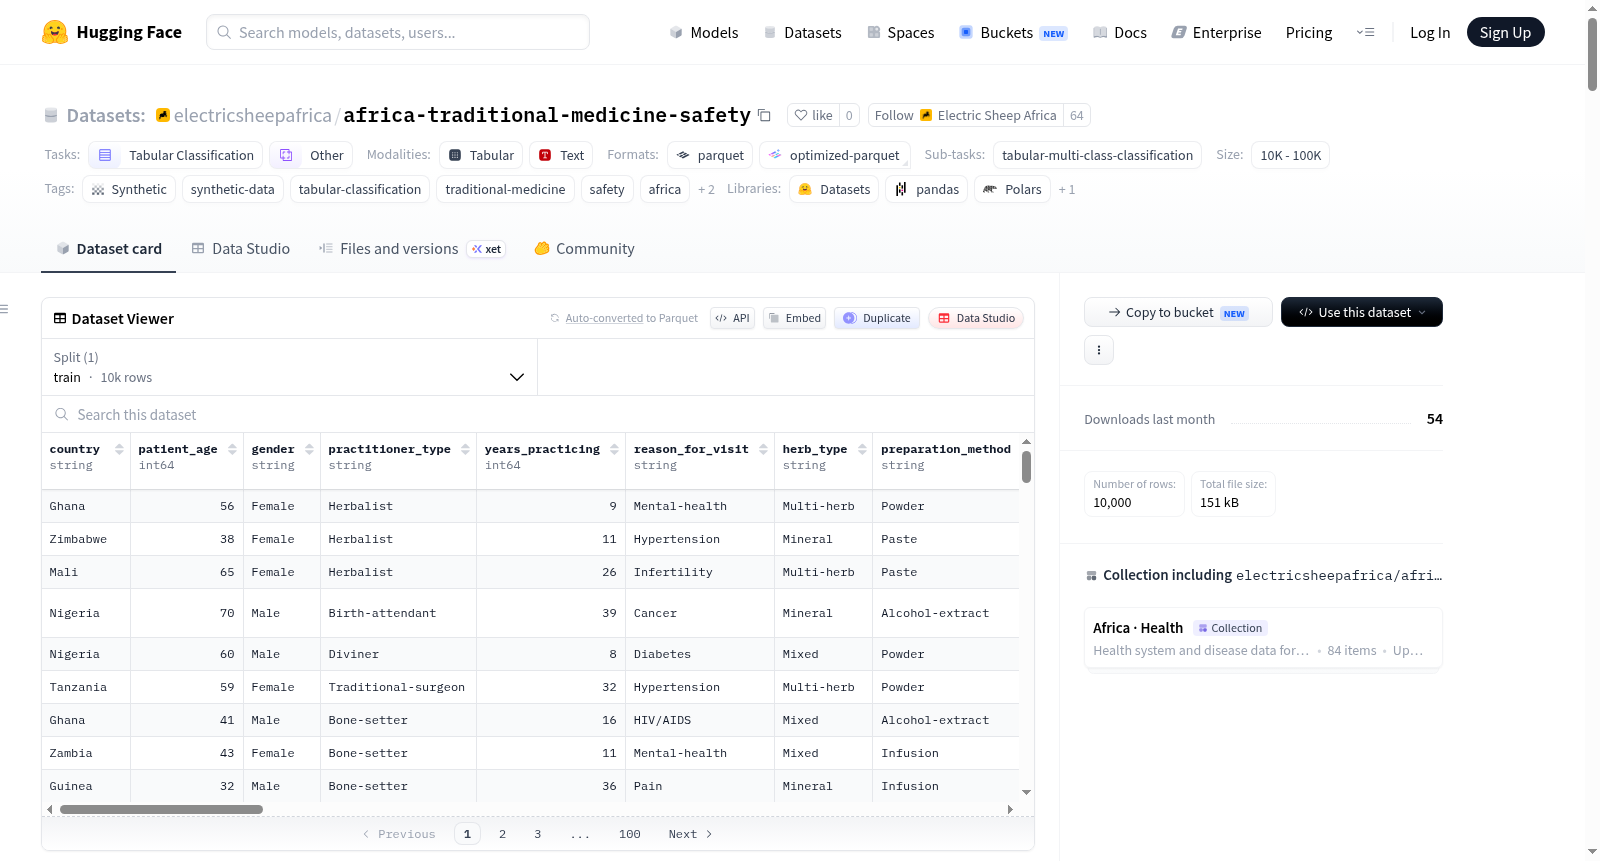
这是一个合成表格数据集,专注于非洲人口中传统医学和补充医学的安全性。它模拟了非洲大陆上最广泛使用的医疗系统中的安全风险。数据集包含10,000行数据,完美平衡了正例(标签=1,表示不良事件)和对照例(标签=0,表示安全),覆盖20个国家,时间跨度为2019年至2024年。特征包括40多个原始和工程化列,如国家、患者年龄、性别、从业者类型、草药类型、给药途径、不良事件严重性等,无缺失值。数据集旨在解决非洲传统医学安全数据缺乏的问题,支持不良事件预测、草药-药物相互作用建模、从业者风险分析等应用,并包含伦理和数据治理考虑。
tags: - 合成数据(synthetic) - 合成数据集(synthetic-data) - 表格分类(tabular-classification) - 传统医学(traditional-medicine) - 安全(safety) - 非洲(africa) - 医疗保健(healthcare) - 药物警戒(pharmacovigilance) task_categories: - 表格分类(tabular-classification) - 其他(other) task_ids: - 表格多分类(tabular-multi-class-classification) language: [] pretty_name: 传统医学安全数据集(Traditional Medicine Safety Dataset) size_categories: - 10000条<样本数<100000条 # 传统医学安全数据集(Traditional Medicine Safety Dataset) ## 数据集描述 本数据集为面向非洲人群的传统与补充医学安全的合成表格数据集,旨在模拟非洲大陆最普及的医疗体系中的安全风险场景。 ## 数据集统计信息 | 指标 | 数值 | |----------|-------| | 总记录数 | 10,000 | | 阳性样本(标签=1) | 5,000 | | 对照样本(标签=0) | 5,000 | | 覆盖国家 | 20个 | | 时间跨度 | 2019–2024年 | | 特征数(原始+工程化特征) | 40+ | | 缺失值占比 | 0%(完全合成的数据集) | | 数据格式 | 表格型CSV | | 随机种子 | 42 | ## 类别平衡与分布 本数据集采用完美的50/50类别平衡,以避免下游模型出现类别不平衡偏差。国家采样遵循反映非洲人口与疾病负担分布的流行病学权重。所有类别特征均保留为字符串标签,以提升可解释性。 ## 研究空白 非洲80%的人口使用传统医学,但目前几乎不存在结构化的安全数据集。草药与西药相互作用、肝毒性、从业者监管、剂量标准化以及儿科用药脆弱性等领域的相关记录均严重不足。 ## 非洲医疗体系背景 - 80%的人口将传统医学作为初级医疗手段 - 不足10%的传统医疗从业者已完成注册 - 肝毒性是急性肝衰竭的主要诱因之一 - 除南非、加纳、尼日利亚外,多数地区缺乏传统医学整合政策 - 生物勘探相关顾虑为研究带来额外复杂性 ## 信息来源 | 来源 | 网址 | |--------|-----| | 世界卫生组织传统医学战略(WHO TM Strategy) | https://www.who.int/publications/i/item/9789240033895 | | 非洲联盟(African Union) | https://au.int/ | | 南非传统医学中心(SA TMC) | https://tmc.co.za/ | | 尼日利亚国家传统与补充医学发展局(NMEDA Nigeria) | https://nmeda.gov.ng/ | ## 字段说明 | 字段名 | 数据类型 | 描述 | |--------|------|-------------| | country | string | 国家 | | patient_age | int | 患者年龄 | | gender | string | 性别 | | practitioner_type | string | 从业者类型 | | years_practicing | int | 从业年限 | | reason_for_visit | string | 就诊原因 | | herb_type | string | 草药类型 | | preparation_method | string | 炮制方法 | | administration_route | string | 给药途径 | | dosage_known | int | 是否知晓剂量 | | frequency_daily | int | 每日用药频率 | | duration_weeks | int | 用药时长(周) | | concurrent_western_meds | string | 合并使用的西药 | | disclosure_to_doctor | int | 是否向医师告知用药情况 | | adverse_event | string | 不良事件 | | severity | string | 严重程度 | | time_to_onset_days | int | 不良事件发作时间(天) | | outcome | string | 事件结局 | | hospitalisation_required | int | 是否需要住院 | | previous_adverse_events | int | 既往不良事件史 | | registration_status | int | 从业者注册状态 | | quality_control | int | 质量控制 | | label | int | 1=发生不良事件,0=用药安全 | ## 工程化特征 | 特征名 | 描述 | |---------|-------------| | practitioner_experience_score | 从业年限 + 注册状态 + 质量控制得分的综合评分 | | herb_risk_score | 炮制方法 + 给药途径 + 剂量知晓情况 + 用药频率的综合风险评分 | | concurrent_med_risk | 合并用药的相互作用严重程度 | | care_integration_score | 医师告知情况与用药风险的综合评分 | | patient_vulnerability | 患者年龄 + 既往不良事件史的综合脆弱性评分 | | event_severity_score | 加权后的事件严重程度评分 | | high_risk_traditional | 高风险传统用药复合标记 | ## 特征工程方法 复合评分基于文献与临床指南推导的领域专属权重构建,所有评分均保留两位小数以确保可复现性。原始字段保留了各组成部分的贡献值,方便研究人员重构或修改复合评分。 **高风险标记**为二元指示变量,当多个风险维度同时超出阈值时触发。该设计优先保证灵敏度(捕获绝大多数高风险案例)而非绝对特异性,因此适用于分诊与筛查场景。 ## 特征重要性说明 基于初步随机森林(Random Forest)分析结果: - 复合风险评分通常位列前5个最重要的特征 - 国家指示变量可提供较强的地理分布信号 - 时间特征(年份、季节)可捕捉长期趋势 - 基础设施与患者层面变量间的交互效应具有统计学显著性 - 请始终在留出的测试集上验证特征重要性,以避免数据泄露(leakage) ## 支持的应用场景 - 不良事件预测 - 草药与西药相互作用建模 - 从业者风险画像 - 质量控制基准测试 - 医疗整合政策设计 - 儿科用药安全研究 - 监管效果评估 ## 高级建模方法 - **生存分析(Survival analysis)**:针对存在时间-to-事件结局的数据集,可使用Cox比例风险模型构建风险轨迹 - **多任务学习(Multi-task learning)**:联合预测标签与中间结局(如并发症类型、严重程度分级) - **代价敏感学习(Cost-sensitive learning)**:在筛查场景中,为假阴性赋予高于假阳性的权重 - **不确定性量化(Uncertainty quantification)**:使用共形预测或贝叶斯方法标记低置信度预测结果,供人工复核 - **因果推断(Causal inference)**:基于机构类型或国家进行倾向得分匹配,以估算干预效应 - **联邦学习(Federated learning)**:无需集中化数据,即可在模拟的医院节点间训练模型 - **可解释AI(Explainable AI)**:通过SHAP与LIME值帮助临床医师理解模型驱动的风险评分 ## 使用示例 python from datasets import load_dataset dataset = load_dataset("electricsheepafrica/africa-traditional-medicine-safety", split="train") df = dataset.to_pandas() python import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier from sklearn.metrics import classification_report, roc_auc_score df = pd.read_csv("data/processed/traditional_features.csv") X = df.select_dtypes(include=["int", "float"]).drop(columns=["label"]) y = df["label"] X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, stratify=y, random_state=42) clf = RandomForestClassifier(random_state=42) clf.fit(X_train, y_train) print(classification_report(y_test, clf.predict(X_test))) print("ROC-AUC:", roc_auc_score(y_test, clf.predict_proba(X_test)[:, 1])) ## 数据生成流程 1. 阳性样本:包含不良事件与高风险用药场景 2. 对照样本:包含安全用药与明确剂量的场景 3. 过滤泄露样本:移除临床中会被归类为阳性的对照样本 4. 平衡样本量:5000个阳性样本 + 5000个对照样本 5. 生成从业经验、用药风险与患者脆弱性特征 6. 使用随机种子42生成数据 ## 预处理建议 1. **独热编码(One-hot encode)**:针对类别型字段(国家、机构类型、地区等) 2. **标准化(Standardise)**:对连续特征使用Z-score或MinMax归一化,适配基于距离的模型 3. **分层拆分(Stratify)**:按国家进行分层拆分,以保证地理分布代表性 4. **采样策略**:若需子采样,可使用SMOTE或类别加权;本数据集已天然平衡 5. **交叉验证**:使用按国家分组的5折分层交叉验证,以检测针对特定国家的过拟合 6. **特征选择**:工程化复合评分具有较高信息价值,可与原始特征对比评估 7. **数据泄露检查**:确保从标签衍生的字段(如事件结局、诊断分期)未被纳入特征集 ## 基线性能预期 | 模型 | 预期准确率 | 预期ROC-AUC值 | 说明 | |-------|------------------|------------------|-------| | 逻辑回归(Logistic Regression) | 0.72–0.78 | 0.78–0.84 | 可解释性优异的基线模型 | | 随机森林(Random Forest) | 0.82–0.88 | 0.88–0.93 | 可较好处理非线性交互效应 | | XGBoost / LightGBM | 0.85–0.91 | 0.91–0.95 | 表格数据建模的最优表现 | | 神经网络(MLP) | 0.80–0.86 | 0.85–0.90 | 需要特征标准化,存在过拟合风险 | | 线性支持向量机(Linear SVM) | 0.74–0.80 | 0.80–0.85 | 对特征缩放敏感 | 以上为分层80/20训练测试拆分下的近似性能范围,实际结果可能因特征工程与超参数调优有所差异。 ## 统计属性 - **阳性样本**:从高风险临床特征分布中采样,且有意保留一定重叠以反映真实世界的异质性 - **对照样本**:从低风险特征分布中采样,但保留合理的方差;约10%的对照样本可能存在轻微风险指标 - **泄露过滤**:移除临床中会被归类为阳性的对照样本,以保证类别间的清晰分离 - **国家权重**:基于世界卫生组织/联合国儿童基金会的疾病负担估算与人口规模推导 - **相关结构**:工程化特征与原始临床指标存在有意设置的相关性;在线性模型中需避免重复计数 - **噪声注入**:连续变量加入均匀分布噪声,以避免模型过拟合合成的精确阈值 - **时间一致性**:年份、季节与天气异常值均为连贯生成(如干旱月份与作物减产存在对应关联) ## 验证清单 在将本数据集用于研究或生产前,请完成以下检查: - [ ] 验证训练/测试拆分中的类别平衡情况 - [ ] 检查工程化特征与标签间是否存在意外相关性 - [ ] 验证高风险标记在极端场景下的行为是否符合预期 - [ ] 确认国家分层不会导致模型被特定国家的特征主导而产生虚假偏差 - [ ] 通过完全留出一个或多个国家的方式测试模型泛化能力 ## 局限性 - 合成数据集 - 草药分类较为简化 - 仅支持二元结局预测 ## 伦理考量 - 尊重传统知识体系 - 避免污名化传统医疗从业者或使用者 - 支持传统医学与现代医疗的整合 - 遵循社区知情同意原则 - 保护从业者身份信息 ## 数据治理与保护 - **匿名化处理**:所有记录均为合成生成,不包含任何真实患者、家庭或机构标识符 - **合成数据验证**:部署前需验证合成分布是否与目标国家的真实监测数据匹配 - **社区参与**:部署预测工具前,需咨询当地卫生部门与社区群体 - **算法公平性**:审计模型在不同国家、性别与社会经济阶层间的性能差异 - **解释权保障**:当用于临床或政策决策时,需提供可解释的模型输出 - **数据留存**:后续收集的任何真实数据需遵循机构与国家的数据保护政策 - **利益共享**:确保参与或被纳入数据集的社区可从相关工具与研究成果中获益 - **开放科学**:在同行评审的研究成果中公开方法学、代码与模型卡片 ## 推荐数据拆分 - 训练集:70% - 验证集:15% - 测试集:15% ## 引用格式 bibtex @dataset{traditional_medicine_africa_2024, title = {Traditional Medicine Safety Dataset}, author = {Electric Sheep Africa}, year = {2024}, url = {https://huggingface.co/datasets/electricsheepafrica/africa-traditional-medicine-safety} } ## 许可证 CC BY-SA 4.0 ## 联系方式 electricsheepafrica@proton.me ## 版本历史 - v1.0 — 初始发布