
David-Xu/astronomy-stack-dpo-text
收藏官方服务:
资源简介:
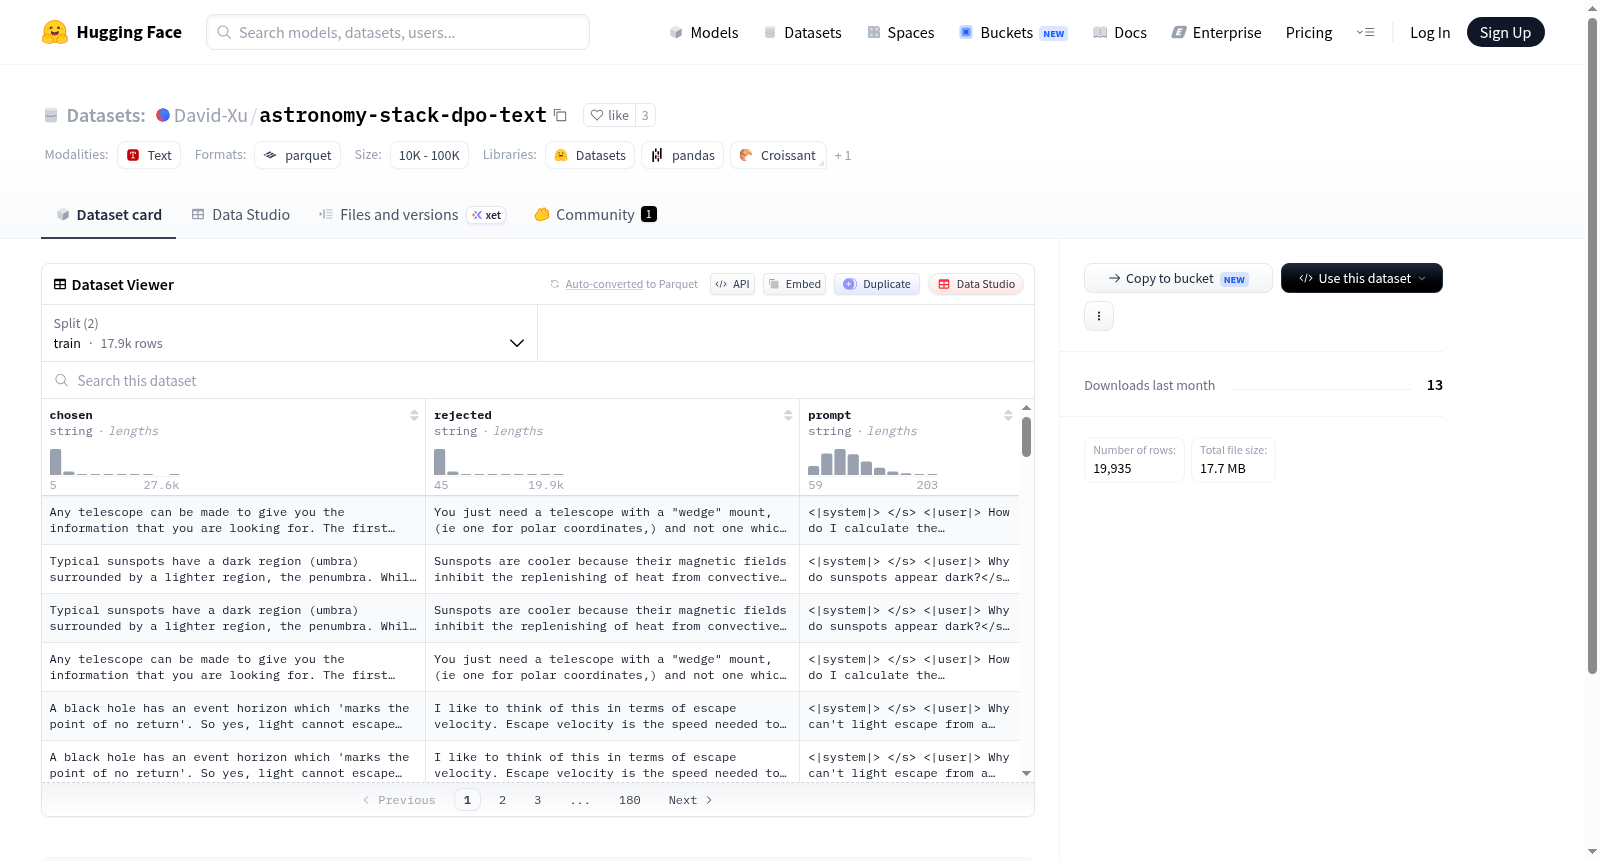
--- dataset_info: features: - name: chosen dtype: string - name: rejected dtype: string - name: prompt dtype: string splits: - name: train num_bytes: 53775582 num_examples: 17942 - name: test num_bytes: 6055646 num_examples: 1993 download_size: 17732927 dataset_size: 59831228 configs: - config_name: default data_files: - split: train path: data/train-* - split: test path: data/test-* ---
数据集信息: 特征项: - 字段名:chosen(优选响应),数据类型:字符串(string) - 字段名:rejected(弃选响应),数据类型:字符串(string) - 字段名:prompt(提示词),数据类型:字符串(string) 数据集划分: - 划分名称:train(训练集),字节数:53775582,样本数量:17942 - 划分名称:test(测试集),字节数:6055646,样本数量:1993 下载总大小:17732927 数据集总大小:59831228 配置项: - 配置名称:default(默认配置),数据文件: - 划分train对应路径:data/train-* - 划分test对应路径:data/test-*
提供机构:
David-Xu原始信息汇总
数据集概述
数据集特征
- chosen:数据类型为字符串。
- rejected:数据类型为字符串。
- prompt:数据类型为字符串。
数据集分割
- 训练集:包含17942个样本,总大小为53775582字节。
- 测试集:包含1993个样本,总大小为6055646字节。
数据集大小
- 下载大小:17732927字节。
- 数据集总大小:59831228字节。
配置信息
- 默认配置:
- 训练数据路径:
data/train-* - 测试数据路径:
data/test-*
- 训练数据路径:
搜集汇总
数据集介绍
构建方式
在天文学领域,大语言模型的指令微调与偏好对齐依赖于高质量、领域特化的数据集。David-Xu/astronomy-stack-dpo-text 数据集正是为满足这一需求而构建,它采用DPO(Direct Preference Optimization)范式,聚焦于天文学文本的偏好学习。该数据集包含三个核心字段:prompt(提示)、chosen(优选回答)和rejected(次选回答),每个样本通过对比一对回答来编码领域内的偏好信号。数据划分为训练集(17942条)和测试集(1993条),以支持模型的训练与评估。
特点
该数据集的特点在于其领域专精与结构设计的巧妙结合。它完全面向天文学文本,覆盖从基础概念到前沿发现的广泛主题,确保模型能学习到该领域的专业表达与知识偏好。通过显式区分chosen与rejected回答,数据集为偏好对齐提供了清晰的监督信号,避免了传统二元标签的模糊性。此外,数据集规模适中(训练集约1.8万条),平衡了数据多样性与计算效率,适合用于微调中等规模的语言模型。
使用方法
使用该数据集时,研究人员可直接加载Hugging Face上的默认配置,自动获取训练集与测试集。典型流程包括:首先利用prompt字段作为输入,chosen与rejected字段构建对比学习目标,通过DPO损失函数优化模型,使其生成更接近chosen风格的输出。数据集以标准文本格式存储,易于与Transformers、TRL等框架集成。建议在微调前对样本进行领域词汇检查,并利用测试集评估模型在天文学文本生成任务上的偏好对齐效果。
背景与挑战
背景概述
在天文学研究迈入大数据时代的背景下,海量观测数据与文本资料的涌现对自然语言处理技术提出了更高要求。David-Xu/astronomy-stack-dpo-text数据集由研究人员于近期构建,旨在通过偏好对齐技术提升天文领域语言模型的指令遵循能力。该数据集聚焦于天文学问答场景,包含约1.8万条训练样本和近2000条测试样本,每条数据由提示词、优选回答与次优回答构成,为强化学习中的直接偏好优化(DPO)方法提供了基础资源。其核心研究问题在于如何利用对比性文本对,引导模型在天文学专业语境中生成更准确、更符合领域规范的回复,从而推动科学文献理解与智能问答系统的发展。
当前挑战
该数据集面临的核心挑战之一在于天文领域专业知识的稀疏性与术语复杂性,导致模型在区分优选与次优回答时易受噪声干扰,需依赖精细的标注策略以提升偏好信号的信噪比。构建过程中,获取高质量的天文学问答对尤为困难,需要领域专家参与筛选与校对,以确保chosen与rejected样本在事实准确性、逻辑连贯性及表述规范性上具有显著差异。此外,数据规模相对有限,可能限制模型对罕见天文现象或前沿课题的泛化能力,未来需探索数据增强与迁移学习策略以缓解这一瓶颈。
常用场景
经典使用场景
在天文学与自然语言处理的交叉领域中,David-Xu/astronomy-stack-dpo-text数据集为基于人类偏好对齐的文本生成模型提供了宝贵的训练资源。该数据集源自天文学领域的问答社区,通过精心构建的‘chosen’与‘rejected’对比对,以及原始‘prompt’提示,使得研究者能够利用直接偏好优化(DPO)方法微调大型语言模型。其经典使用场景聚焦于提升模型在天文学知识问答、科普解释及复杂概念阐述时的回答质量,确保输出内容既准确又符合领域专家的偏好标准。
衍生相关工作
围绕astronomy-stack-dpo-text数据集,学界已衍生出多项经典工作。部分研究将其作为基准,对比不同偏好对齐方法(如RLHF与DPO)在科学领域的效果差异;另一些工作则在此基础上扩展,构建了多模态天文学数据集,融合图像与文本偏好信息。此外,该数据集还启发了针对低资源科学子领域的微调策略探索,如通过迁移学习将天文偏好知识迁移至天体化学或行星科学。这些衍生研究共同推进了科学人工智能从通用能力向领域专精的纵深发展。
数据集最近研究
最新研究方向
在天文学数据驱动的知识推理与大语言模型对齐领域,David-Xu/astronomy-stack-dpo-text数据集正成为前沿研究的焦点。该数据集通过偏好优化范式,将天文领域的问答对(chosen与rejected)与提示词(prompt)结构化组合,为训练具备专业鉴别力的天文对话模型提供了关键素材。当前研究方向聚焦于利用直接偏好优化(DPO)算法,使语言模型在生成天文科普或科研解答时,能够自动筛选出更符合天体物理学逻辑的答案,从而提升模型在星体分类、宇宙学参数推断等复杂任务中的可靠性。伴随詹姆斯·韦伯空间望远镜等观测设备带来的数据洪流,该数据集所驱动的对齐技术有望显著增强AI在天文文献挖掘与实时观测辅助中的专业表现,推动人机协作探索宇宙奥秘的新范式。
以上内容由遇见数据集搜集并总结生成


