
anonymous1643/PaSBench-Video
收藏官方服务:
资源简介:
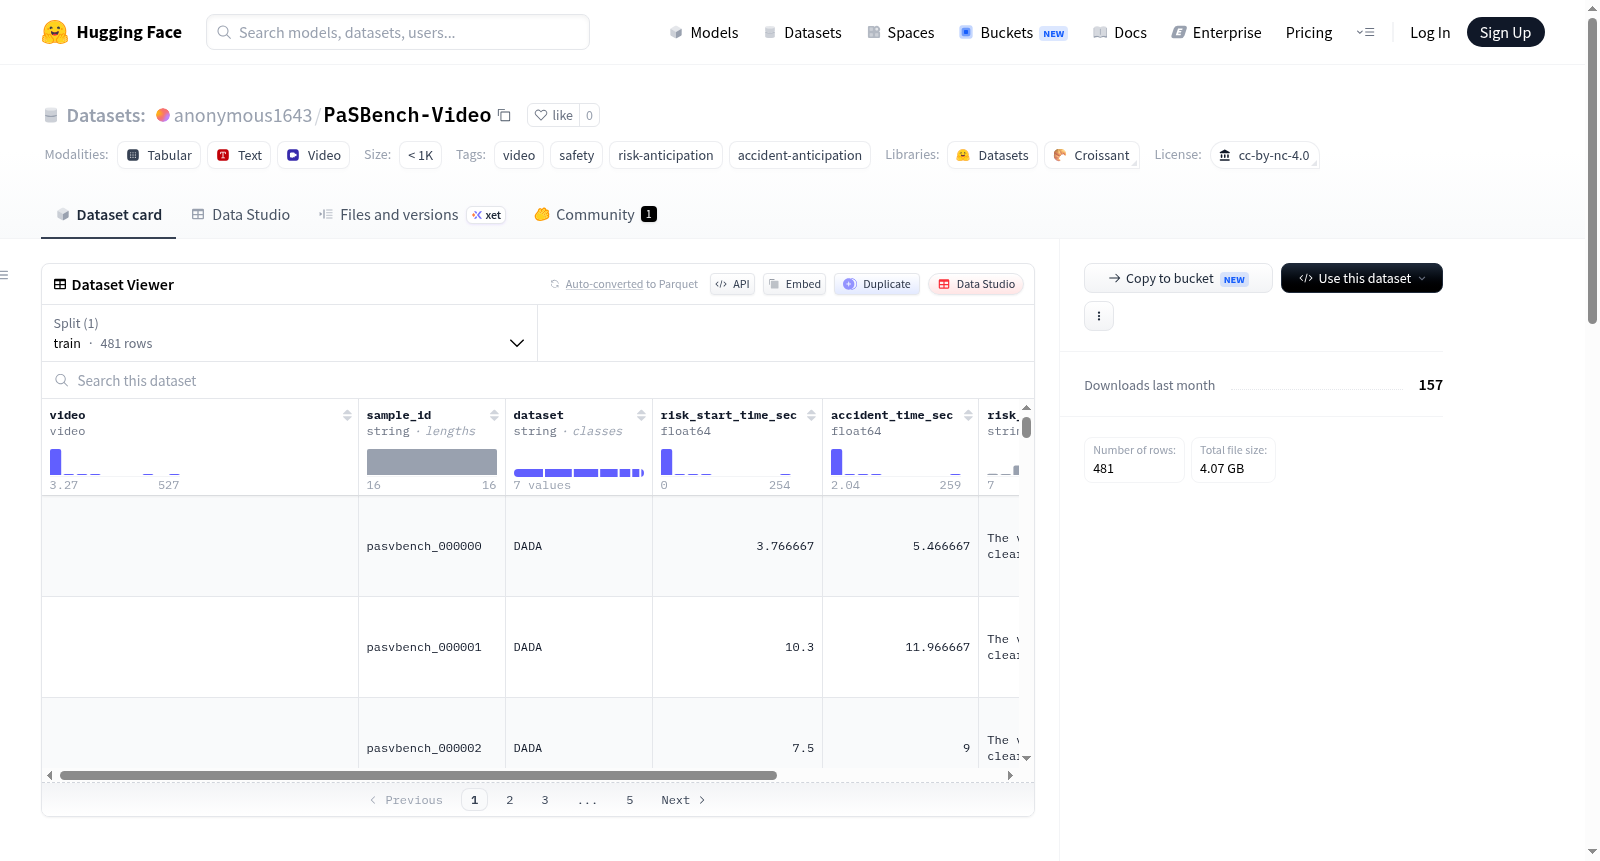
PaSBench-Video 是一个用于主动安全和风险预测的精选视频基准。每个样本将一个视频与帧/时间注释以及经过审查的风险响应提示配对。
PaSBench-Video is a curated video benchmark for proactive safety and risk anticipation. Each sample pairs a video with frame/time annotations and reviewed risk-response prompts.
提供机构:
anonymous1643搜集汇总
数据集介绍
构建方式
PaSBench-Video是一个面向主动安全与风险预判的精选视频基准数据集。其构建过程严格而系统,首先从DADA、healthbench、industry、nexar、oops、radsv、smarthome等多个公开来源中筛选出481个视频片段,随后为每个样本精心标注了风险起始时间(risk_start_time_sec)与事故起始时间(accident_time_sec),并经过人工审核与校正,形成风险原因(risk_reason)与推荐用户行动(recommended_user_action)两项高质量文本描述。最终数据以HuggingFace VideoFolder标准结构组织,包含元数据文件、视频文件及标注JSON,确保清晰可复现。
特点
该数据集最显著的特点在于其主动风险预判的设计取向,而非单纯的事后分析。每个视频样本均包含精确到秒级的风险与事故时间锚点,使模型能够学习从风险萌芽到事件爆发的完整时序链条。此外,风险原因与用户行动推荐文本均经过严格校正,保证了语义的准确性与实用性。数据集涵盖交通、工业、家居等七个典型场景,总规模适中(481个视频),在聚焦风险预判任务的同时兼顾了领域的多样性,为主动安全系统的评估提供了专业标杆。
使用方法
研究者可通过HuggingFace的VideoFolder工具加载数据,首先利用metadata.csv中的file_name字段定位视频文件,再结合risk_start_time_sec与accident_time_sec进行时序标注。在模型训练或评估时,可依据风险原因文本构建风险感知目标,或根据推荐用户行动生成决策指令。数据集支持视频级风险检测、意外预判等多种下游任务,建议采用时序定位模型(如SlowFast或VideoMAE)作为基线,将风险时间戳与文本描述作为监督信号进行联合优化。
背景与挑战
背景概述
随着自动驾驶、智能监控及人机交互等领域的快速发展,视频数据中的风险感知与事故预警能力成为衡量人工智能系统安全性的关键指标。PaSBench-Video数据集应运而生,由相关研究机构于近期构建,旨在填补面向主动安全与风险预判的视频基准测试空白。该数据集汇聚了来自DADA、HealthBench、Nexar等七个不同领域的481个精挑细选的视频样本,每个样本均配有风险起始时间、事故时间及经过审核的风险原因与推荐行动文本,为评估模型在复杂动态场景下的前瞻性安全推理能力提供了标准化测试平台。其发布对推动视频安全理解、风险预警系统及人机协作中的事故防范研究具有重要意义。
当前挑战
PaSBench-Video所面对的领域挑战在于视频理解中主动安全与风险预判任务的复杂性:模型不仅需要识别当前场景中的潜在危险,更需在事故未发生前进行前瞻性推理,这对时序推理与常识理解能力提出极高要求。在数据构建过程中,挑战尤为突出:原始视频来自多个异构源域,标注一致性难以保证,需进行跨域审核与文本校正;风险时间点的标注需兼顾粒度与客观性,不同评审者对手动标注的边界可能存在分歧;此外,从495个初始视频中筛选出481个高质量样本,涉及对低质量、模糊或争议样本的系统性剔除,确保基准的纯净性与可靠性。
常用场景
经典使用场景
PaSBench-Video作为精心筛选的视频基准数据集,其经典使用场景聚焦于视频中的主动安全与风险预判研究。该数据集每个样本都配备了视频、时间标注及经过审核的风险响应提示,为研究者提供了探究动态环境中危险事件萌芽与演进规律的标准平台。通过分析风险起始时间与事故时间的精确标注,该数据集特别适用于训练和评估能够提前感知潜在威胁的智能视频理解模型。
解决学术问题
该数据集系统性地解决了学术界在视频风险预判领域长期面临的标注不一致、场景碎片化以及评估标准缺失等关键问题。通过跨域整合来自驾驶、工业、家庭等七个不同来源的481段视频,PaSBench-Video构建了涵盖多元风险场景的统一基准,使得研究者能够在公平可控的条件下比较不同风险感知算法的性能,其包含的精细时间定位信息更是推动了从简单事故检测向事前风险预判的范式转变。
衍生相关工作
PaSBench-Video的发布催生了一系列围绕主动风险感知与视频时序理解的前沿研究工作。具体而言,研究人员基于该基准开展了风险原因推断与推荐用户动作生成等多模态学习任务,推动了视频内容理解从被动事后分析向主动事前干预能力的跨越。此外,该数据集所倡导的结构化标注范式与跨域评估策略,也深刻影响了后续面向复杂动态场景的视频安全基准建设,成为该领域学术探索的重要基石。
以上内容由遇见数据集搜集并总结生成


