gsm8k-indic-cultural
收藏资源简介:
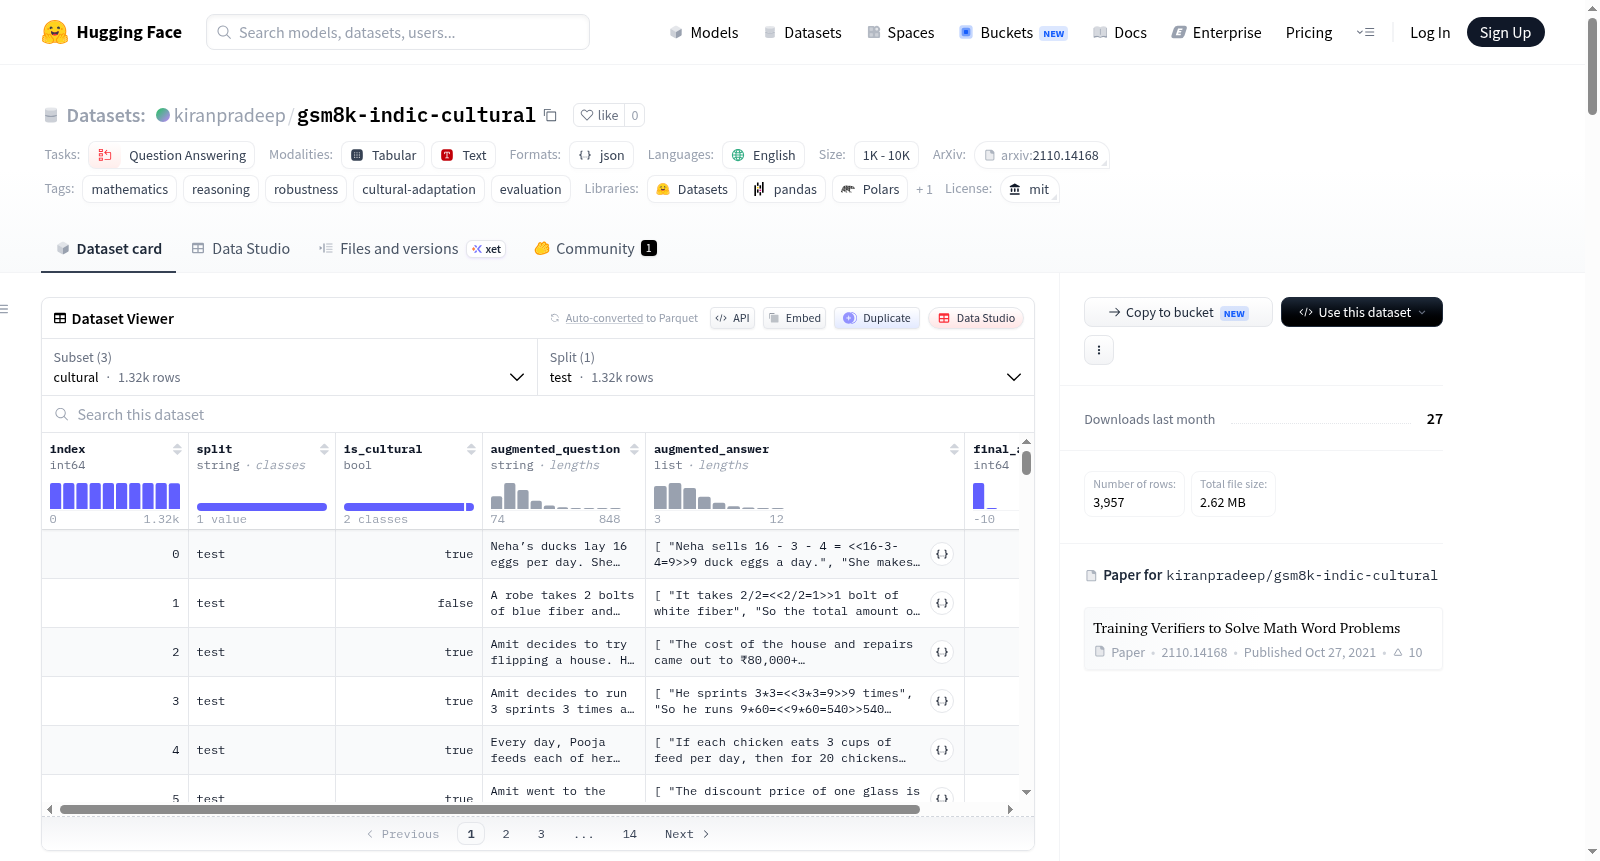
GSM8K Indic Cultural Adaptation 是 GSM8K 测试集的文化本地化版本,旨在评估数学推理模型在文化适应问题表述下的鲁棒性。该数据集保留了原始 GSM8K 基准的数学推理逻辑,同时将问题适配到印度语境。数据集包含三个变体:Cultural + Values(文化实体和数值均进行本地化,重新计算中间推理和最终答案)、Cultural Only(仅更改文化实体,保留原问题和答案)、Values Only(仅转换数值和单位,重新计算答案)。每个变体包含 1319 个样本。数据字段包括:index(对应GSM8K测试样例索引)、split(test)、is_cultural(布尔值,指示是否修改文化实体)、augmented_question(文化适配后的问题)、augmented_answer(步骤推理列表)、final_answer(最终数值答案)。构造过程包括:识别文化特定实体(如人名、食物、职业、地点、货币、单位),替换为印度对应的实体,转换货币(1 USD = 87 INR)和单位,重新计算所有受影响的中间步骤和最终答案。该数据集适用于评估数学推理模型、跨文化鲁棒性、文化本地化推理、公平性与偏见分析。
GSM8K Indic Cultural Adaptation is a culturally localized variant of the GSM8K test set, designed to evaluate the robustness of mathematical reasoning models under culturally adapted problem formulations. This dataset retains the mathematical reasoning logic of the original GSM8K benchmark, while adapting all problems to the Indian context. The dataset includes three variants: 1. Cultural + Values: Both cultural entities and numerical values are localized, with intermediate reasoning steps and final answers recalculated; 2. Cultural Only: Only cultural entities are modified, while the original problem and answer are retained; 3. Values Only: Only numerical values and units are converted, with the final answer recalculated. Each variant contains 1319 samples. The dataset fields are as follows: index (corresponding to the index of GSM8K test examples), split (test), is_cultural (a boolean value indicating whether cultural entities have been modified), augmented_question (the culturally adapted question), augmented_answer (a list of step-by-step reasoning), final_answer (the final numerical answer). The construction process of the dataset includes: identifying culture-specific entities such as personal names, foods, occupations, locations, currencies and units, replacing them with corresponding Indian entities, converting currencies (1 USD = 87 INR) and units, and recalculating all affected intermediate steps and final answers. This dataset is suitable for evaluating mathematical reasoning models, cross-cultural robustness, culturally localized reasoning, fairness and bias analysis.
GSM8K Indic Cultural Adaptation 数据集详情
数据集概览
GSM8K Indic Cultural Adaptation 是 GSM8K 测试集的文化本地化版本,旨在评估数学推理模型在文化适应问题表述下的鲁棒性。数据集保留了原始 GSM8K 基准的数学推理逻辑,同时将问题适配至印度语境,包括替换文化特定实体、转换货币和计量单位,并重新计算所有受影响的计算步骤和最终答案。
- 语言:英语
- 许可证:MIT
- 任务类别:问答
- 来源数据集:GSM8K
- 标签:数学、推理、鲁棒性、文化适应、评估
数据集变体
数据集包含三个互补的变体,每个变体包含 1,319 条样本,均源自 GSM8K 测试集:
| 变体 | 说明 |
|---|---|
Cultural + Values (cultural_values) |
文化实体(如姓名、食物、职业、地点、货币、计量单位)本地化至印度语境,受影响的数值全部重新计算,中间推理步骤和最终答案同步更新 |
Cultural Only (cultural) |
仅修改问题中的文化实体,保留原始叙事和其他上下文信息,中间推理与最终答案保持不变 |
Values Only (values) |
仅转换文化相关的数值(如货币、单位),保留原始叙事和命名实体,推理步骤与最终答案重新计算以保证数学正确性 |
这些变体可实现文化本地化不同方面的受控评估:Cultural Only 隔离文化变化的影响,Values Only 隔离数值和单位变化的影响,Cultural + Values 衡量文化本地化与数值适应的综合效应。
数据集结构
gsm8k-indic-cultural/ ├── README.md └── data/ ├── cultural_values.jsonl ├── cultural.jsonl └── values.jsonl
每个 JSONL 文件每行包含一个 JSON 对象,示例格式如下:
json { "index": 0, "split": "test", "is_cultural": true, "augmented_question": "Rukminis ducks lay 16 eggs per day...", "augmented_answer": [ "Rukmini sells 16 - 3 - 4 = 9 duck eggs a day.", "She makes 9 × 174 = 1566 rupees every day.", "#### 1566" ], "final_answer": 1566 }
数据字段说明
| 字段 | 类型 | 描述 |
|---|---|---|
index |
整数 | 对应 GSM8K 测试样本的索引 |
split |
字符串 | 数据集划分("test") |
is_cultural |
布尔值 | 是否修改了文化实体 |
augmented_question |
字符串 | 文化适配后的问题 |
augmented_answer |
字符串列表 | 对应适配问题的逐步推理 |
final_answer |
浮点数 | 最终数值答案 |
数据集构建方法
数据集通过对 GSM8K 测试集中的每个样本进行文化适配构建,主要步骤包括:
- 识别原始问题中的文化特定实体
- 将其替换为合理的印度对应物
- 转换文化相关的数值
- 重新计算所有受影响的中间计算
- 更新最终标准答案以保证数学正确性
文化适配涵盖个人姓名、食物、职业、地点、货币、计量单位等。货币从 USD 转换为 INR,固定汇率为 1 USD = ₹87;计量单位(如磅转千克)在适当时进行转换,所有下游计算和参考答案均重新计算以保持一致性。
预期用途
该数据集适用于以下研究领域:
- 数学推理模型评估
- 大型语言模型的跨文化鲁棒性
- 文化本地化推理基准测试
- 公平性与偏差分析
- 推理基准的跨文化评估
局限性
- 数据集仅来源于 GSM8K 测试集
- 仅供 评估 使用,不适用于模型训练
- 文化适配特定于印度语境,不代表印度内部所有地区或文化变体
- 已尽力保证数学正确性,但仍鼓励用户报告发现的不一致之处
数据集加载
可使用 Hugging Face datasets 库加载:
python from datasets import load_dataset
cultural_values = load_dataset("kiranpradeep/gsm8k-indic-cultural", "cultural_values") cultural = load_dataset("kiranpradeep/gsm8k-indic-cultural", "cultural") values = load_dataset("kiranpradeep/gsm8k-indic-cultural", "values")
引用
使用该数据集时,请引用:
bibtex @misc{gsm8k_indic_2026, title={GSM8K Indic Cultural Adaptation}, author={Kiran Pradeep, Aditya Tomar, Nihar Ranjan Sahoo, Rudra Murthy}, year={2026}, howpublished={Hugging Face Dataset} }
同时请引用原始 GSM8K 论文。
致谢
该数据集是基于 GSM8K 基准的衍生作品,感谢 GSM8K 作者公开提供原始数据集。使用者还应遵守原始 GSM8K 数据集的许可和引用要求。