
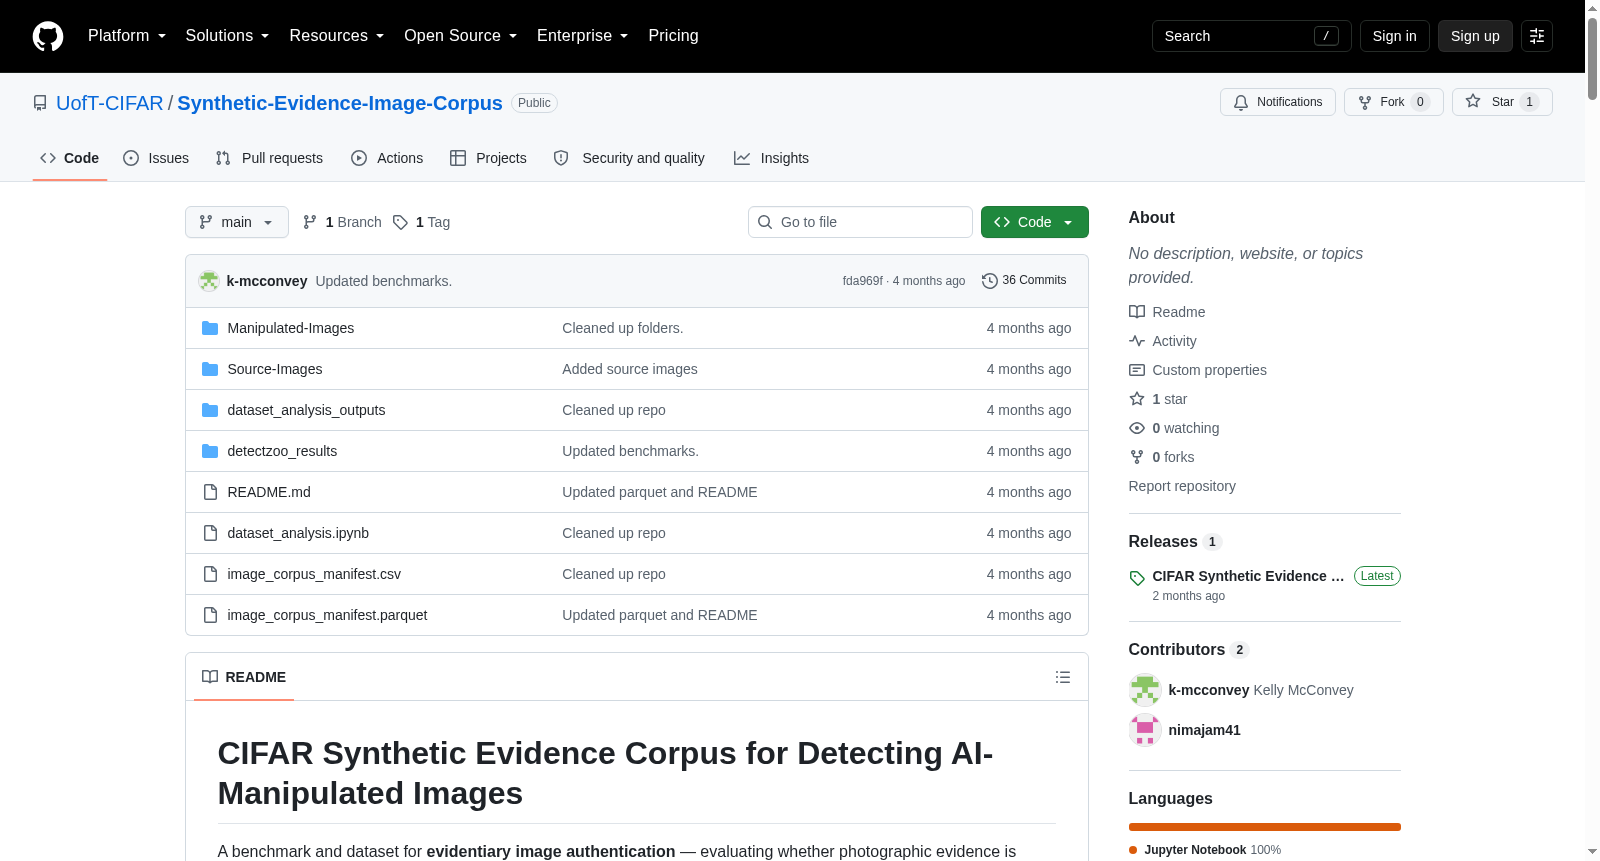
CIFAR Synthetic Evidence Corpus for Detecting AI-Manipulated Images
收藏资源简介:
CIFAR合成证据语料库是由多伦多大学等多所高校联合创建的面向法庭AI操纵视觉证据检测的基准数据集。该数据集包含1,505张照片,包括720张真实图像和785张操纵或合成图像,覆盖监控、行车记录仪和消费级照片三个证据家族。数据集通过三层次操纵分类(场景条件编辑、局部元素编辑和完全合成)模拟非专业用户威胁模型,采用多个当代生成系统构建,并配有详尽元数据。其旨在解决现有图像取证基准无法有效评估法庭证据真实性验证的问题,为法律与计算机视觉研究提供可靠评估平台。
The CIFAR Synthetic Evidence Corpus is a benchmark dataset jointly developed by multiple academic institutions including the University of Toronto, aimed at AI-driven detection of manipulated visual evidence for legal proceedings. This dataset contains 1,505 photographs, consisting of 720 authentic images and 785 tampered or synthetic images, spanning three evidence families: surveillance footage, dashcam footage, and consumer-grade photographs. It simulates a non-expert user threat model through three-tiered tampering classifications—scene condition editing, local element editing, and full synthesis—and is constructed using multiple contemporary generative systems, accompanied by comprehensive metadata. This corpus seeks to address the shortcoming that existing image forensics benchmarks cannot effectively evaluate the authenticity verification of courtroom evidence, thereby providing a reliable evaluation platform for both legal and computer vision research.
CIFAR Synthetic Evidence Corpus for Detecting AI-Manipulated Images
数据集概述
一个用于证据图像真实性认证的基准与数据集,用于评估照片证据在类似法律与机构使用条件下是真实的、被篡改的还是合成的。
核心指标(TL;DR)
| 项目 | 数值 |
|---|---|
| 总项目数 | 1,505 张照片项目 |
| 真实对照 | 720 |
| 篡改/伪造 | 785 |
| 证据族 | 监控(cctv)、行车记录仪(dashcam)、消费级照片(phone) |
| 篡改层级 | T1 场景条件 · T2 局部元素编辑 · T3 完全伪造 |
| 来源数据集 | VIRAT、UCF-Crime(正常子集)、BDD100K、CASIA v2.0 |
| 生成器 | 三个消费级生成系统(匿名发布为变体 A/B/C)+ 人工参与的 Hero 集 |
| 单项元数据 | 来源溯源、场景属性、层级/子类型、生成器变体、提示模板 + 填充提示、训练/测试池 |
| 基线 | 通过 DetectZoo 框架对 D3、UnivFD、DRCT、CNNSpot 进行零样本评估 |
核心信息:现成的合成图像检测器难以迁移到局部的、消费级工具的证据性篡改上,其默认操作点在真实图像上产生的假阳性率对法庭使用而言不可接受。
语料库存在的理由
现有图像取证基准围绕不同的认证对象(人脸、通用自然图像)和不同的篡改模型(经典拼接/复制移动,或整图 GAN/扩散合成)构建。本语料库改为围绕以下方面组织:
- 法庭提交的视觉证据形式(监控、行车记录仪、消费级照片)。
- 局部编辑,改变展示物所证明的内容,同时保留大部分场景不变(例如移除人物、更改标志、添加可见损坏)。
- 消费级工具威胁模型 —— 非专家通过普通界面请求单个限定范围的更改。
- 结构化元数据,支持按族、层级、子类型、生成器和提示进行诊断性评估,而非仅聚合二元准确率。
它是现有取证基准的补充,而非替代。
仓库结构
Synthetic-Evidence-Image-Corpus/ ├── Manipulated-Images/ # T1/T2/T3 篡改与伪造图像 ├── Source-Images/ # 真实源帧 / 真实对照 ├── image_corpus_manifest.csv # 单项元数据清单(CSV) ├── image_corpus_manifest.parquet # 单项元数据清单(Parquet) ├── dataset_analysis.ipynb # Notebook:语料统计 + 基准分析 ├── dataset_analysis_outputs/ # Notebook 生成的图表和表格 └── detectzoo_results/ # 每个检测器的零样本基准输出(DetectZoo)
.parquet 和 .csv 清单包含相同的单项记录;可使用任一工具偏好的格式。Parquet 文件是推荐的权威副本(加载更快、保留数据类型,并带有构建日期戳)。
数据集设计
语料库沿四个轴变化,以便在现实条件下测量检测器行为,而非单一聚合分数。
1. 证据族
| 族 | 清单标签 | 来源数据集 | 备注 |
|---|---|---|---|
| 监控 | cctv |
VIRAT、UCF-Crime(正常活动子集) | 来自两个来源,使检测器无法将单一数据集的视觉特征作为真实性的代理 |
| 行车记录仪 | dashcam |
BDD100K | 每个片段采样一个关键帧 |
| 消费级照片 | phone |
CASIA v2.0 | 每张 CASIA 图像视为一个候选帧 |
这些族在视角、压缩、分辨率、场景结构和证据功能上有所不同。
2. 篡改层级
| 层级 | 变化内容 | 描述 |
|---|---|---|
| T1 — 场景条件 | 全局上下文 | 时间、天气、光照或人群密度变化,主场景内容保留 |
| T2 — 局部元素编辑 | 一个显著元素 | 插入 / 移除 / 更改一个证据显著的要素(人物、车辆、标志、危险、可见损坏) |
| T3 — 完全伪造 | 全部 | 从文本提示生成完整图像,无源帧 |
3. 子类型
子类型按项目记录在 t1_subtype / t2_subtype 中。
- T1 子类型:
TIME、WEATHER、LIGHTING、CROWD - T2 子类型(按族):
监控(cctv) |
行车记录仪 | 消费级(phone) |
|---|---|---|
| 交换物体 · 移除人物 · 移除标牌 · 添加人物 | 移除标志 · 交通灯颜色 · 移除车辆 · 添加危险 | 添加物体 · 移除损坏 · 交换物体 · 添加损坏 |
(清单使用短代码编码,例如 REMOVE-PERSON、LIGHT-COLOR、SWAP-OBJECT-CCT、ADD-DAMAGE。)
4. 生成器
T1/T2 项目将提示模板应用于指定的真实源帧;T3 项目仅从提示生成。语料库使用来自多个组织的三个消费级可访问生成系统,因此结果不依赖于单一模型的伪影。在发布数据中,这些匿名化为变体 A、B 和 C(assigned_variant)。
较小的 Hero 集模拟更高投入的对手,愿意通过迭代人工参与编辑手动细化图像(在 assigned_variant 中标记为 Photoshop / ChatGPT,通过 hero_candidate 标记)。单次变体模拟普通篡改,Hero 集则探测有动机的、手动对手能达到的效果。
提示
生成由一固定提示模板集驱动(涵盖三个族和三个层级的 27 个模板)。每个模板模拟非专家请求单个限定范围的更改,并要求模型保留所有其他场景内容。每个项目的模板和具体填充提示存储在清单中(assigned_prompt_template、assigned_prompt_filled)。
元数据清单
清单是资源的核心。每个篡改/伪造项目为一行,含 65 列,捕获溯源、场景属性、篡改参数和确切使用的提示。按用途分组:
身份与溯源
assigned_item_id、frame_id、dataset(源池,T3 含 fabricated)、source_video_id、frame_seconds、width、height、pool(训练/测试)、assigned_batch_id、assigned_quota
篡改标签
family、tier、assigned_variant(生成器)、t1_subtype、t2_subtype、assigned_prompt_template、assigned_prompt_filled、flagged、flagged_reason、hero_candidate
场景属性(在源帧上自动标记)
time_of_day、weather、lighting_type、is_indoor、people_count_bucket、has_clearly_visible_person、has_open_floor_or_ground_space、person_holding_object、has_wall_signage_visible、has_traffic_light_visible、traffic_light_state、has_stop_sign_visible、has_road_sign_visible、has_clear_road_ahead、vehicle_count_in_scene、has_visible_damage、has_undamaged_surface_target、has_handheld_object_visible、has_open_surface_space
篡改目标与参数
target_time、target_weather、target_lighting、target_crowd,以及 param_* 系列(例如 param_original_object、param_new_object、param_person_reference、param_signage_type、param_current_color、param_target_color、param_hazard_type、param_vehicle_description、param_damage_type、param_object_description、param_scene_type 等)——填充每个提示模板的槽值。
计数说明。 发布清单记录篡改/伪造项目(日期为 2026-06-04 的构建包含 796 行,包括少量
flagged项目和 Hero 候选)。真实对照(720)位于Source-Images/。论文头条数字(720 真实 + 785 篡改 = 1,505)是用于评估的语料总数;将清单视为权威的单项记录。
加载清单
python import pandas as pd
推荐:Parquet
df = pd.read_parquet("image_corpus_manifest.parquet")
或 Excel
df = pd.read_excel("image_corpus_manifest.xlsx")
print(df.shape) # 行 x 65 列 print(df["family"].value_counts()) # cctv / dashcam / phone print(df["tier"].value_counts()) # T1 / T2 / T3 print(df["pool"].value_counts()) # train / test
示例:每个 T2 "移除人物" 监控编辑
mask = (df["family"] == "cctv") & (df["t2_subtype"] == "REMOVE-PERSON") subset = df[mask]
基准
使用 DetectZoo 框架(https://github.com/sadjadeb/DetectZoo)对公开可用的图像篡改检测器零样本评估整个语料库。每个检测器使用其发布权重和默认决策阈值对每张图像评分一次,无微调。报告阈值无关指标(ROC-AUC、PR-AUC)和每个检测器默认阈值下的阈值相关指标(准确率、精确率、召回率、FPR)。任务是对全部 1,505 个项目进行二元认证。
| 检测器 | 准确率 | 精确率 | 召回率 | FPR | ROC-AUC | PR-AUC |
|---|---|---|---|---|---|---|
| D3(扩散重建) | 0.616 | 0.696 | 0.469 | 0.224 | 0.674 | 0.684 |
| UnivFD(CLIP 特征分类器) | 0.573 | 0.686 | 0.336 | 0.168 | 0.643 | 0.633 |
| DRCT(扩散重建对比) | 0.535 | 0.647 | 0.238 | 0.141 | 0.621 | 0.642 |
| CNNSpot(CNN GAN 伪影检测器) | 0.478 | 0.500 | 0.003 | 0.003 | 0.639 | 0.587 |
要点
- 最佳检测器(D3)仅达到 0.674 ROC-AUC;其余接近随机。
- 在其发布阈值下,D3 只捕获不到一半的篡改(召回率约 47%),同时错误标记 22% 的真实图像 —— 在法庭上错误地质疑真实证据是更严重的错误。
- 可检测性不均,与证据结构相关:行车记录仪明显更难,最弱的单元是行车记录仪 T3 伪造;每个生成器的召回率差异显著;Hero(人工细化)集几乎击败检测器,最低分的篡改图像获得约 0.04 的篡改分数。
证据认证基准必须报告这种错误结构,而非仅聚合准确率。每个检测器的输出在 detectzoo_results/ 中;细分和图表在 dataset_analysis.ipynb → dataset_analysis_outputs/ 中复现。
复现分析
bash
1. 克隆
git clone https://github.com/UofT-CIFAR/Synthetic-Evidence-Image-Corpus.git cd Synthetic-Evidence-Image-Corpus
2. 环境(建议)
pip install pandas pyarrow openpyxl jupyter matplotlib seaborn
3. 打开分析 Notebook
jupyter notebook dataset_analysis.ipynb
Notebook 重新生成语料组成统计和按族/按层级/按生成器的基准细分到 dataset_analysis_outputs/。
源数据与许可
篡改图像派生自公开可用的源数据集,每个都有其自身许可和使用条款。任何使用本语料库的人都必须遵守以下原始条款:
- VIRAT(监控视频)
- UCF-Crime(监控视频 —— 正常活动子集)
- BDD100K(驾驶场景)
- CASIA v2.0(消费级照片)
预期用途、局限与负责任使用
预期用途。 用于研究图像认证系统在与证据实践一致的环境中的可靠性、失败模式和局限的研究基准 —— 包括信息完整性、溯源、验证和可信 AI 研究。
非取证工具。 本语料库支持检测器的评估。它不确立任何检测器适合作为证据使用,仅检测并不能解决认证展示物的法律问题。此处的任何内容不应在法律程序中作为经过验证的取证工具呈现。
局限。
- 围绕单次、消费级工具威胁模型加小型高投入 Hero 集构建;未穷尽可能的篡改空间。
- 场景属性由视觉模型自动标记,可能包含标签噪声。
- 生成器覆盖仅限于当代消费级系统的快照;可检测性将随模型演进而变化。
- 语料库派生自特定源域,可能无法迁移到其他成像条件。
负责任使用。 篡改图像是伪造的,不得作为真实事件的描述呈现。仅用于检测、认证和信息完整性的研究。
引用
如果使用本语料库,请引用论文:
bibtex @inproceedings{mcconvey2026synthetic, title = {A Benchmark and Dataset for Detecting AI-Manipulated Visual Evidence in the Court System}, author = {McConvey, Kelly and Ebrahimi, Sajad and Mahdavimoghaddam, Jalehsadat and Jamali, Nima and Mahdizadeh Sani, Matina and Zhang, Wentao and Deng, Yuntian and Grossman, Maura and Taranukhin, Maksym and Shwartz, Vered and Burkell, Jacquelyn and Eltis, Karen and Bagheri, Ebrahim}, }
致谢
本工作得到保护法庭免受合成 AI 内容影响解决方案网络的支持,通过 CIFAR 的加拿大 AI 安全研究所(CAISI)研究计划资助。
联系方式
如有问题或事项,请在本仓库打开 issue。
- 1A Benchmark & Dataset for Detecting AI-Manipulated Visual Evidence in the Court System多伦多大学; 滑铁卢大学; 不列颠哥伦比亚大学; 西安大略大学; 渥太华大学 · 2026年



