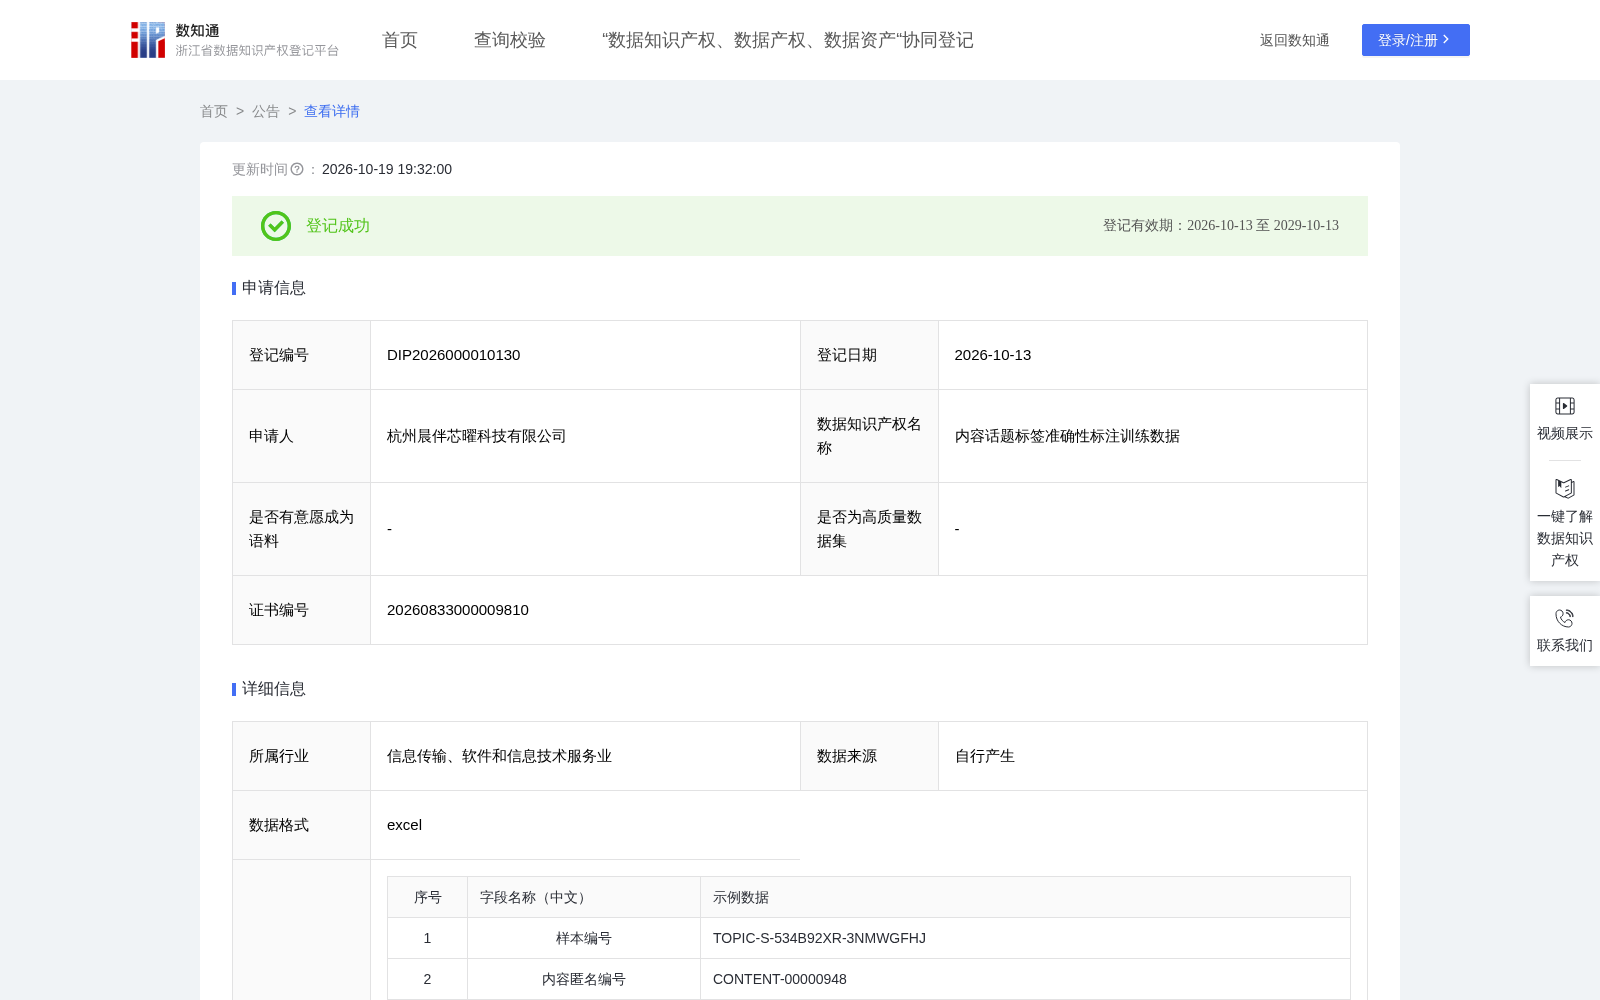
内容话题标签准确性标注训练数据
收藏资源简介:
本数据面向内容平台、品牌运营方和商家内容营销场景,适用于图文或文章的话题标签核验、推荐分发和内容检索。通过提取标题与正文关键词、计算正文和话题标签的语义相似度,可识别标签与内容主题完全匹配、部分匹配或不匹配的记录,为内容审核、检索优化和分类模型训练提供结构化数据。使用时需同时取得去标识化标题、正文和原话题标签,不将标签脱离文本证据单独判断。数据使用方可结合关键词命中结果、两项语义相似度、准确性标签和证据片段评价模型的关键词提取、语义匹配及三级分类效果,并依据数据集划分标识开展训练、验证和测试。一、加工前的数据说明: 原始数据来源于企业自有内容平台的图文或文章内容及其话题标签记录,原始字段包括记录编号、内容类别、标题、正文和原始话题标签。 二、处理规则: 1.数据清洗:按记录编号去重,删除标题、正文或标签缺失以及与任务无关的记录;统一字符编码和空白符,将标题、正文按句切分并清理无实际语义的符号,对同义表达进行归并,保留能够反映内容主题的文本。在不改变正文主题词、语义重点和证据片段的前提下,对集中重复的说明式衔接语进行表达规范化,减少固定句式对文本特征的干扰。对可能识别用户或业务主体的信息进行不可逆去标识化,使后续关键词提取和语义计算使用统一文本口径。 2.算法标注:使用固定版本的文本语义模型提取标题和正文关键词,形成全部命中、部分命中、无命中三种关键词命中结果;计算标题正文语义向量相似度T和正文标签语义相似度S。标题或正文与原话题标签存在两个及以上核心词完全匹配时,执行词面重合校准并将S下限设为0.80。S≥0.80且关键词全部命中时标注准确;0.50≤S<0.80或关键词部分命中时标注部分准确;S<0.50且关键词无命中时标注不准确,并保留支持判定的证据片段。 3.算法校验:校验相似度取值范围、关键词命中结果和标签阈值的一致性;相同标题、正文和标签组合仅保留一条固定计算结果。按内容匿名编号和“去标识化标题+去标识化正文+原话题标签”核心文本签名联合分组,并按标签分层以8:1:1划分训练集、验证集和测试集,避免同一内容对象或相同核心文本组合跨集合出现。 三、数据内容描述: 最终形成结构化的内容话题标签准确性标注训练数据集合,包含以下字段:1)样本编号:样本匿名唯一标识;2)内容匿名编号:内容的去标识化编号;3)内容类别:内容社区;4)去标识化标题:删除直接身份信息后的标题;5)去标识化正文:删除直接身份信息后的正文;6)原话题标签:内容原有的话题标签;7)正文关键词:算法提取的正文关键词;8)关键词命中结果:全部命中、部分命中或无命中;9)标题正文语义向量相似度:标题与正文的语义相似度;10)正文标签语义相似度:正文与原话题标签的语义相似度;11)话题标签准确性标签:准确、部分准确或不准确;12)证据片段:支持标签判定的关键词证据;13)数据集划分标识:训练集、验证集或测试集。