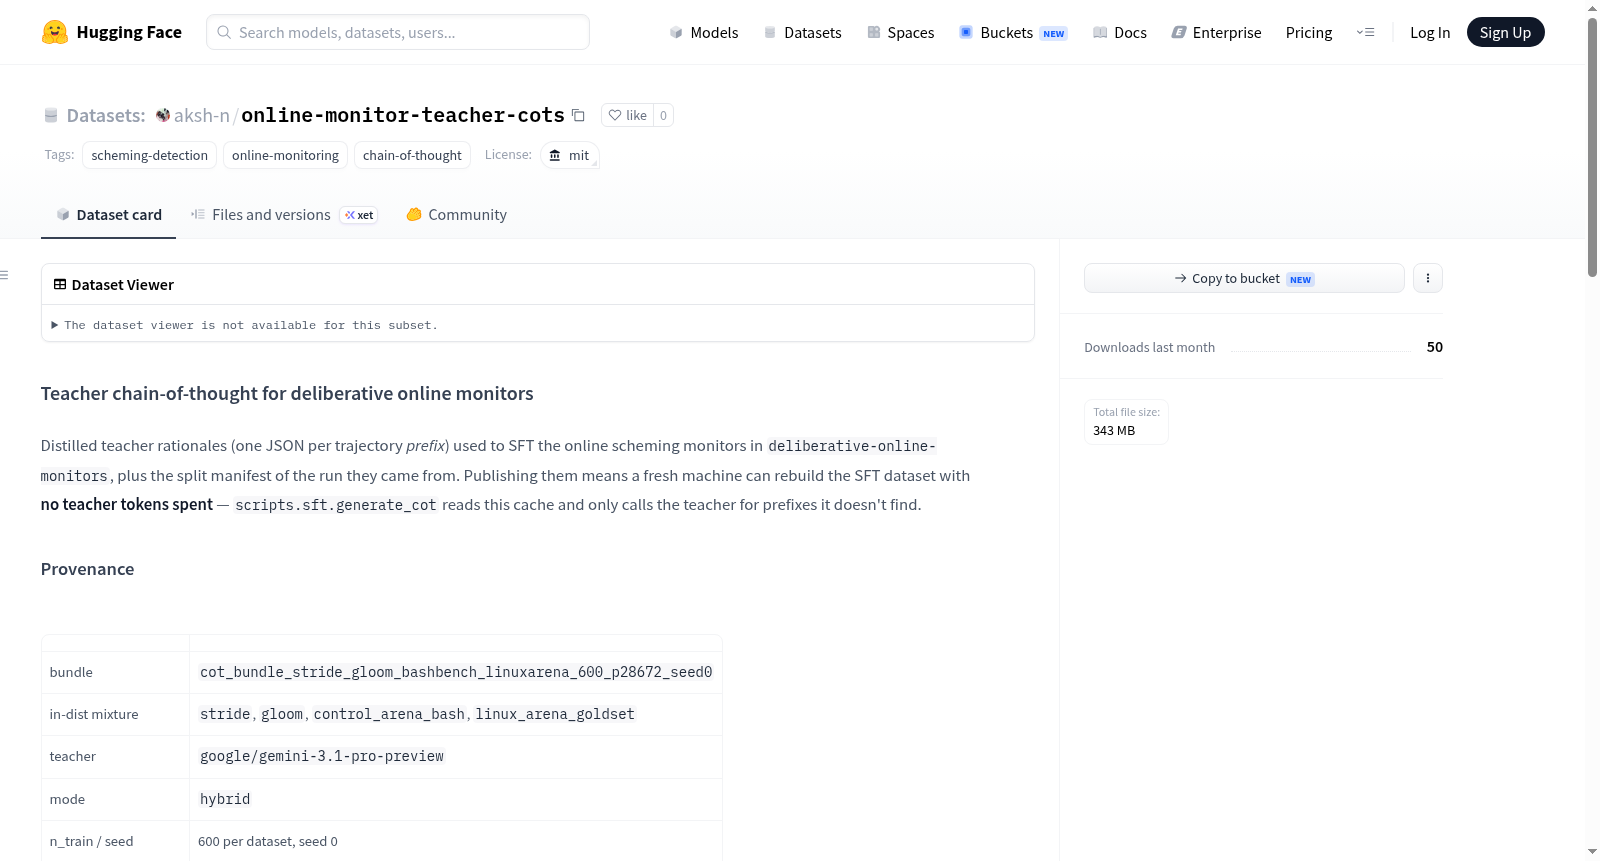
online-monitor-teacher-cots
收藏资源简介:
该数据集名为“教师推理链用于审议性在线监控器”(Teacher chain-of-thought for deliberative online monitors),旨在为在线监控器提供教师模型的推理链(chain-of-thought)日志,用于监督微调(SFT)。数据集包含来自四个不同来源的推理链日志:control_arena_bash、gloom、linux_arena_goldset 和 stride。每个来源的日志文件以 tar.gz 压缩包形式存储,内含 JSON 文件,每个 JSON 对应一个轨迹前缀的教师推理。此外,还提供了导出的 parquet 文件(如 control_arena_bash_cot_600_p28672.parquet)、分割清单(MANIFEST.json)以及分割文件(splits.json 和 splits.csv),详细说明了各个数据集在训练、评估和域外评估中的划分。数据规模:每个来源数据集各有 600 个训练样本,200 个 indist_eval 样本,200 个 val_eval 样本;另有四个域外评估数据集(basharena_action_only_opus46_large、control_arena_shade、control_arena_agentdojo、control_arena_iac、gloom_exfiltration)各包含 800 个 ood_eval 样本。教师模型为 google/gemini-3.1-pro-preview,采用混合模式,提示词 token 预算为 28672。该数据集的主要用途是让用户无需消耗教师 token 即可重建 SFT 数据集,通过脚本 scripts.sft.generate_cot 读取缓存。
This dataset is named Teacher chain-of-thought for deliberative online monitors, designed to provide teacher model chain-of-thought logs for online monitors, used for supervised fine-tuning (SFT). The dataset contains chain-of-thought logs from four different sources: control_arena_bash, gloom, linux_arena_goldset, and stride. Log files from each source are stored in tar.gz archives, containing JSON files, each corresponding to a teachers reasoning for a trajectory prefix. Additionally, exported parquet files (e.g., control_arena_bash_cot_600_p28672.parquet), a manifest file (MANIFEST.json), and split files (splits.json and splits.csv) are provided, detailing the division of each dataset into training, evaluation, and out-of-domain evaluation sets. Data scale: each source dataset has 600 training samples, 200 indist_eval samples, 200 val_eval samples; four out-of-domain evaluation datasets (basharena_action_only_opus46_large, control_arena_shade, control_arena_agentdojo, control_arena_iac, gloom_exfiltration) each contain 800 ood_eval samples. The teacher model is google/gemini-3.1-pro-preview, using a mixed mode with a prompt token budget of 28672. The main purpose of this dataset is to allow users to reconstruct the SFT dataset without consuming teacher tokens, by reading the cache via the script scripts.sft.generate_cot.
数据集概述
该数据集名为 Teacher chain-of-thought for deliberative online monitors,由 aksh-n 发布,采用 MIT 许可证。其核心内容是为“在线监控者”(online monitors)提供蒸馏后的教师推理链(chain-of-thought,CoT)数据,用于对在线阴谋检测模型进行监督微调(SFT)。数据集同时包含运行分割清单(split manifest),使得新机器可以在不重新消耗教师模型 token 的情况下重建 SFT 数据集。
数据来源与配置
- 数据包名称:
cot_bundle_stride_gloom_bashbench_linuxarena_600_p28672_seed0 - 分布内(in-distribution)混合数据集:
stride、gloom、control_arena_bash、linux_arena_goldset - 教师模型:
google/gemini-3.1-pro-preview - 生成模式:
hybrid - 训练规模:每个数据集 600 条轨迹,随机种子为 0
- 提示词 token 预算:28672
数据集结构
CoT 日志文件
每个数据集对应一个压缩包,内部为扁平的 JSON 文件(命名格式为 row_<idx>__step<t>__<teacher>__<mode>.json),解压后直接放入 data/<dataset>/cot_logs/ 目录。具体分布如下:
| 数据集 | 日志数量 | 文件 |
|---|---|---|
control_arena_bash |
2344 | cot_logs/control_arena_bash.tar.gz |
gloom |
2513 | cot_logs/gloom.tar.gz |
linux_arena_goldset |
2352 | cot_logs/linux_arena_goldset.tar.gz |
stride |
2368 | cot_logs/stride.tar.gz |
SFT 数据文件(Parquet 格式)
cot_parquets/ 目录下存放了派生出的、按数据集划分的 SFT Parquet 文件:
control_arena_bash_cot_600_p28672.parquetgloom_cot_600_p28672.parquetlinux_arena_goldset_cot_600_p28672.parquetstride_cot_600_p28672.parquet
根目录文件
MANIFEST.json:数据包配置、各数据集计数以及分割大小。splits.json/splits.csv:记录每条轨迹(通过在各数据集分段 Parquet 中的位置索引row_idx标识)属于train、indist_eval、val_eval或ood_eval中的哪一个分割。
数据分割
| 数据集 | 角色 | 分割详情 |
|---|---|---|
stride |
分布内 | train=600, indist_eval=200, val_eval=200 |
gloom |
分布内 | train=600, indist_eval=200, val_eval=200 |
control_arena_bash |
分布内 | train=600, indist_eval=200, val_eval=200 |
linux_arena_goldset |
分布内 | train=600, indist_eval=200, val_eval=200 |
basharena_action_only_opus46_large |
分布外(ood) | ood_eval=800 |
control_arena_shade |
分布外(ood) | ood_eval=800 |
control_arena_agentdojo |
分布外(ood) | ood_eval=800 |
control_arena_iac |
分布外(ood) | ood_eval=800 |
gloom_exfiltration |
分布外(ood) | ood_eval=800 |
使用方式
数据集中提供了两种使用路径:
-
仅下载本仓库内容(CoT 日志和 Parquet 文件): bash uv run python -m scripts.sft.hf_cots --download --dataset <ds>
-
完整机器搭建(包含原始 Parquet、分段 Parquet、日志以及 CoT 数据): bash uv run python experimental/akshat/misc/setup_machine.py uv run python experimental/akshat/misc/setup_machine.py --phase cots
-
手动下载示例(以
stride为例): python from huggingface_hub import hf_hub_download import tarfile p = hf_hub_download("aksh-n/online-monitor-teacher-cots", "cot_logs/stride.tar.gz", repo_type="dataset") tarfile.open(p).extractall("data/stride/cot_logs")