遇见数据集

allenai/scitldr

收藏
Hugging Face2023-01-25 更新2024-03-04 收录
官方服务:

资源简介:

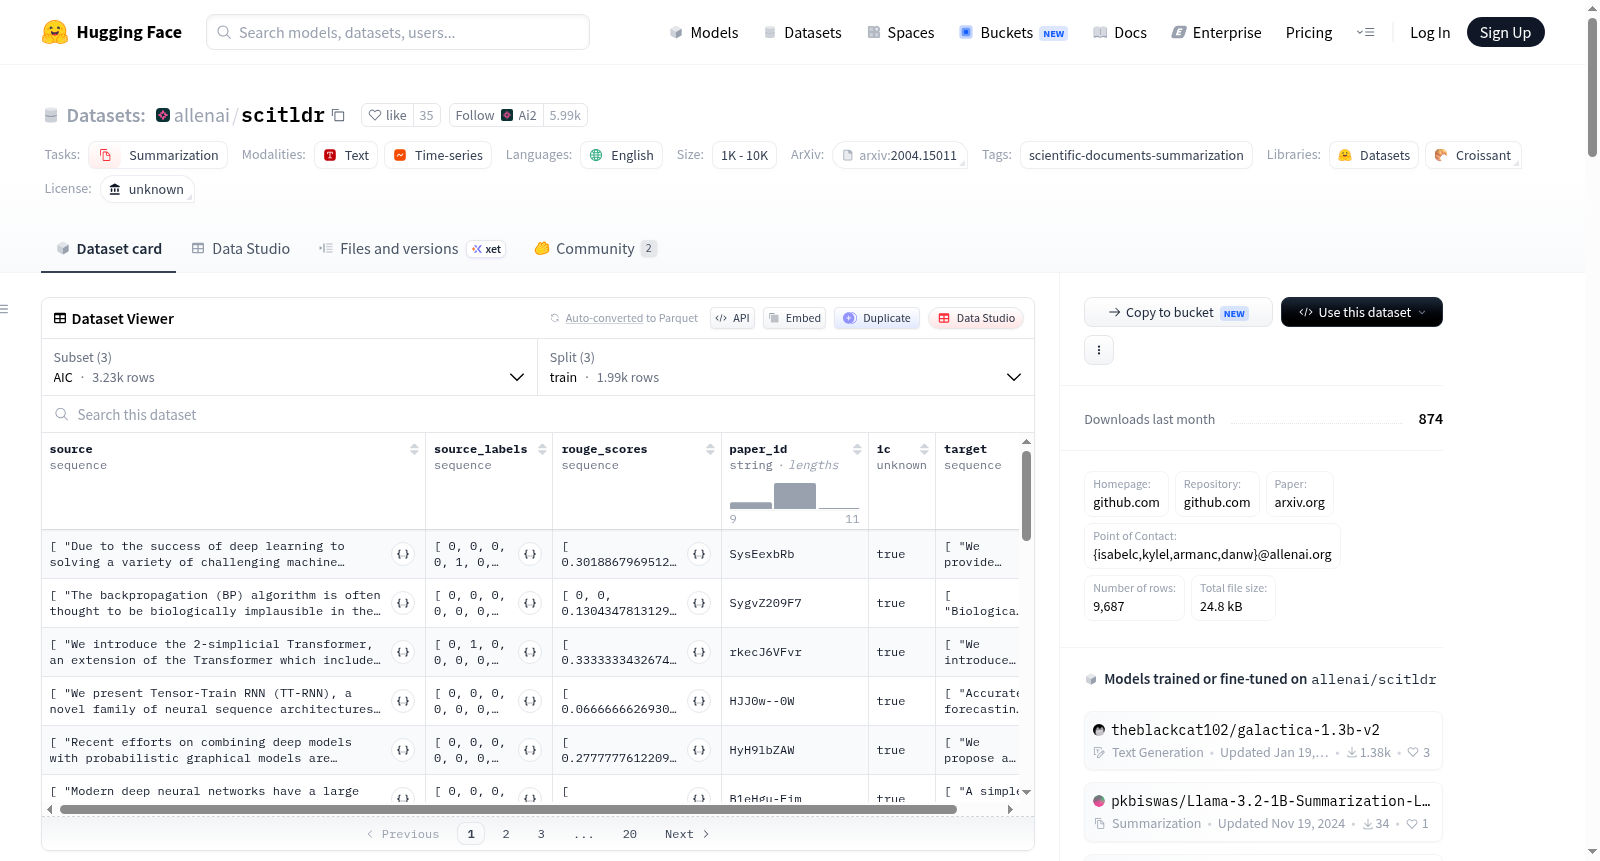
SciTLDR是一个用于科学文档极端摘要的多目标数据集,包含5.4K个TLDR(Too Long; Didnt Read)摘要,覆盖3.2K篇论文。数据集包含作者撰写的和专家导出的TLDR,后者通过一种新颖的注释协议收集,以最小化注释负担的同时生成高质量的摘要。数据集支持的任务是摘要生成,语言为英语。数据集结构包括训练集、验证集和测试集,数据字段包括源文本、源标签、预计算的ROUGE分数、论文ID、目标摘要和论文标题。

SciTLDR is a multi-target dataset for extreme summarization of scientific documents, containing 5.4K TLDR (Too Long; Didn't Read) summaries covering 3.2K papers. The dataset includes TLDRs written by authors and expert-derived ones. The expert-derived TLDRs are collected via a novel annotation protocol that minimizes annotation burden while generating high-quality summaries. The task supported by this dataset is summarization, with the language being English. The dataset is structured into training, validation, and test sets, with its data fields including source text, source label, pre-computed ROUGE scores, paper ID, target summary, and paper title.

提供机构:
allenai
原始信息汇总

数据集概述

名称: SciTLDR

语言: 英语

许可: 未知

多语言性: 单语

大小: 1K<n<10K

来源: 原始数据

任务类别: 摘要生成

标签: 科学文档摘要

数据集结构

配置

  • Abstract: 包含摘要信息
  • AIC: 包含摘要、介绍和结论信息
  • FullText: 包含完整文本信息

特征

  • source: 字符串序列,包含论文的摘要、介绍和结论或完整文本
  • source_labels: 序列,包含二进制标签,指示是否为关键句子
  • rouge_scores: 浮点数序列,预计算的ROUGE分数
  • paper_id: 字符串,论文ID
  • target: 字符串序列,包含多个摘要

数据分割

  • train: 训练集,1992个样本
  • test: 测试集,618个样本
  • validation: 验证集,619个样本

大小

  • Abstract: 训练集2738065字节,测试集1073656字节,验证集994876字节
  • AIC: 训练集14473822字节,测试集4822026字节,验证集4476237字节
  • FullText: 训练集66917363字节,测试集20182554字节,验证集18790651字节

数据实例

  • source: 论文句子序列
  • source_labels: 二进制标签序列
  • rouge_scores: 预计算的ROUGE分数序列
  • paper_id: 论文ID
  • target: 摘要序列
  • title: 论文标题
搜集汇总
数据集介绍
allenai/scitldr 数据集图片
构建方式
在科学文献摘要领域,精准而简洁的摘要生成对于知识传播至关重要。SciTLDR数据集由艾伦人工智能研究所构建,旨在推动科学文档的极端摘要任务。该数据集涵盖了3.2K篇论文,共包含5.4K条TLDR摘要,分为作者撰写和专家衍生两类。其中专家衍生摘要通过一种新颖的标注协议生成,该协议在最小化标注负担的同时确保了摘要的高质量。数据集提供了三种配置:Abstract、AIC(摘要、引言与结论)和FullText,分别对应不同粒度的源文本。每条数据包含源文本句子序列、Oracle句子标签、预计算的ROUGE分数、论文ID以及多条目标摘要,从而为多目标摘要研究提供了丰富的基准。
特点
SciTLDR数据集的核心特点在于其多目标性和极端摘要的定位。每个源文本对应多条摘要,包括作者TLDR和专家TLDR,这为模型学习多样化的摘要风格提供了可能。数据集通过Oracle句子标注和预计算ROUGE分数,为有监督的摘要提取与生成方法提供了便利。此外,三种配置(Abstract、AIC、FullText)允许研究者从不同文本长度探索摘要性能,尤其FullText配置保留了论文全文,挑战模型在长文本中提取关键信息的能力。数据规模虽小(训练集1992条),但其精心设计的结构和多目标特性使其成为科学摘要领域的独特资源。
使用方法
使用SciTLDR数据集时,研究者可通过HuggingFace Datasets库直接加载,选择所需的配置(如'Abstract'、'AIC'或'FullText')以适配不同研究需求。数据以JSON格式存储,包含'source'(句子列表)、'source_labels'(Oracle标签)、'rouge_scores'(ROUGE分数)、'paper_id'和'target'(多摘要列表)等字段。对于摘要生成任务,可将'source'作为输入,'target'中的任一条或多条摘要作为输出进行训练。Oracle标签可用于提取式摘要的监督学习,而预计算ROUGE分数则便于评估句子重要性。数据集已分为训练、验证和测试集(60/20/20比例),可直接用于模型训练与评测。
背景与挑战
背景概述
SciTLDR数据集由艾伦人工智能研究所(Allen Institute for AI)的研究人员Isabel Cachola、Kyle Lo、Arman Cohan和Daniel S. Weld于2020年创建,旨在推动科学文献的极端摘要(Extreme Summarization)任务。该数据集聚焦于生成极为简洁的单句摘要(TLDR),以应对科研信息过载时代对高效知识提炼的迫切需求。SciTLDR包含约5400个TLDR摘要,覆盖3200篇论文,其独特之处在于融合了作者撰写和专家推导的摘要,并通过一种新颖的标注协议在保证摘要质量的同时降低了标注成本。该数据集为科学文档摘要领域提供了标准化的基准,显著促进了相关模型与算法的研究进展。
当前挑战
SciTLDR所解决的核心领域挑战在于科学文献的极端摘要任务,即从长篇学术论文中自动生成高度凝练、信息准确的单句摘要,这对模型的语言理解与信息压缩能力提出了极高要求。构建过程中面临的主要挑战包括:如何设计高效的标注协议以获取高质量的多源摘要,同时控制标注成本;如何确保摘要的客观性与一致性,避免引入标注者偏差;以及如何处理不同论文结构(如仅摘要、摘要与引言结论、全文)对摘要质量的影响,从而构建具有广泛适用性的数据集。
常用场景
经典使用场景
SciTLDR数据集专为科学文献的极端摘要任务而设计,其核心应用场景在于从学术论文的摘要、引言与结论(AIC)乃至全文(FullText)中,自动生成高度凝练的单句摘要(TLDR)。该数据集包含超过5400条目标摘要,覆盖3200余篇论文,并创新性地融合了作者自撰摘要与专家衍生摘要,为训练和评估生成式摘要模型提供了多视角、高质量的标准基准。研究者常利用其提供的Oracle句子标签与预计算ROUGE分数,开展有监督的抽取式与生成式摘要方法对比实验,从而推动极端摘要技术在科学文档领域的精准化与鲁棒性发展。
实际应用
在实际应用中,SciTLDR驱动的摘要技术被广泛部署于学术搜索引擎和文献管理工具中,例如为研究者快速生成论文核心要点的TLDR,辅助其在海量文献中高效筛选相关成果。科技出版商和数字图书馆亦利用基于该数据集训练的模型自动生成论文的简洁概述,提升知识发现效率。此外,该技术还延伸至科研基金评审、学术会议论文速览等场景,通过自动化摘要降低人力审阅成本,加速科学信息的传播与交流。其轻量级摘要特性尤其适合移动端阅读和智能问答系统,为科学知识的普惠化提供了技术支撑。
衍生相关工作
SciTLDR的发布直接催生了一系列经典后续工作,包括基于预训练语言模型(如BART、T5)的极端摘要微调方案,以及结合图神经网络进行科学论文结构感知的摘要生成方法。研究者还借鉴其多目标摘要设计,开发了跨领域科学摘要数据集(如SciSummNet)和可控摘要模型(如Controllable SciTLDR)。此外,该数据集被广泛应用于评估生成式摘要的忠实度与简洁性,并催生了面向科学文档的ROUGE变体指标及摘要质量自动评估框架。这些衍生工作不仅深化了对科学文本压缩规律的理解,也为多文档摘要、长文本生成等邻近领域提供了方法论启示。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务