qualora-workforce-skills-graph
收藏资源简介:
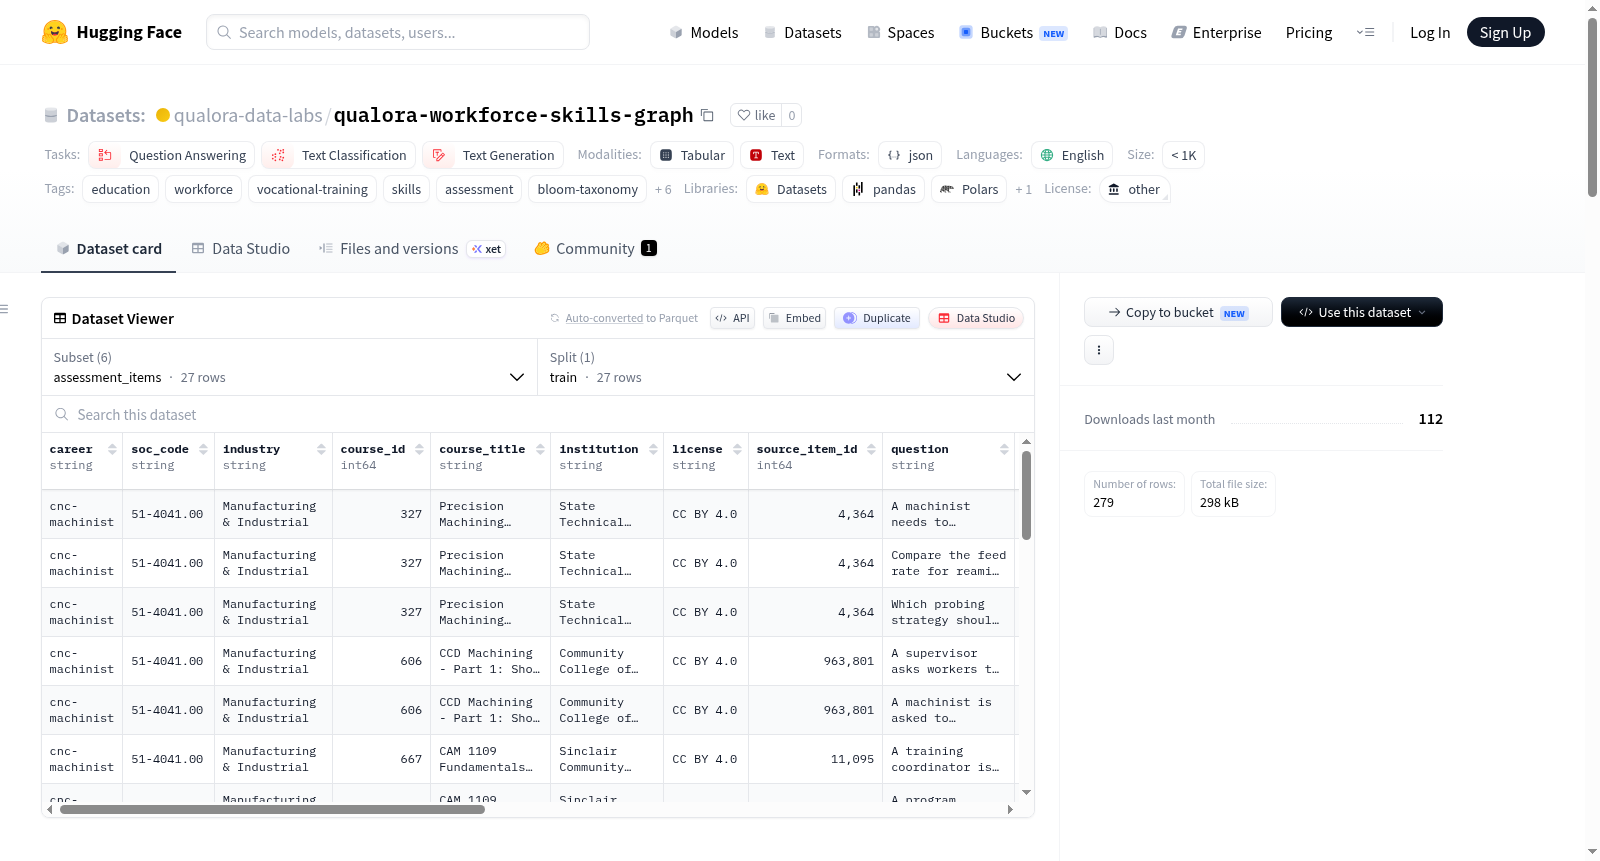
Qualora Workforce Skills Graph(代表性样本)是一个基于美国劳工部资助的开放课件(主要遵循CC BY 4.0许可)构建的权利清晰、来源可追溯的职业学习技能图数据集,专为训练后微调和评估设计,而非预训练。该数据集旨在为技能映射、辅导、评估生成和职业路径规划等任务提供密集的标注监督和评估材料。数据集包含多个结构化配置文件:`assessment_items`(评估项,包含问题、布鲁姆分类级别、学习目标、答案原理和来源证据)、`course_skill_edges`(课程-技能边,包含置信度和证据短语)、`career_tasks`(基于O*NET的真实职业任务描述)、`career_esco`(多语言职业标签映射)、`skills`(技能节点)和`courses`(课程及来源信息)。代表性样本聚焦于CNC机械师和医疗编码/HIM两个垂直领域,包含27个评估项、128个课程-技能边等数据。完整许可语料库规模更大,包含约2100门课程、18,700节课、197,000+个布鲁姆分类标注的评估项、28,600+个图边,并映射到447个O*NET职业。数据具有高比例的原理标注(适合奖励模型训练)和干净的来源,可用于构建无污染的评估集。
Qualora Workforce Skills Graph (Representative Sample) is a rights-clear, source-traceable occupational learning skill graph dataset built upon open course materials funded by the U.S. Department of Labor, which primarily adheres to the CC BY 4.0 license. It is designed specifically for post-training fine-tuning and evaluation, rather than pre-training. This dataset aims to provide dense annotated supervision and evaluation materials for tasks including skill mapping, tutoring, assessment generation, and career path planning. The dataset comprises multiple structured profiles: `assessment_items` (assessment items, encompassing questions, Bloom's taxonomy levels, learning objectives, answer rationales, and source evidence), `course_skill_edges` (course-skill edges with confidence values and evidence phrases), `career_tasks` (authentic occupational task descriptions based on O*NET), `career_esco` (multilingual occupational label mapping), `skills` (skill nodes), and `courses` (courses and their source information). The representative sample focuses on two vertical domains: CNC machinists and medical coding/HIM, and contains data such as 27 assessment items and 128 course-skill edges. The full licensed corpus has a larger scale, including approximately 2,100 courses, 18,700 lessons, over 197,000 assessment items annotated with Bloom's taxonomy levels, over 28,600 graph edges, and mapped to 447 O*NET occupations. The data features a high proportion of rationale annotations (ideal for reward model training) and clean source provenance, enabling the construction of pollution-free evaluation sets.
数据集概述:Qualora Workforce Skills Graph (Representative Sample)
这是一个基于约20亿美元美国劳工部资助的开放课件重建的、带有版权保护和来源追踪的职业学习数据集,专为模型的后训练和评估阶段设计,而非预训练。
数据集核心信息
- 名称: Qualora Workforce Skills Graph (Representative Sample)
- 语言: 英语 (en)
- 许可证: 其他 (other),详见于授权协议
- 大小: 少于1000条 (n<1K),为有界评估样本(包含两个垂直领域:CNC机械师和医疗编码/健康信息管理)
- 任务类别: 问答 (question-answering)、文本分类 (text-classification)、文本生成 (text-generation)
- 标签: 教育、劳动力、职业培训、技能、评估、布鲁姆分类法、O*NET、职业、训练数据、技能图谱、评估、来源
数据配置与内容
该样本包含6个配置,可通过load_dataset加载。核心字段均为嵌套JSON结构,具体如下:
| 配置 (Config) | 行数 | 描述 |
|---|---|---|
assessment_items (默认) |
27 | 包含问题、布鲁姆分类级别、学习目标、理据、来源证据、每个项目的验证标志及课程来源。侧重于应用/分析/评估级别。 |
course_skill_edges |
128 | 切片中每门课程的完整、基于内容的映射:包含课程ID、技能ID、置信度 (0至1)、来源、证据短语。 |
career_tasks |
16 | 基于O*NET 30.3的每个职业的真实工作任务基础数据 (包含任务文本、重要性)。完整图谱包含通过2,480条衍生职业-任务边连接的18,796条任务陈述。 |
career_esco |
10 | 新增:通过官方ESCO-O*NET映射表实现的多语言互操作 (SKOS匹配类型),包含了德语、法语、西班牙语、波兰语的标签样本。 |
skills |
88 | 技能节点,包含类别、分类路径、O*NET交叉引用;所有边引用均可解析(无悬垂ID)。 |
courses |
10 | 标题及来源信息 (机构、许可证、来源项目ID、转换日期)。 |
完整数据集规模 (需授权获取)
- 来源课程: 约2,100门
- 课程内容: 约18,700课 (~8,800万 tokens)
- 评估项: 197,000+ (布鲁姆分类标记) + 独立的约199,000项考试题库
- 互动活动: 45,000+ 个分级互动活动
- 技能图谱: 2,624个技能,映射至447个O*NET职业 (113个完整连接),包含BLS薪资背景
- 图谱边: 28,600+ 条边
- 来源机构: 362个
数据集特性与价值主张
- 版权与来源: 99.6%的源课程采用CC BY 4.0许可证,每个记录均附带一个来源清单(机构、许可证、来源项ID)。坚持使用结构化开源课程,无抓取的网页文本、书籍或服务条款数据。
- 能力提升: 提供密集的标注监督和评估材料,用于技能映射、辅导、评估生成和职业路径规划行为,并已在受控微调实验中验证。实验表明,在结构化图谱上训练可使保留集上的技能映射F1分数从0.080提升至0.401(5.0倍),而使用原始、token匹配的文本得分仅为0.052,低于未训练基线。
- 用途: 适用于奖励模型和评判模型的训练(通过带理据的项目),以及通过保留的、有日期的、来源清晰的项目构建无污染的评估集。
数据加载示例
python from datasets import load_dataset
repo = "qualora-data-labs/qualora-workforce-skills-graph"
items = load_dataset(repo, "assessment_items", split="train") edges = load_dataset(repo, "course_skill_edges", split="train") skills = load_dataset(repo, "skills", split="train") courses = load_dataset(repo, "courses", split="train")
从问题和理据生成SFT配对示例
sft = [{"prompt": r["question"], "completion": r["rationale"]} for r in items]
置信度加权的技能映射,首先获取信号最强的边
mapping = sorted(edges, key=lambda e: -(e["confidence"] or 0)) print(mapping[0])
数据集范围与应用
- 适用阶段: 后训练与评估,非预训练。
- 提供方: Qualora (Moonlight Capital LLC, d/b/a Qualora)。
- 获取方式: 公开样本可在Hugging Face浏览;完整数据集及评估套件需通过授权协议获取。详情请访问 qualora.io/data-labs。