
samadpls/torchlight-threads
收藏数据链接:
官方服务:
资源简介:
torchlight-threads 来自 22,484 个 PyTorch 论坛帖子。对于每个帖子,它保留被标记为解决方案的回复,或提问者表示解决了问题的回复;一个小型 LLM agent 审查了不明确的案例。该数据集包含 6,841 个论坛问题,每个问题都配有解决该问题的答案。按日期划分,训练集包含 2024 年 7 月之前的 6,925 个对话,验证集包含 2024 年 7 月至 12 月的 169 个对话,测试集包含 2025 年 1 月至 2026 年 10 月的 260 个问题。测试问题比模型训练时见过的任何内容都新。
创建时间:
2026-10-29
原始信息汇总
数据集概述
- 名称:torchlight-threads
- 标识:samadpls/torchlight-threads
- 托管地址:https://huggingface.co/datasets/samadpls/torchlight-threads
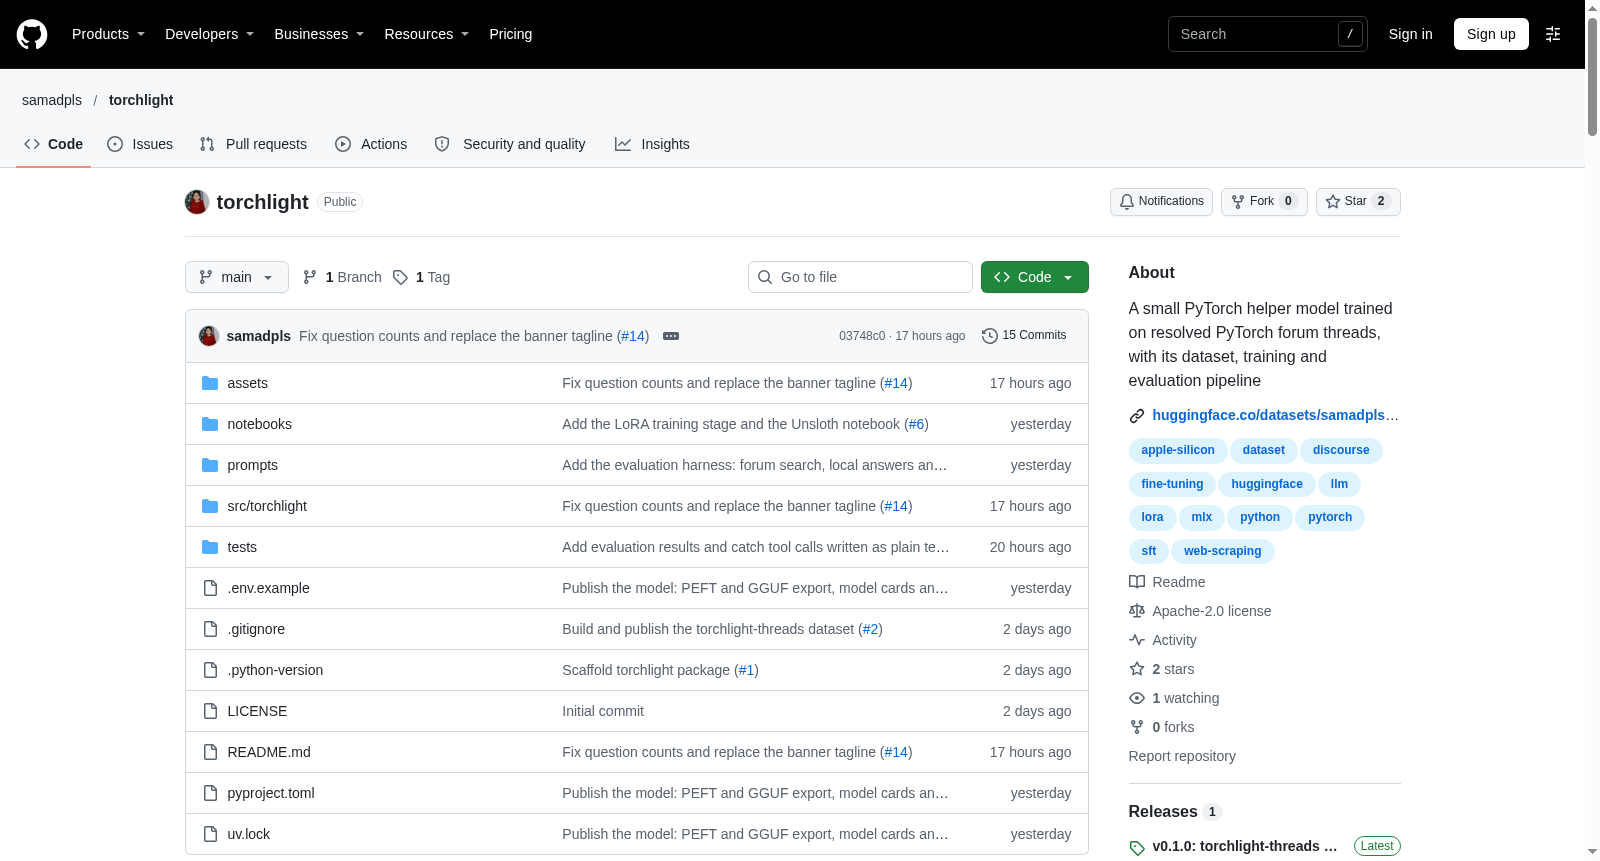
- 项目详情页:https://github.com/samadpls/torchlight
- 所属项目:torchlight 项目第一部分 Dataset
- 内容:PyTorch 论坛问题及解决答案
数据来源与构建
- 来源:PyTorch forum,https://discuss.pytorch.org
- 原始主题数:22,484 个论坛主题
- 保留答案:每个主题中标记为解决方案的帖子,或提问者表示已解决问题的帖子
- 审核:不清楚案例由小型 LLM agent 审核
- 配对方式:论坛问题与解决该问题的答案配对
- 项目描述规模:6,841 个论坛问题,每个问题配有解决答案
- 追溯:每个示例链接回其论坛主题
划分与规模
| Split | Size | Threads from |
|---|---|---|
| Training | 6,925 chats | before July 2024 |
| Validation | 169 chats | July to December 2024 |
| Test | 260 questions | January 2025 to October 2026 |
- 划分方式:按日期划分
- 测试集特点:测试问题新于模型训练所用内容
许可
- 数据集许可:CC BY 4.0
- 许可地址:https://creativecommons.org/licenses/by/4.0/
- 遵循:PyTorch forums terms
引用
bibtex @misc{samad2026torchlight, author = {Abdul Samad}, title = {torchlight threads: resolved PyTorch forum questions and answers}, year = {2026}, url = {https://huggingface.co/datasets/samadpls/torchlight-threads} }
致谢
- 数据集作者:Abdul Samad
- 答案来源:PyTorch forum community
- 主要贡献者:ptrblck,https://discuss.pytorch.org/u/ptrblck
- 每个示例链接回其 thread
搜集汇总
数据集介绍
构建方式
面向PyTorch问答社区的知识沉淀需求,torchlight-threads以论坛解决线程为构建源头。数据采集自PyTorch论坛22,484个线程,筛选被标记为解决方案或提问者确认有效的回复,形成问题与最终答案的配对。对于语义模糊或答案归属不清的案例,引入小规模LLM代理进行复核,以提升配对可靠性。数据按时间切分:2024年7月之前为训练集,含6,925条对话;2024年7月至12月为验证集,含169条;2025年1月至2026年10月为测试集,含260条问题。日期划分使测试问题晚于训练知识截止时间,降低信息泄漏风险,构建流程涵盖爬取、清洗、答案选择与数据集生成。
特点
作为面向PyTorch开发者社区的真实问答资源,该数据集呈现出解决导向、时间分层与来源可溯的特点。每条样本均来自实际论坛提问及最终解决答案,并保留原帖链接,承载社区语境与技术细节。训练、验证、测试按时间递进切分,测试集问题相对新颖,适合评估模型在知识截止后的泛化能力。数据规模适中,训练集6,925条对话、验证集169条、测试集260条,覆盖PyTorch常见错误、API使用、设备管理、张量操作等主题。数据集采用CC BY 4.0许可,强调开放使用与来源追溯,为代码问答研究提供可靠语料。
使用方法
在PyTorch代码辅助模型开发与评测中,torchlight-threads可作为监督微调与基准测试语料。使用者可通过Hugging Face数据集页面获取数据,按split加载训练、验证与测试部分,用于模型微调、检索增强或答案质量评估。训练时建议沿用数据集配套系统提示,引导模型在信息充分时给出具体修复方案,在信息不足时请求最小可执行代码或完整报错信息。配套模型torchlight-phi4-mini支持transformers pipeline、LoRA适配器及GGUF格式调用,便于本地推理与实验复现。该数据集亦可服务于论坛问答系统、代码助手评测及社区知识挖掘等研究场景。
背景与挑战
背景概述
在深度学习框架生态中,PyTorch 官方论坛长期承担着技术疑难会诊与经验沉淀的功能。torchlight-threads 数据集由 Abdul Samad 于 2026 年发布,源自 PyTorch 论坛 22,484 个线程,经筛选保留被标记为解决方案或提问者确认有效的回答,最终形成约 6,841 个问题—答案实例。其核心研究问题在于:如何将真实社区问答中的诊断知识注入小型语言模型,使其在问题细节充分时给出具体修复,在信息不足时主动索要最小可执行代码或完整错误。该数据集为领域专用问答、论坛知识抽取与时间泛化评估提供了可复现资源。
当前挑战
面向真实 PyTorch 调试场景,技术问题的解决往往依赖版本、设备、张量形状、完整报错与最小复现代码,提问者常缺失关键信息,且测试集来自 2025 至 2026 年,超出基座模型知识截止,形成显著时间漂移与知识覆盖挑战。构建过程中,需从海量论坛线程中判别真正解决答案、过滤噪声与离题回复、处理多轮讨论和许可约束,并以小型 LLM 代理复核模糊案例;按日期切分虽可评估泛化,却加剧分布偏移。模型未在工具使用数据上训练,论坛检索难以增益,自动判分对答案等价性亦具挑战。
常用场景
经典使用场景
立足于PyTorch开发者社区的知识生产语境,torchlight-threads最经典的用途是作为监督微调语料,将论坛中已被采纳或提问者确认有效的解决帖组织为问答对,训练小型代码助手学习从问题诊断到给出可执行修复的回应模式。该数据集收录6,841条论坛问题及其解决答案,要求模型在细节充分时提供具体代码与修正建议,在信息不足时主动索取最小可复现代码或完整报错,而非凭空猜测。这种使用场景契合低资源、本地化部署的PyTorch辅助需求,也构成模型对齐论坛专业解答风格的核心训练路径。
实际应用
在工程实践层面,torchlight-threads所支撑的模型可嵌入本地开发环境、命令行助手或离线问答工具,面向PyTorch用户在张量设备查询、训练报错、梯度异常与模块调用等常见问题上提供简短修复建议。其轻量化特性适合在笔记本电脑或边缘设备运行GGUF量化版本,降低对云端API的依赖。用户亦可借助论坛检索工具获取历史线程,但该数据集训练出的模型更倾向直接回答或请求补充信息,因而适用于需要快速、离线、隐私敏感的调试支持场景。
衍生相关工作
以torchlight-threads为数据基础,相关经典工作包括torchlight-phi4-mini模型及其LoRA适配器与GGUF量化版本,后者使3.8B参数模型可在MacBook等设备上运行。该数据集还催生了配套评估流程,将微调模型与基座模型在有或无论坛搜索条件下进行对比,并考察错误答案比例、代码API真实性与澄清提问行为。论坛搜索工具以及数据抓取、清洗、构建和训练发布流程亦构成衍生组件,为后续在更大或更新基座模型上复现训练提供可操作范式。
以上内容由遇见数据集搜集并总结生成


