
D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_3arg__v1
收藏数据链接:
官方服务:
资源简介:
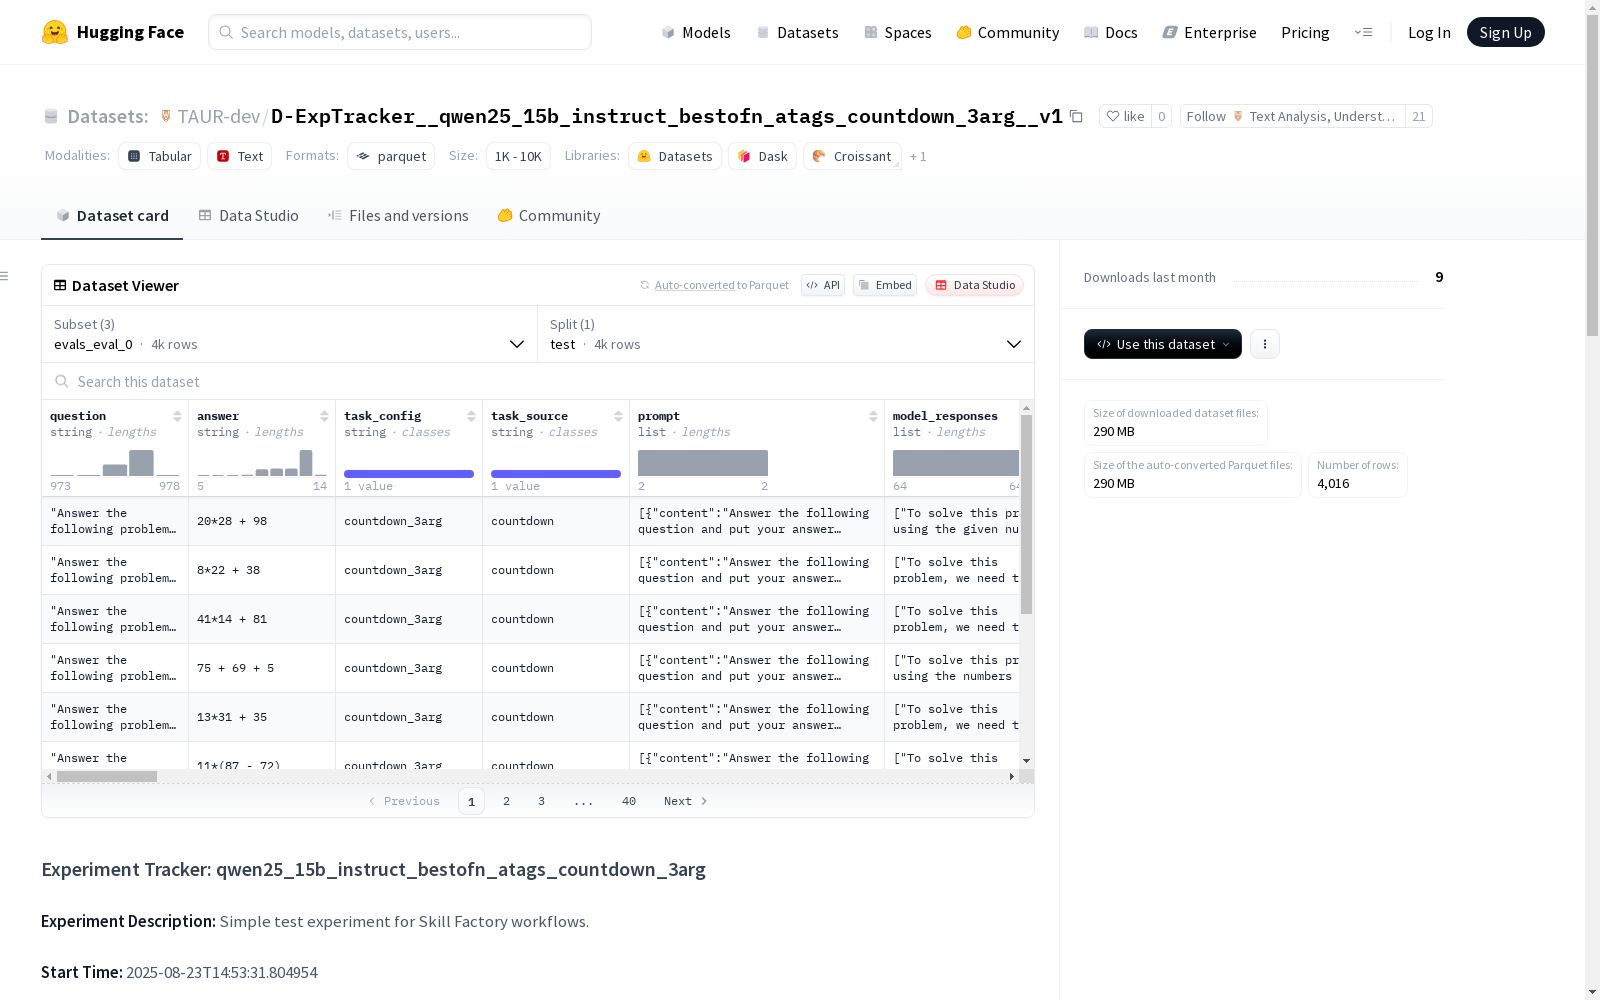
这是一个用于自然语言处理实验的评估数据集,包含了问题、答案、模型响应和评估结果等信息,以及实验的元数据和日志信息。
This is an evaluation dataset for natural language processing (NLP) experiments, which contains information including questions, answers, model responses, evaluation results, as well as experimental metadata and log information.
创建时间:
2025-08-24
原始信息汇总
数据集概述
基本信息
- 数据集名称: D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_3arg__v1
- 创建组织: TAUR-dev
- 实验开始时间: 2025-08-23T14:53:31.804954
- 实验描述: Simple test experiment for Skill Factory workflows
数据集配置
评估结果配置 (evals_eval_0)
- 测试集样本数量: 3998
- 测试集大小: 845189203 字节
- 下载大小: 290297022 字节
- 数据集总大小: 845189203 字节
主要特征:
- question (字符串): 问题内容
- answer (字符串): 答案内容
- task_config (字符串): 任务配置
- task_source (字符串): 任务来源
- prompt (列表): 提示内容,包含content和role字段
- model_responses (字符串序列): 模型响应
- model_responses__eval_is_correct (布尔序列): 模型响应正确性评估
- model_responses__best_of_n_atags (字符串序列): 最佳N个标签的模型响应
- model_responses__best_of_n_atags__eval_is_correct (布尔序列): 最佳N个标签的正确性评估
- model_responses__best_of_n_atags__metrics (结构体): 包含各种评估指标
日志配置 (logs__evaluation_eval_0)
- 训练集样本数量: 4
- 训练集大小: 38346 字节
- 下载大小: 21250 字节
- 数据集总大小: 38346 字节
主要特征:
- timestamp (字符串): 时间戳
- end_timestamp (字符串): 结束时间戳
- stage_name (字符串): 阶段名称
- stage_number (整型): 阶段编号
- level (字符串): 日志级别
- message (字符串): 日志消息
- stdout_content (字符串): 标准输出内容
- stderr_content (字符串): 标准错误内容
元数据配置 (metadata)
- 训练集样本数量: 14
- 训练集大小: 15832 字节
- 下载大小: 8744 字节
- 数据集总大小: 15832 字节
主要特征:
- experiment_name (字符串): 实验名称
- start_time (字符串): 开始时间
- description (字符串): 描述信息
- base_org (字符串): 基础组织
- stage_number (字符串): 阶段编号
- stage_type (字符串): 阶段类型
- status (字符串): 状态信息
数据文件结构
- evals_eval_0/test-*: 评估结果测试集数据文件
- logs__evaluation_eval_0/train-*: 日志训练集数据文件
- metadata/train-*: 元数据训练集数据文件
模型注册信息
所有实验模型自动注册在SkillFactory模型注册表中,包含完整的训练配置、实验谱系、阶段特定元数据和结构化输入数据引用。
搜集汇总
数据集介绍
构建方式
在人工智能模型评估领域,D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_3arg__v1数据集通过结构化实验追踪框架构建,采用多配置体系记录模型响应与评估数据。数据集整合了问题-答案对、任务配置元数据和模型生成轨迹,通过best-of-n采样策略收集多样化响应,并配备多层次评估标注体系,包括答案正确性判断、推理过程分析和答案提取元数据,确保数据构建的科学性与可追溯性。
使用方法
研究者可通过HuggingFace数据集库直接加载该数据集的不同配置模块,使用标准接口访问实验元数据、评估结果和日志信息。具体操作包括加载eval_0配置获取主要评估数据,查阅metadata了解实验时间线和阶段信息,或分析logs__evaluation_eval_0配置获取详细运行日志。数据集支持分模块加载,便于针对性地进行模型性能分析、错误模式研究和训练策略验证,为大规模语言模型评估提供标准化数据支持。
背景与挑战
背景概述
随着大语言模型在复杂推理任务中的广泛应用,评估模型多步推理能力成为自然语言处理领域的关键课题。D-ExpTracker__qwen25_15b_instruct_bestofn_atags_countdown_3arg__v1数据集由TAUR-dev团队于2025年构建,专门针对Qwen-25B模型在计数推理任务上的性能评估。该数据集通过结构化记录模型在最佳N采样策略下的响应轨迹,为研究大语言模型的推理一致性、答案修正能力和多步推理机制提供了重要实证基础,推动了可解释人工智能研究的发展。
当前挑战
该数据集致力于解决大语言模型在算术推理任务中存在的逻辑一致性挑战,特别是模型在多轮推理过程中出现的答案翻转现象。构建过程中面临多重技术难点:需要精确捕获模型响应序列中的元数据,设计能够追踪答案修订过程的评估框架,以及处理最佳N采样策略产生的高维度响应数据。同时需确保评估指标能有效量化模型的推理稳定性,这对数据标注的一致性和评估体系的科学性提出了极高要求。
常用场景
解决学术问题
该数据集有效解决了大语言模型评估中缺乏标准化测试框架的学术难题,通过提供带有精细标注的模型响应序列和评估指标,支持研究者深入分析模型在数学推理、逻辑判断等复杂任务中的性能瓶颈。其创新的多响应生成与评估机制为研究模型不确定性、响应一致性等前沿问题提供了数据基础,推动了语言模型评估方法论的发展。
实际应用
在实际应用层面,该数据集为AI系统开发提供了重要的质量监控参照,企业可依据其评估框架优化对话系统的响应策略。教育科技领域可借鉴其多轮交互评估方法构建智能辅导系统,而科研机构则利用其标准化测试流程加速模型迭代。其细粒度的错误分析数据尤其有助于提升AI系统在关键领域的可靠性。
数据集最近研究
最新研究方向
在大型语言模型评估领域,D-ExpTracker数据集聚焦于多轮对话系统的性能追踪与优化研究。当前前沿方向主要围绕最佳N采样策略的响应质量评估框架构建,通过结构化标注体系实现对模型推理过程的多维度量化分析。该数据集支持对思维链一致性、答案修订机制以及反射式学习能力的系统性评测,为构建具有自我修正能力的新一代对话模型提供关键数据支撑。相关研究正推动基于动态评估指标的模型迭代优化方法发展,对提升复杂任务场景下的语言模型鲁棒性具有重要实践意义。
以上内容由遇见数据集搜集并总结生成


