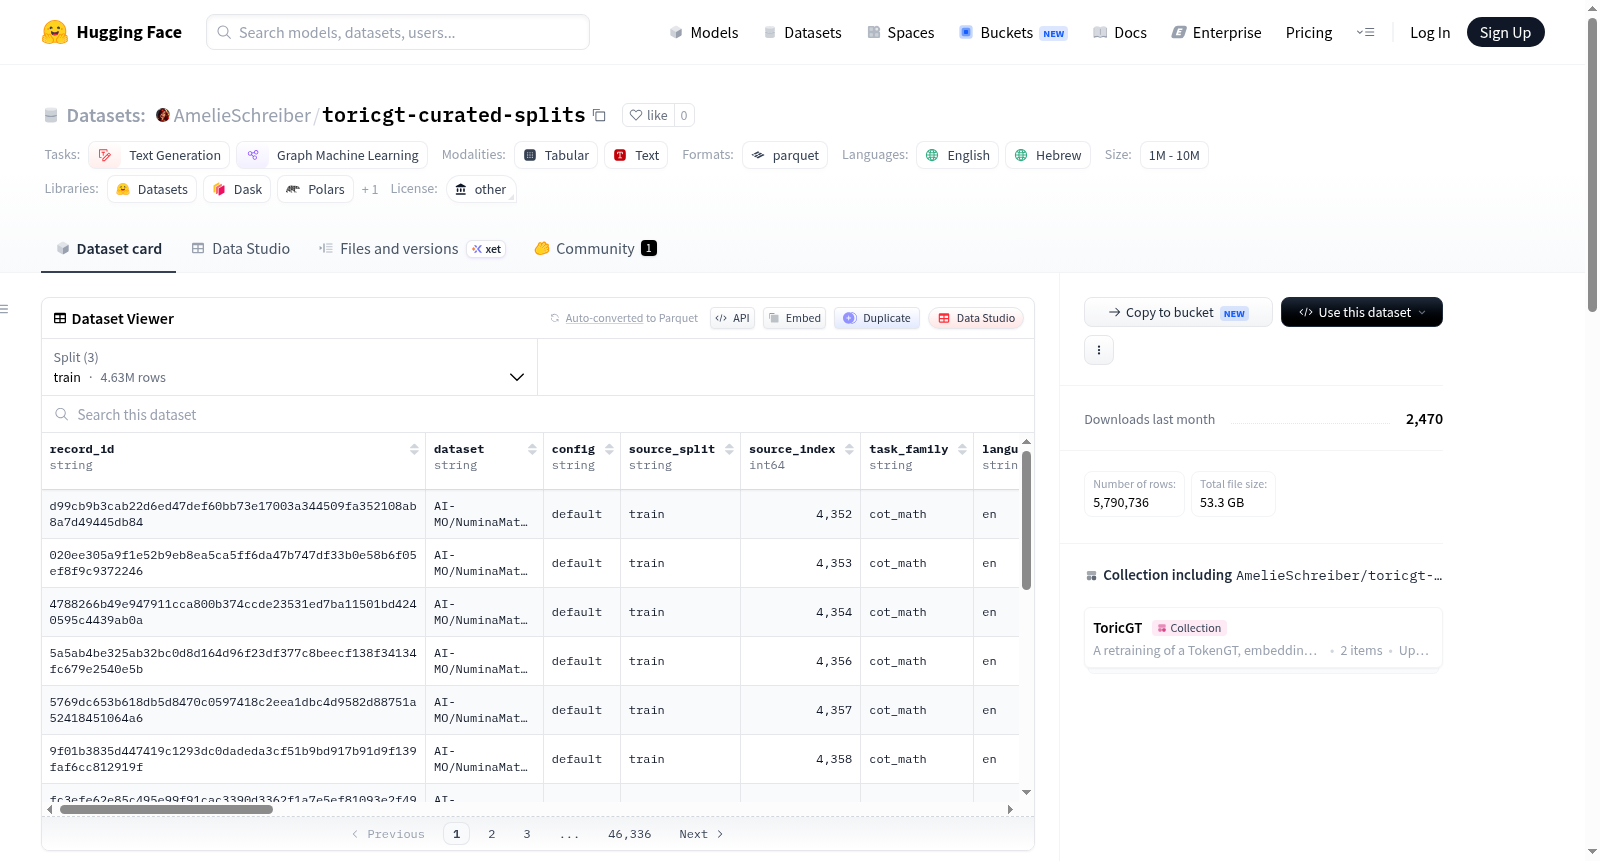
AmelieSchreiber/toricgt-curated-splits
收藏资源简介:
ToricGT精选图推理分割数据集是一个用于图推理的精选工作数据集,专门为ToricGT项目设计。该数据集包含从Sefaria和UniMorph Hebrew来源获取的希伯来语/犹太文本记录,以Parquet文件格式提供训练、验证和测试分割,以及元数据文件如清单和报告。数据集总共有5,790,736行,其中训练集4,633,582行,验证集578,319行,测试集578,835行。希伯来语行保留了原始的点符(niqqud)信息,未加点符的文本被标记以便过滤或后续恢复。这是一个混合来源的研究数据集,使用时需保留属性列并检查上游许可证。
# ToricGT 精选图推理数据集划分 <p align="center"> <a href="./assets/toricgt_paper_pg_softmoe_final.tex"><img src="https://img.shields.io/badge/arXiv-94133F?style=for-the-badge&logo=arxiv" alt="arXiv"/></a> <a href="https://github.com/amelie-iska/ToricGT/"><img src="https://img.shields.io/badge/📝%20GitHub-007A87?style=for-the-badge&logoColor=grey" alt="GitHub"/></a> <a href="https://huggingface.co/blog/AmelieSchreiber/toricgt"><img src="https://img.shields.io/badge/HuggingFace-DE9B35.svg?style=for-the-badge&logo=HuggingFace" alt="HuggingFace"/></a> </p> --- 许可证:其他 任务类别: - 文本生成 - 图机器学习(Graph ML) 语言: - 英语 - 希伯来语 展示名称:ToricGT 精选图推理数据集划分 --- 本仓库为ToricGT的精选工作数据集仓库。 本次上传仅包含经精选的划分格式Parquet文件与本地生成的元数据,未上传原始上游数据源。每一行数据均保留源数据集、许可证、划分方式、哈希值与用于审计的图JSON字段。 希伯来语/犹太文本记录源自Sefaria与UniMorph希伯来语数据源。 ## 文件列表 - `train.parquet`:训练集文件 - `validation.parquet`:验证集文件 - `test.parquet`:测试集文件 - `all.parquet`:若使用`--include-all`参数则包含全量数据集文件 - `manifest.json`:清单文件 - `split_report.json`:划分报告文件 - `split_report.md`:划分说明文档 - `niqqud_report.json`:尼库德(Niqqud)标记报告文件 ## 划分统计 - 仓库地址:`AmelieSchreiber/toricgt-curated-splits` - 总数据行数:`5790736` - 训练集行数:`4633582` - 验证集行数:`578319` - 测试集行数:`578835` ## 希伯来语尼库德标记策略 源自希伯来语/犹太文本的行将保留原始数据源中的尼库德(Niqqud,希伯来语元音标记)标记(若存在)。默认情况下,本精选流程不会为无标记的源文本人工添加元音;无元音标记的希伯来语文本将被标记,以便后续过滤或经审核后恢复标记。 - 希伯来语数据行:`3564756` - 带尼库德标记的希伯来语数据行:`2868` - 原始无标记希伯来语数据行:`3561888` - 若需严格筛选带完整尼库德标记的希伯来语数据,请过滤`quality_flags_json`中`has_hebrew_without_niqqud=true`的行。 ## 许可证说明 本数据集为多源混合的研究数据集。在将模型用于再分发前,请保留原数据的署名列,并核查上游数据源的许可证条款。若下游发布存在条款约束,需单独处理采用GPL许可证及相同共享协议的数据源。