
Synthyra/PDB-Monomeric-Structure-ESMFold2
收藏官方服务:
资源简介:
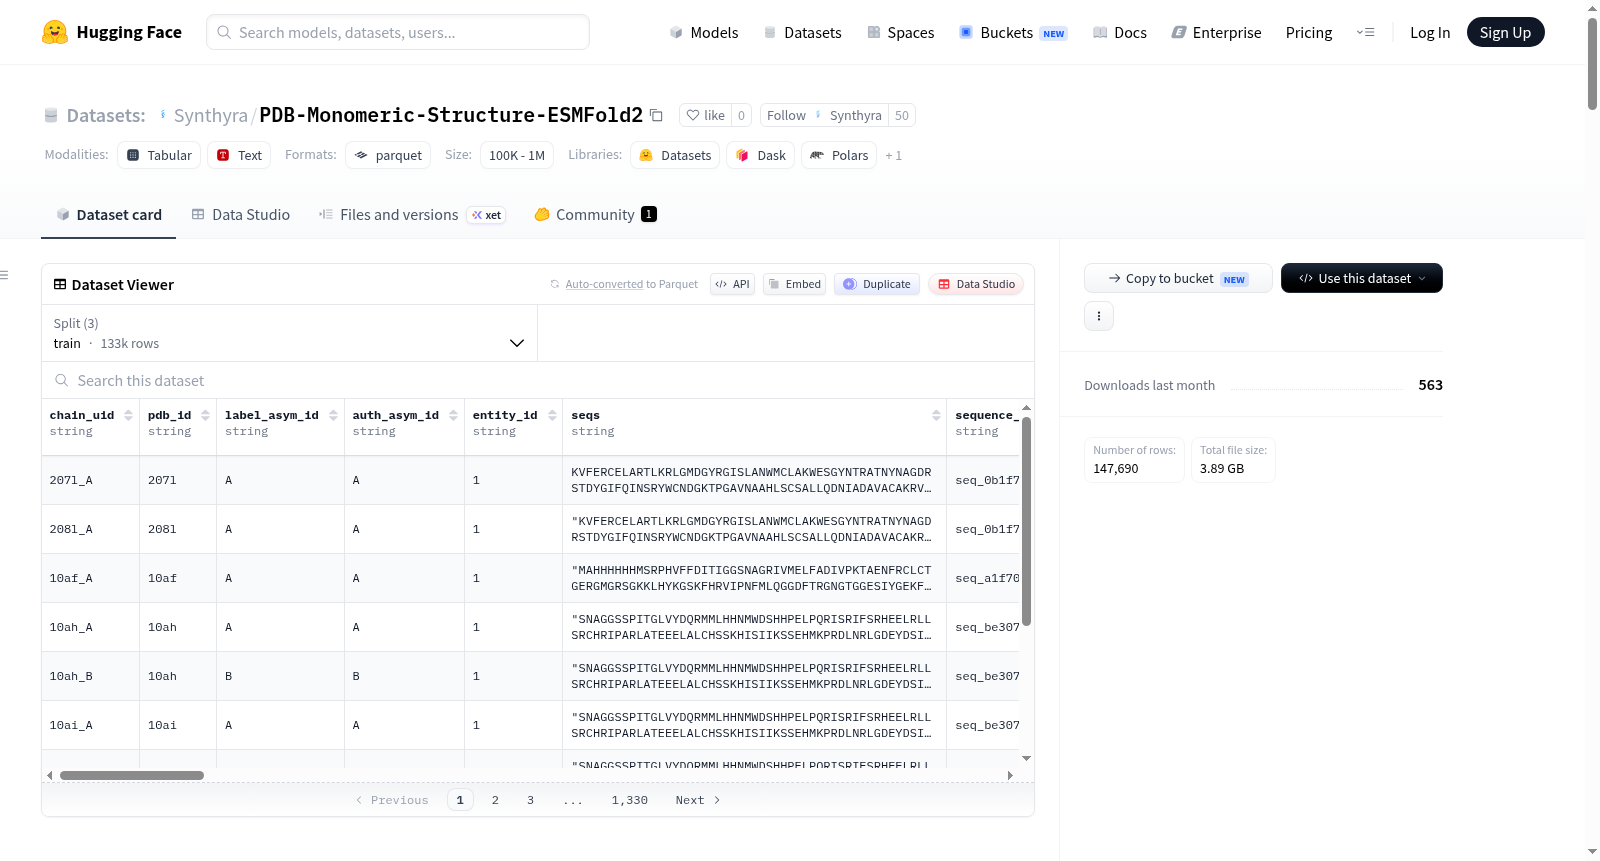
PDB-Monomeric-Structure-ESMFold2是一个单体、仅包含蛋白质的PDB结构数据集,专为最小ESMFold2风格训练而设计。每行数据代表一个符合条件的单链生物组装体,包含规范氨基酸序列输入和`atom37`格式的全原子蛋白质标签。
The PDB-Monomeric-Structure-ESMFold2 is a PDB structure dataset containing only monomeric protein structures, designed specifically for minimal-style training of ESMFold2. Each entry in the dataset represents an eligible single-chain biological assembly, containing canonical amino acid sequence inputs and all-atom protein labels in the `atom37` format.
提供机构:
Synthyra搜集汇总
数据集介绍
构建方式
该数据集基于蛋白质数据银行(PDB)中的单体蛋白质结构构建,专注于仅包含蛋白质的单链生物组装体。每条数据记录对应一个符合标准的单链结构,输入为规范的氨基酸序列,输出为全原子级别的蛋白质结构标签,采用atom37格式存储。构建过程严格排除了配体、水分子、离子、核酸、不支持原子、多重序列比对(MSA)以及AFDB蒸馏数据,确保数据纯净。数据集划分采用多重约束策略,通过精确序列重复分组、30% MMseqs2序列聚类、Foldseek结构聚类、PDB ID及生物组装归属的连接组件进行分裂,并在上传前验证无泄漏,最终形成训练集132922条、验证集7384条和测试集7384条。
特点
该数据集的核心特点在于其专为ESMFold2风格的最小化训练而设计,支持从解析的原子坐标和掩码中推导多种损失函数,包括扩散均方误差、平滑局部距离差异测试(smooth LDDT,截断距离15埃)、距离直方图(64个区间,范围2-22埃)以及分辨率/pLDDT、预测对齐误差和预测距离误差等置信度损失。所有标签均以全原子坐标和掩码形式提供,包含残基级的位置信息、掩码以及实验元数据如分辨率、R因子和释放日期。数据集规模庞大,包含147690条结构记录和约4485万残基,并通过多层级的泄漏断言确保训练、验证和测试集之间无序列或结构信息泄露。
使用方法
该数据集可直接通过HuggingFace Datasets库加载,使用配置文件'structures',并支持按训练、验证和测试集分别访问。用户可利用提供的atom37_positions、atom37_mask等标签进行蛋白质结构预测模型的训练与评估。数据集设计支持在数据整理器(collator)中推导ESMFold2风格的扁平原子列表张量,便于实现多种损失函数。建议结合ESMFold2模型框架使用,并参考预印本及Biohub ESM仓库中的相关工具和文档。由于数据为纯蛋白质单体结构,适合用于研究蛋白质折叠、结构预测及基于结构的深度学习任务。
背景与挑战
背景概述
蛋白质结构预测是计算生物学领域的核心挑战之一,深度学习方法在该领域取得了突破性进展。PDB-Monomeric-Structure-ESMFold2数据集由Synthyra团队于2026年创建,旨在为ESMFold2模型提供最低限度的训练支持。该数据集基于蛋白质数据库(PDB),严格筛选仅包含单体蛋白质的单链生物组装体,去除了配体、水分子、离子、核酸等非蛋白质成分。数据集共包含147,690个结构条目,涵盖4480万个残基,通过严格的序列和结构聚类策略(如MMseqs2和Foldseek)划分为训练、验证和测试集,确保了数据无泄漏。该数据集的核心研究问题是为ESMFold2模型提供标准化、高质量的训练数据,支持扩散均方误差、平滑LDDT、分布图、pLDDT、PAE和PDE等损失函数的计算,对推动蛋白质结构预测的精度和泛化能力具有重要意义。
当前挑战
该数据集所解决的领域问题包括:1)蛋白质结构预测中训练数据的标准化缺失,现有数据往往混杂非蛋白质成分,影响模型对蛋白质本身结构的学习;2)构建过程中面临的数据泄漏风险,需通过多层级聚类(精确序列重复组、30%序列簇、Foldseek结构簇、PDB ID和生物组装体)严格划分数据集,确保不同分集之间无重叠;3)处理PDB中异构数据(如不同分辨率、实验方法)的整合与清洗,需统一为atom37格式,并对缺失原子进行填充与掩码处理;4)大规模数据处理效率的提升,数据集构建使用30个CPU核,分片大小为1000行,通过并行化处理保证生成速度;5)实验元数据的完整记录,包括分辨率、R因子、实验方法等,为模型评估提供可追溯的参考标准。
常用场景
经典使用场景
在蛋白质结构预测领域,PDB-Monomeric-Structure-ESMFold2 数据集是训练和评估端到端深度学习模型的基石。它专门为 ESMFold2 风格的最小训练而设计,提供了经过严格筛选的单链蛋白质生物组装结构。每个数据条目均包含规范氨基酸序列作为输入,以及完整的全原子坐标(atom37格式)和掩码,支持结构预测中的多种监督学习任务。研究人员可直接利用该数据集训练从序列到三维坐标的映射模型,验证模型在单体蛋白质结构复原上的能力,或作为预训练语料库,为下游任务如结构比对、功能预测提供初始化的权重。其经过精心划分的训练、验证和测试集确保了实验的可重复性和公平性。
解决学术问题
该数据集有效解决了蛋白质结构预测研究中数据质量与数据泄漏的顽疾。通过严格的拆分策略——基于精确序列重复、30% MMseqs2序列聚类、Foldseek结构聚类以及PDB ID等多维度的互联组件划分,确保了训练与测试集间不存在同源或结构相似性泄漏。数据集剔除了配体、离子、核酸等非蛋白质成分,聚焦于纯粹的蛋白质结构学习,避免了多余信息对模型的干扰。它还提供了包括分辨率、R因子在内的元数据,使得研究者能够深入分析不同实验条件下模型表现的变化。这一规范化的数据构建体系为公正评估模型泛化能力奠定了坚实基础,提升了学术研究结论的可信度和可复现性。
衍生相关工作
围绕 PDB-Monomeric-Structure-ESMFold2 数据集,衍生出了一系列具有深远影响的经典工作。首先是 ESMFold2 模型本身,其利用该数据集进行训练,在单体蛋白质结构预测任务上取得了媲美 AlphaFold2 的性能,同时显著提升了推理效率,推动了大规模蛋白质组学结构预测的实现。其次,该数据集为开发新的置信度评估模块提供了基准,如衍生的平滑 LDDT、pLDDT、PAE 等损失函数的合理构造,促进了模型对自身预测可靠性的判断能力。在结构聚类和序列与结构对比分析方面,基于该数据集的 Foldseek 聚类信息被广泛应用于探索蛋白质空间的多样性。此外,零样本学习和迁移学习等前沿方法也借由该数据集验证了其在蛋白质结构预测领域的有效性,持续催生着该方向的创新进展。
以上内容由遇见数据集搜集并总结生成


