
NyanNyanovich/nyan_documents
收藏官方服务:
资源简介:
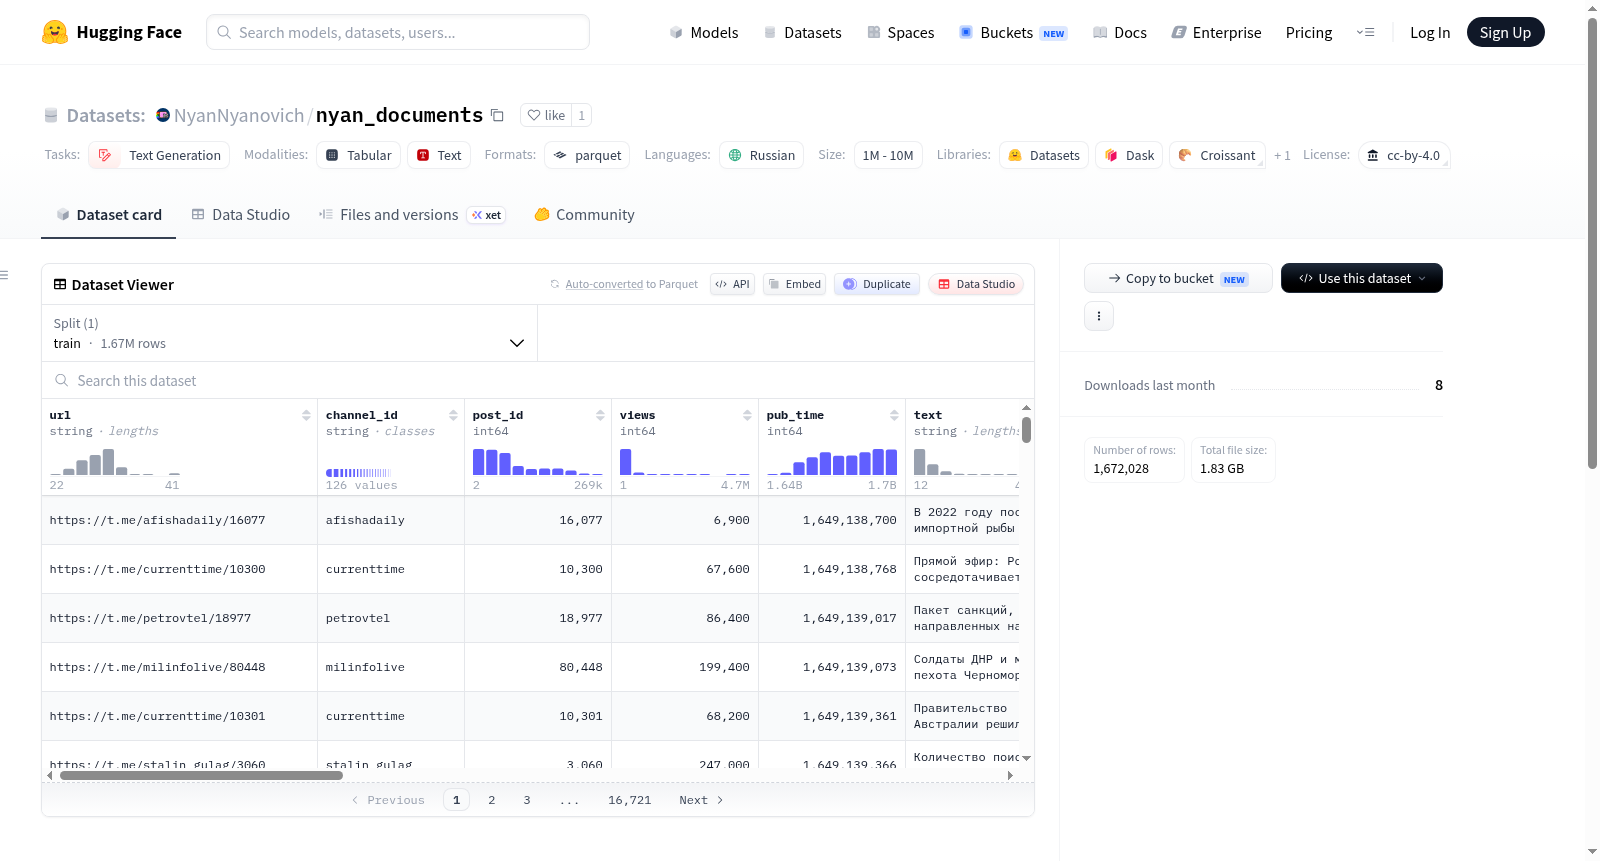
Nyan documents数据集是从2022年3月到2023年12月期间从[НЯН](https://t.me/nyannews) Telegram频道抓取的文档。该数据集包括来自100多个不同Telegram新闻频道的文档。
The Nyan documents dataset consists of documents scraped from the [НЯН](https://t.me/nyannews) Telegram channel between March 2022 and December 2023. This dataset includes documents from over 100 distinct Telegram news channels.
提供机构:
NyanNyanovich原始信息汇总
数据集概述
数据集信息
特征
- url: 字符串类型
- channel_id: 字符串类型
- post_id: 64位整数类型
- views: 64位整数类型
- pub_time: 64位整数类型
- text: 字符串类型
- fetch_time: 64位整数类型
- images: 字符串序列
- links: 字符串序列
- videos: 字符串序列
- reply_to: 字符串类型
- forward_from: 字符串类型
- channel_title: 字符串类型
- has_obscene: 布尔类型
- patched_text: 字符串类型
- groups: 结构体类型,包含以下字段:
- economy: 字符串类型
- main: 字符串类型
- tech: 字符串类型
- issue: 字符串类型
- language: 字符串类型
数据分割
- train: 包含3,508,000,056字节,1,672,028个样本
数据集大小
- 下载大小: 1,827,333,867字节
- 数据集大小: 3,508,000,056字节
许可证
- cc-by-4.0
任务类别
- text-generation
语言
- ru
数据集名称
- Nyan Documents
数据集规模
- 1M<n<10M
搜集汇总
数据集介绍
构建方式
该数据集源自对Telegram新闻频道的系统性爬取,覆盖超过100个俄语新闻频道,时间跨度从2022年3月至2023年12月。数据采集过程中,每条记录均包含原始文本、发布时间、浏览量等结构化字段,并经过脱敏处理以去除不当内容。此外,数据集还通过标注经济、科技等主题分组及语言类别,实现了多维度的信息组织,最终形成一个包含约167万条样本的语料库。
使用方法
用户可通过HuggingFace的datasets库直接加载该数据集,推荐使用流式模式以应对其数GB的存储体积。加载后,每条数据以字典形式呈现,包含文本、时间戳及结构化标签。适用于文本生成模型的预训练与微调,亦可结合分组字段进行主题分类或时序分析。数据采用CC-BY-4.0许可,允许学术与商业用途的灵活调用。
背景与挑战
背景概述
在自然语言处理与新闻分析领域,大规模、多源且带有元数据的文本语料库是推动模型训练与舆情研究的基础。NyanNyanovich/nyan_documents数据集由НЯН团队于2022年3月至2023年12月期间构建,旨在为俄语Telegram新闻频道的内容挖掘提供结构化资源。该数据集收录了超过167万篇文档,涵盖100余个不同Telegram新闻频道的帖子,并附有频道标识、发布时间、浏览量、文本内容及图像、链接、视频等多元信息。其核心研究问题聚焦于如何从碎片化的社交媒体新闻中提取可分析的文本与话题结构,尤其适用于文本生成、主题建模及跨模态学习任务。作为俄语新闻领域少有的公开大规模数据集,它为低资源语言下的社会事件追踪与信息传播研究提供了重要支撑,对理解东欧地区数字新闻生态具有显著影响力。
当前挑战
该数据集面临的挑战主要体现在两个层面。首先,在领域问题层面,Telegram新闻数据具有高度非结构化与噪声性,文本中常混入表情符号、非标准缩写及广告内容,且多源频道间的报道视角差异显著,给统一的文本生成与主题聚类带来困难。其次,在构建过程中,数据爬取时间跨度长达二十一个月,需应对频道内容动态变化与API访问限制,确保数据采集的连续性与完整性。此外,数据集中包含的obscene标记与patched_text字段虽尝试缓解内容合规性风险,但跨语言亵渎词识别与敏感信息脱敏仍需持续优化,而处理1M至10M规模样本时的存储与流式加载效率亦是技术瓶颈。
常用场景
经典使用场景
在俄语自然语言处理与新闻文本分析领域,NyanNyanovich/nyan_documents数据集以其丰富的时间跨度和多源异构特性,成为研究社交网络信息传播与文本生成任务的重要资源。该数据集收录了2022年3月至2023年12月间,来自超过100个Telegram新闻频道的逾167万条文档,涵盖文本、图片、链接及视频等多模态信息。经典使用场景包括基于自回归语言模型的俄语新闻文本生成、面向低资源语言的预训练语料构建,以及针对Telegram生态的社交内容分析与话题聚类。研究者可借助其结构化的频道元数据与时间戳,探索信息在俄语社交网络中的扩散模式与演化规律。
解决学术问题
数据集的核心学术价值在于解决了俄语社交新闻语料匮乏与多标签分类体系缺失的困境。其内置的经济、科技与主题分组标签,为细粒度的多标签文本分类与跨领域迁移学习提供了基准。同时,通过标记是否包含不当内容的布尔字段与经过清洗的补丁文本,研究者可深入探讨社交平台内容审核中的文本去噪与敏感信息过滤问题。该数据集还支持对Telegram频道的传播影响力进行量化分析,例如基于浏览量、回复关系与转发链的社交网络结构研究,从而揭示信息在封闭社群中的级联传播机制。
实际应用
实际应用层面,该数据集直接服务于俄语新闻聚合平台的内容推荐系统,通过分析频道标题、话题分组与用户互动数据,构建个性化新闻推送模型。媒体监测机构可利用其多源文档,实时追踪特定议题(如地缘政治或技术动态)在俄语Telegram生态中的情感倾向与舆情演变。此外,数据集中的图像与链接字段为多模态新闻摘要生成提供对齐数据,辅助开发面向俄语用户的智能信息简报工具,提升信息获取效率。
数据集最近研究
最新研究方向
在俄语社交媒体分析领域,NyanNyanovich/nyan_documents数据集为Telegram新闻频道的内容挖掘与多标签分类研究提供了重要支撑。该数据集收录了2022年3月至2023年12月期间来自100多个俄语Telegram新闻频道的逾167万条文档,涵盖经济、技术与综合三大主题类别,并标注了粗俗内容标识与语言类型。当前前沿研究集中于利用该数据集训练大规模语言模型,以捕捉俄语网络舆论中的动态主题演化与跨频道信息扩散模式。尤其在俄乌冲突持续发酵的背景下,该数据集成为分析Telegram平台信息传播机制、识别虚假新闻与极端言论的关键资源,推动了多语言社交媒体文本生成与舆情监测技术的迭代发展。其CC-BY-4.0许可协议更促进了学术社区在低资源语言自然语言处理任务上的协作创新。
以上内容由遇见数据集搜集并总结生成


