
遇见数据集

shivendrra/consolidated-datasets

收藏
Hugging Face2024-12-12 更新2024-06-22 收录
官方服务:

资源简介:

该数据集名为YouTubeTranscriptData,包含了大约167K个YouTube视频的转录文本,这些视频涵盖了编码讲座、播客、访谈、新闻视频、评论和歌词等多种类型。数据集通过网页抓取生成,适用于训练Transformer模型/BPE分词器,以及学习和研究目的。数据集由Shivendra Singh策划,未提及具体许可证。数据集来源包括YouTube视频和Britannica.com的文章,数据收集和处理使用了YouTube V3 API和Youtube Transcript API。

该数据集名为YouTubeTranscriptData,包含了大约167K个YouTube视频的转录文本,这些视频涵盖了编码讲座、播客、访谈、新闻视频、评论和歌词等多种类型。数据集通过网页抓取生成,适用于训练Transformer模型/BPE分词器,以及学习和研究目的。数据集由Shivendra Singh策划,未提及具体许可证。数据集来源包括YouTube视频和Britannica.com的文章,数据收集和处理使用了YouTube V3 API和Youtube Transcript API。

提供机构:
shivendrra
原始信息汇总

数据集卡片 for YouTubeTranscriptData

数据集详情

数据集描述

该数据集包含约167K个YouTube视频的转录文本,包括编程讲座、播客、采访、新闻视频、评论和歌词。还包括通过网络爬虫生成的多个文件。

数据集来源

用途

  • 可用于训练Transformer模型/BPE分词器
  • 也可用于学习和研究目的
  • 适用于从头开始训练NLP和基础模型

直接用途

用于训练一个7600万参数的Transformer模型。

超出范围的用途

不适合用于微调任何基础模型或预训练模型。仅适用于从头开始训练NLP和基础模型。

数据集结构

待添加微调数据后更新此部分。

数据集创建

创建理由

我想要创建一个应用程序,帮助我为我的YouTube视频编写脚本。我尝试了一些gpt-3.5微调和langchain,以及YouTube/Google API,并有了一个自己从头开始训练模型的想法。

源数据

YouTube视频:

  • 播客如Lex Fridman、Waveform、Joe Rogan、vergecast、比尔·盖茨等。
  • 来自candaian lad、aevy tv、SNL、lemmino、mrwhosetheboss、johnny harris等的视频。
  • 来自vox、wallstreetjournal、newyorktimes、the guardian等的新闻视频。
  • 来自variety、wired、y-combinator、eo等的采访。
  • 来自mit opencourseware、cs50、freecodecamp、crashcourse等的讲座。
  • 来自kurzgesagt、real engineering、arvin ash、vsause、veritasium等的技术和科学视频。

Britannica.com:

  • 关于Covid、核反应、南极洲、诺贝尔奖、伟大领袖、国家等的文章。

数据收集和处理

使用Youtube V3 API从特定YouTube频道获取视频ID并生成目标URL。然后使用Youtube Transcript API从视频中获取转录文本并写入.txt文件。 创建了一个包含约45个频道ID的json文件,并从约167K个视频中获取转录文本。

通过网络爬虫从britannica.com和GoogleCustomSearch API获取的一些网站中抓取数据。
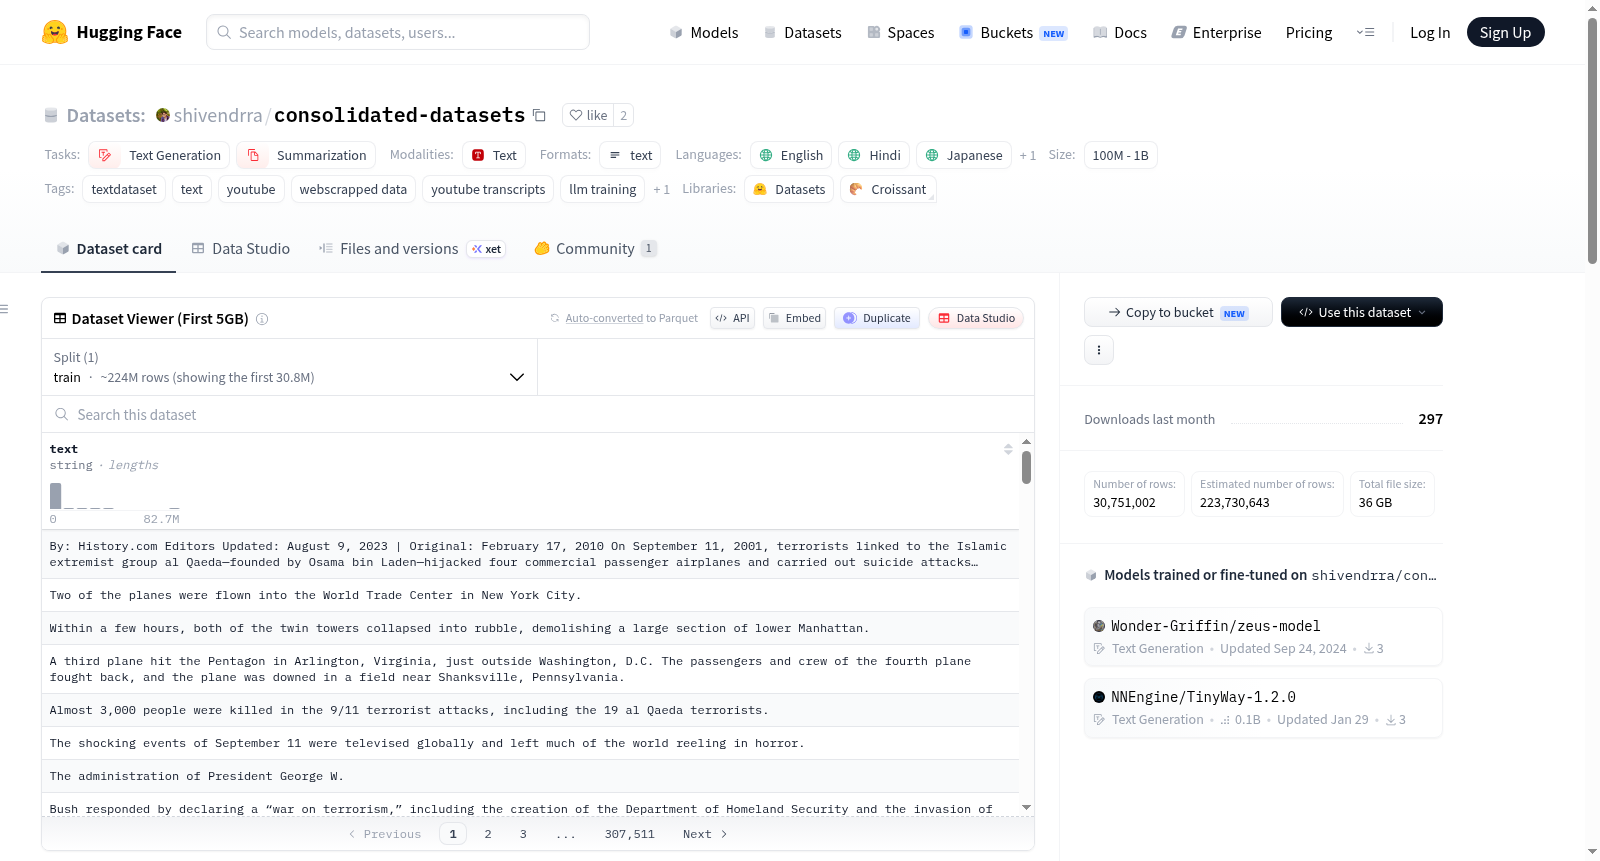
搜集汇总
数据集介绍
shivendrra/consolidated-datasets 数据集图片
构建方式
该数据集由Shivendra Singh独立构建,旨在为从头训练语言模型提供大规模文本语料。数据主要来源于两大渠道:一是利用YouTube V3 API获取约45个频道的视频ID,再通过YouTube Transcript API提取约167K个视频的字幕文本,涵盖编程讲座、播客、访谈、新闻评论、歌曲歌词等内容;二是通过网页爬虫从Britannica.com及其他由Google Custom Search API获取的网站采集文章。所有原始文本被整理为.txt文件,最终汇聚成此多源异构的文本集合。
特点
数据集规模介于1亿至100亿token之间,涵盖英语、印地语、日语、法语等多种语言,具备显著的多样性与跨领域特性。其内容不仅包含高质量的教育类讲座(如MIT OpenCourseWare、CS50)和科普视频(如Kurzgesagt、Veritasium),还融合了主流媒体文章与播客转录,适合用于训练Transformer模型或BPE分词器。数据集未经过滤,保留了原始转录的噪声特征,更贴近真实自然语言分布,特别适用于从零开始的预训练任务。
使用方法
该数据集主要面向自然语言处理研究者和开发者,支持文本生成与摘要等任务。推荐直接加载原始.txt文件进行模型预训练,或用于训练自定义BPE分词器。用户可通过Hugging Face Datasets库加载数据,示例代码为`from datasets import load_dataset; dataset = load_dataset("shivendrra/consolidated-datasets")`。需注意,该数据集不适用于微调已有预训练模型,且未提供官方划分的训练/验证集,使用者需自行处理数据分割。详细构建流程可参考作者在Medium上的技术博客。
背景与挑战
背景概述
在自然语言处理领域,大规模、多样化的文本语料库是训练高效语言模型的基础。shivendrra/consolidated-datasets数据集由研究人员Shivendra Singh于近期创建,旨在为从零开始训练Transformer模型及BPE分词器提供原始文本资源。该数据集整合了约16.7万条YouTube视频转录文本,涵盖编程讲座、播客、访谈、新闻评论及歌词等多类内容,并辅以从Britannica.com等网站爬取的文本数据。其核心研究问题在于探索如何利用公开可得的视频转录与网页数据构建轻量级语言模型,而非依赖预训练模型进行微调。尽管该数据集规模相对有限,但其开放的构建思路为小规模语言模型的研究提供了实践参考,尤其适用于资源受限场景下的模型开发与教学演示。
当前挑战
该数据集面临的核心挑战体现在多个层面。首先,在领域问题层面,数据集主要服务于文本生成与摘要任务,但转录文本的噪声(如口语化表达、自动语音识别误差)可能影响模型的语言建模质量,且缺乏对文本连贯性与语义准确性的严格过滤。其次,在构建过程中,数据收集依赖YouTube V3 API和转录API,面临视频内容版权不确定性及API调用限制的挑战;网页爬取数据则需处理不同站点的结构差异与反爬机制。此外,数据集未提供明确的标注信息或任务划分,限制了其在监督学习场景下的直接应用,且缺乏对多语言数据(如英语、印地语、日语等)的均衡性与质量评估,可能引入语言偏倚。
常用场景
经典使用场景
该数据集整合了约16.7万条YouTube视频字幕与网页抓取文本,覆盖编程讲座、播客访谈、新闻评论、歌曲歌词及百科全书条目等多模态语料。其经典使用场景在于为自然语言处理领域提供大规模、多语种(英语、印地语、日语、法语)的原始文本资源,尤其适合从头训练Transformer架构的语言模型或字节对编码(BPE)分词器。通过汇聚高质量、多样化的口语与书面语素材,该数据集为构建轻量级基础语言模型提供了坚实的数据基石,推动了低资源场景下小参数规模模型的自主训练与学术探索。
实际应用
在实际应用中,该数据集最直接的价值在于赋能个人开发者与小型研究团队自主训练定制化语言模型。例如,可用于构建专注于技术内容生成、播客摘要或教育辅助的轻量级AI助手。其多语种特性使得跨语言文本生成与基础翻译模型的预训练成为可能。此外,数据集中的字幕文本为视频内容索引、自动剪辑脚本生成等多媒体应用提供了训练资源。通过降低对大型商业模型和昂贵计算资源的依赖,该数据集推动了语言技术在个性化创作、在线教育及信息检索等场景中的民主化落地。
衍生相关工作
该数据集衍生的经典工作包括基于其训练的7600万参数Transformer模型(SmallLanguageModel项目),该工作探索了在有限计算资源下从零构建语言模型的完整流程。相关研究可延伸至小型模型的知识蒸馏、多任务学习以及低资源语言建模。该数据集还催生了关于YouTube字幕数据预处理、噪声过滤及领域适配的系列方法论,例如如何从口语化转录文本中提取结构化知识。此外,其开源性质鼓励了社区对数据混合策略、分词器效率优化等课题的复现与改进,为后续构建更大规模、更高覆盖度的多源文本语料库提供了参照范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

