
MightyStudent/Egyptian-ASR-MGB-3
收藏官方服务:
资源简介:
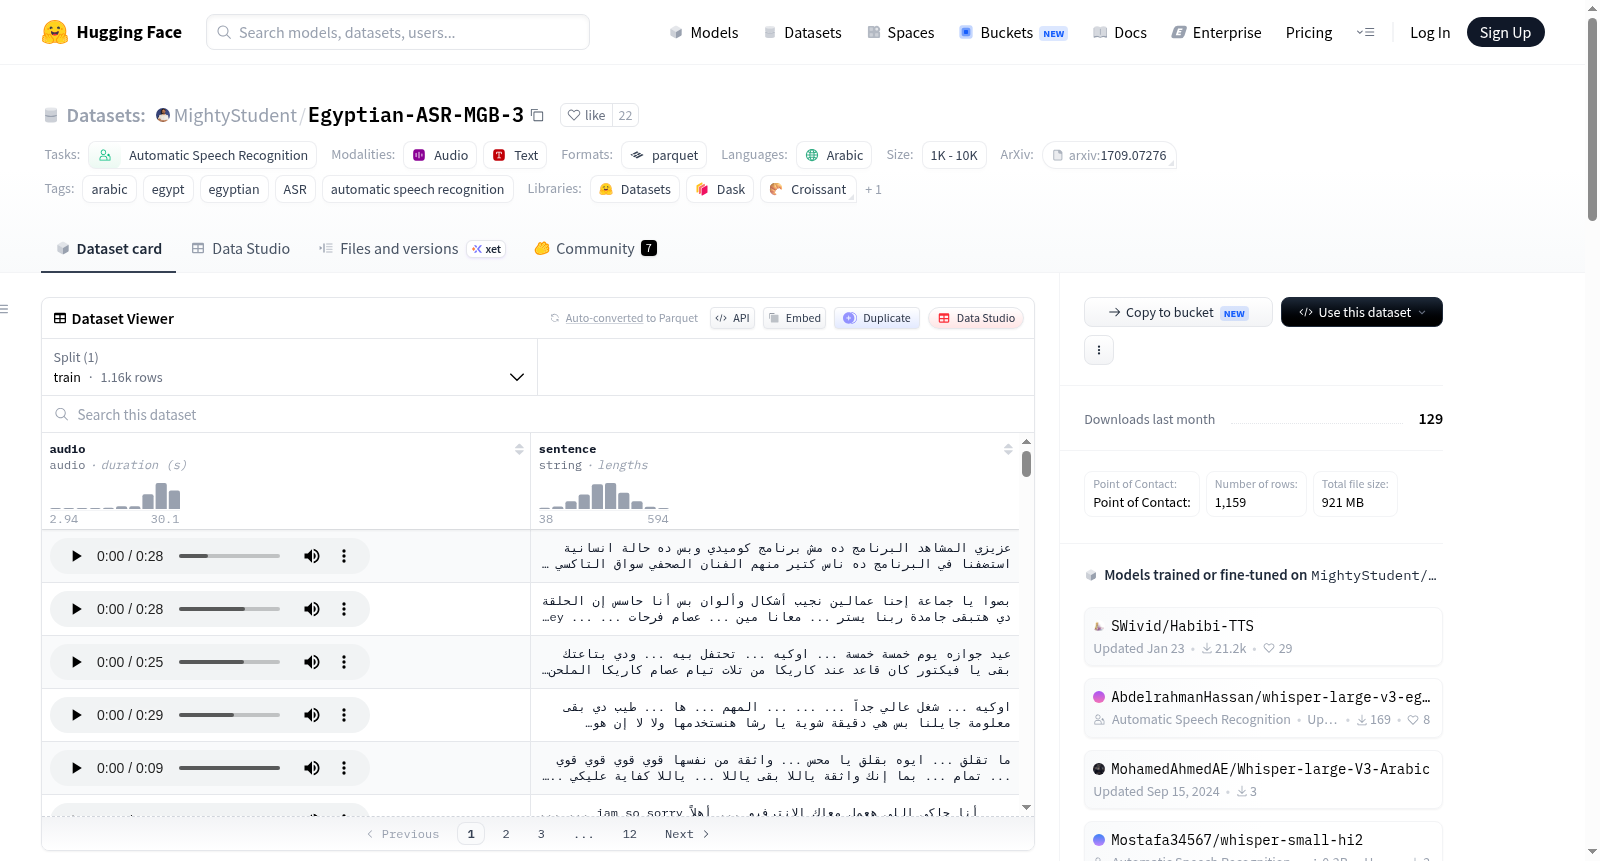
该数据集是为埃及阿拉伯方言自动语音识别任务而收集、清理和调整的,适用于Whisper模型的微调/训练。数据集包含音频和句子两个主要特征,音频采样率为16000Hz,句子为埃及阿拉伯语的转录。数据集是从YouTube视频中收集的,每个视频的前12分钟被切割成30秒的片段。数据集支持自动语音识别任务,语言为埃及阿拉伯语。数据集的来源包括MGB挑战网站和YouTube。
该数据集是为埃及阿拉伯方言自动语音识别任务而收集、清理和调整的,适用于Whisper模型的微调/训练。数据集包含音频和句子两个主要特征,音频采样率为16000Hz,句子为埃及阿拉伯语的转录。数据集是从YouTube视频中收集的,每个视频的前12分钟被切割成30秒的片段。数据集支持自动语音识别任务,语言为埃及阿拉伯语。数据集的来源包括MGB挑战网站和YouTube。
提供机构:
MightyStudent原始信息汇总
数据集概述
基本信息
- 数据集名称: Egyptian Arabic dialect automatic speech recognition
- 数据集大小: 1K<n<10K
- 任务类别: automatic-speech-recognition
- 语言: Arabic - Egyptian dialect
数据字段
- audio: 采样率为16000Hz,最大时长30秒。
- sentence: 埃及阿拉伯语的转录文本。
数据集创建
- 源数据: 来自YouTube的视频,部分视频已被删除或设为私有。
- 数据处理: 从每个YouTube视频中截取前12分钟,切割成30秒的片段,上传至huggingface。
数据集用途
- 主要用途: 用于whisper微调/训练,适用于自动语音识别模型。
数据集来源
- 数据收集: 从YouTube收集约80个不同频道的节目,总计约16小时。
- 转录过程: 每个节目由四名转录员根据转录指南进行手动转录。
搜集汇总
数据集介绍
构建方式
在阿拉伯语方言语音识别领域,埃及阿拉伯语因其广泛使用而备受关注。MightyStudent/Egyptian-ASR-MGB-3数据集源自MGB-3挑战赛,基于从YouTube收集的约80个埃及电视节目,每个节目截取前12分钟进行人工转写,总计约16小时的多体裁语音数据。为确保转录质量,每个节目由四名不同转写员依据统一指南完成,以应对阿拉伯方言缺乏正字法规则的挑战。随后,仍可访问的YouTube视频被下载并与转录同步,将每段12分钟的内容切割为不超过30秒的音频片段,最终整理成适配HuggingFace格式的数据集,便于直接用于Whisper等模型的微调训练。
特点
该数据集聚焦于埃及阿拉伯语方言,具有鲜明的领域特色。音频全部以16kHz采样率标准化,时长限制在30秒以内,完美契合Whisper等主流语音识别模型的输入要求。数据来源涵盖多种电视节目类型,体现了多体裁特性,有助于提升模型的泛化能力。每段音频均配有对应的文本转录,字段简洁清晰。数据集规模介于1000至10000条之间,虽有限但经过精心清洗与对齐,确保了数据质量,为低资源方言语音识别研究提供了宝贵资源。
使用方法
使用者可通过HuggingFace的datasets库直接加载该数据集,代码简洁高效。加载后,数据以标准格式呈现,包含'audio'和'sentence'两个字段,前者为16kHz采样的音频数组,后者为对应的埃及阿拉伯语文本。数据集已预先分割为短片段,无需额外处理即可直接用于训练、验证或测试。推荐将其用于Whisper等预训练模型的微调,通过设置合适的批大小和学习率,可针对埃及方言语音识别任务快速优化模型性能。此外,数据集也适用于其他基于序列到序列的ASR架构,便于研究者进行跨模型对比实验。
背景与挑战
背景概述
埃及阿拉伯语作为阿拉伯语的重要方言之一,其口语与标准阿拉伯语在语音、词汇和句法上存在显著差异,给自动语音识别(ASR)技术带来了独特挑战。MightyStudent/Egyptian-ASR-MGB-3数据集源于2017年举办的MGB-3(Multi-Genre Broadcast)挑战赛,由多所研究机构联合创建,旨在推动埃及方言语音识别的研究。该数据集精选自YouTube上约80个埃及广播节目,涵盖新闻、访谈、娱乐等多种类型,总计约16小时的高质量人工标注语音。其核心研究问题聚焦于如何在低资源、多体裁的方言场景下提升ASR系统的鲁棒性与准确性。自发布以来,该数据集已成为评估埃及方言语音识别模型性能的重要基准,尤其对Whisper等开源模型的微调训练具有关键支撑作用,推动了阿拉伯方言处理技术的进步。
当前挑战
该数据集所面临的挑战首先体现在领域层面:埃及方言缺乏统一的拼写规范,且语音变体丰富,传统ASR模型常因数据稀缺而难以捕捉其发音规律;同时,多体裁数据(如即兴对话与正式播报)在语速、口音和背景噪声上的巨大差异,进一步加大了识别难度。在构建过程中,挑战同样显著:原始YouTube视频部分已失效或设为私密,导致数据采集不完整;需手动同步转录文本与音频,并精确切割为30秒片段,以适配Whisper等模型的输入要求。此外,每个节目由四名转写员独立标注以提升可靠性,但跨标注者间的一致性控制与方言拼写的标准化处理,均构成了数据预处理阶段的核心瓶颈。
常用场景
经典使用场景
在阿拉伯语方言自动语音识别研究领域,MightyStudent/Egyptian-ASR-MGB-3数据集作为针对埃及方言的多体裁语音资源,其经典使用场景集中于微调与训练端到端语音识别模型,尤其是OpenAI的Whisper系列。该数据集包含约16小时从YouTube采集的埃及阿拉伯语广播节目,音频经16kHz采样并切割为不超过30秒的片段,完美适配Whisper等模型的输入规范。研究者常利用其多体裁特性——涵盖新闻、访谈、娱乐等多样化节目类型——来提升模型对埃及方言的泛化能力,从而在低资源方言场景下实现鲁棒的语音转写。
解决学术问题
该数据集针对性地解决了阿拉伯语方言语音识别中的核心学术难题:标准阿拉伯语与埃及方言之间的巨大声学与语言学鸿沟。由于埃及方言缺乏统一的拼写规范,传统基于标准阿拉伯语的ASR系统在该方言上表现欠佳。MGB-3数据集通过提供四位不同转写者的人工标注转录,不仅建立了方言语音到文本的映射基准,还推动了多风格语音识别在真实噪声环境下的鲁棒性研究。其意义在于为阿拉伯语方言识别领域提供了一个可复现的评估平台,激励学术界探索跨方言迁移学习与低资源语音建模的新范式。
衍生相关工作
该数据集衍生了多项具有影响力的学术工作,其中最具代表性的是Ali等人提出的MGB-3挑战赛及其配套论文《Speech Recognition Challenge in the Wild: Arabic MGB-3》,该工作系统性地定义了埃及方言识别任务并发布了基准结果。后续研究在此基础上探索了基于Transformer的端到端模型、跨方言迁移学习策略以及数据增强技术,例如结合Whisper的微调框架在MGB-3上实现了词错误率的大幅降低。此外,该数据集还催生了针对阿拉伯语方言的预训练语音模型评估基准,成为低资源语音识别领域的重要参照点。
以上内容由遇见数据集搜集并总结生成


