
benchcheck/M3-SLU-sample
收藏官方服务:
资源简介:
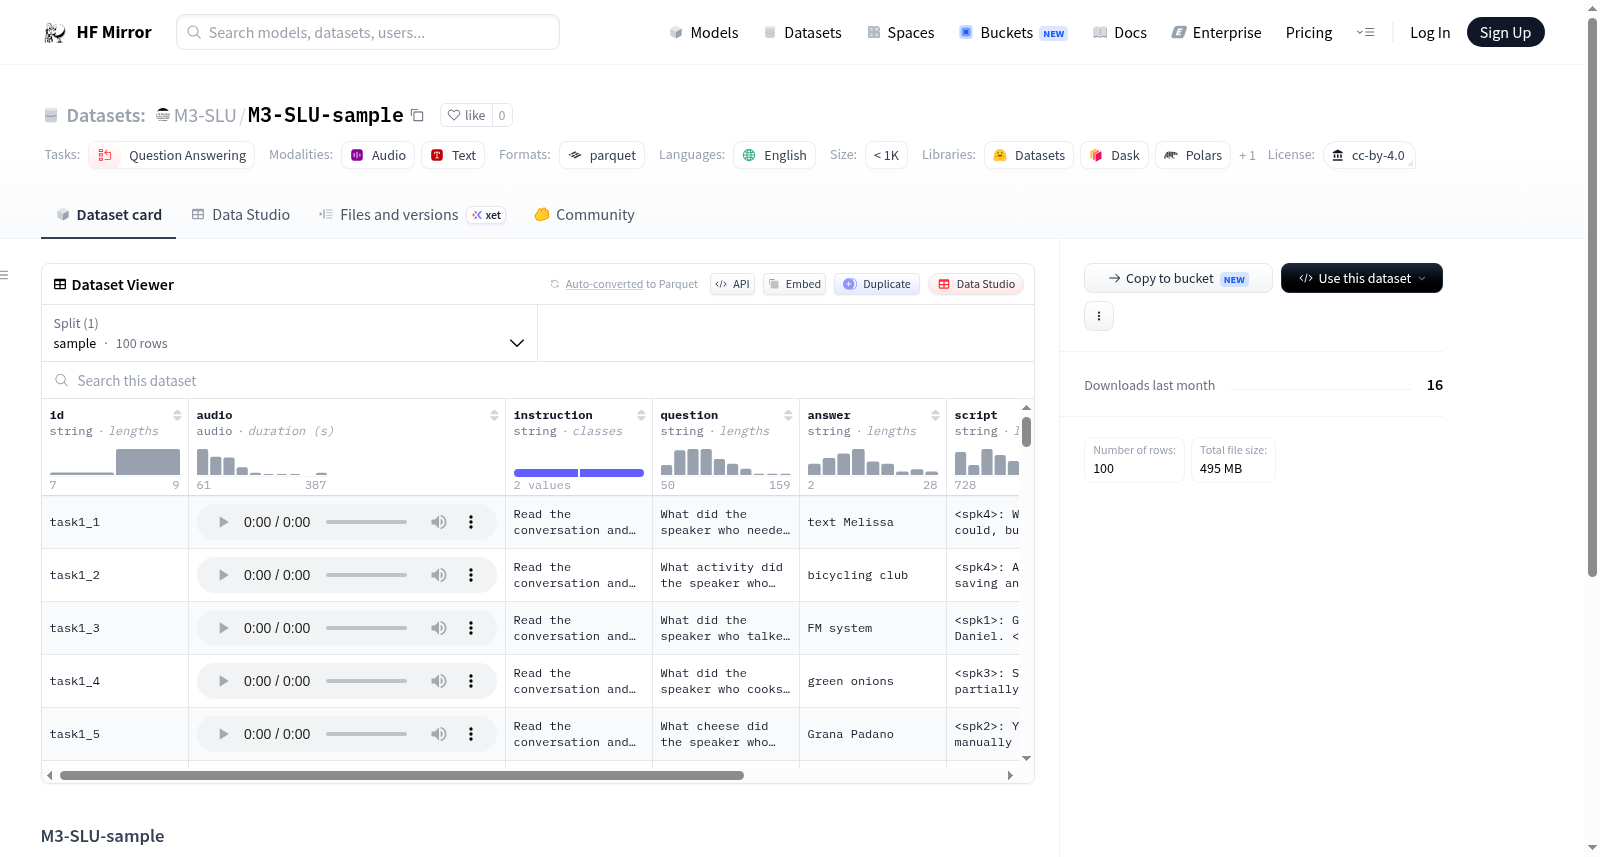
M3-SLU样本数据集包含两个任务的100个样本子集:任务1是说话人归因的问题回答,任务2是说话人归因匹配(真/假)。每个示例包括多说话人对话音频、指令/问题/答案对、脚本和元数据(说话人数、数据来源)。完整的数据集(超过10K个样本)将在2025年稍后发布。
This repository provides 100-sample subsets of the M3-SLU benchmark for two tasks: Task 1: Speaker-Attributed Question Answering and Task 2: Speaker Attribution Matching (True/False). Each example includes multi-speaker conversational audio, instruction/question/answer pairs, transcripts, and metadata (n_speakers, data_source). The full dataset (10K+ samples) will be released later in 2025.
提供机构:
benchcheck搜集汇总
数据集介绍
背景与挑战
背景概述
M3-SLU-sample是M3-SLU基准测试的一个100样本子集,专注于多说话者对话中的说话者归因任务,包括说话者归因问答和说话者归属匹配(真/假)两个任务。数据集包含音频和文本模态,提供多说话者对话的转录、问题-答案对及元数据,适用于自然语言处理和语音理解的研究与评估。
以上内容由遇见数据集搜集并总结生成


