
biraj-bhusal/rakshak-nepali-toxicity
收藏官方服务:
资源简介:
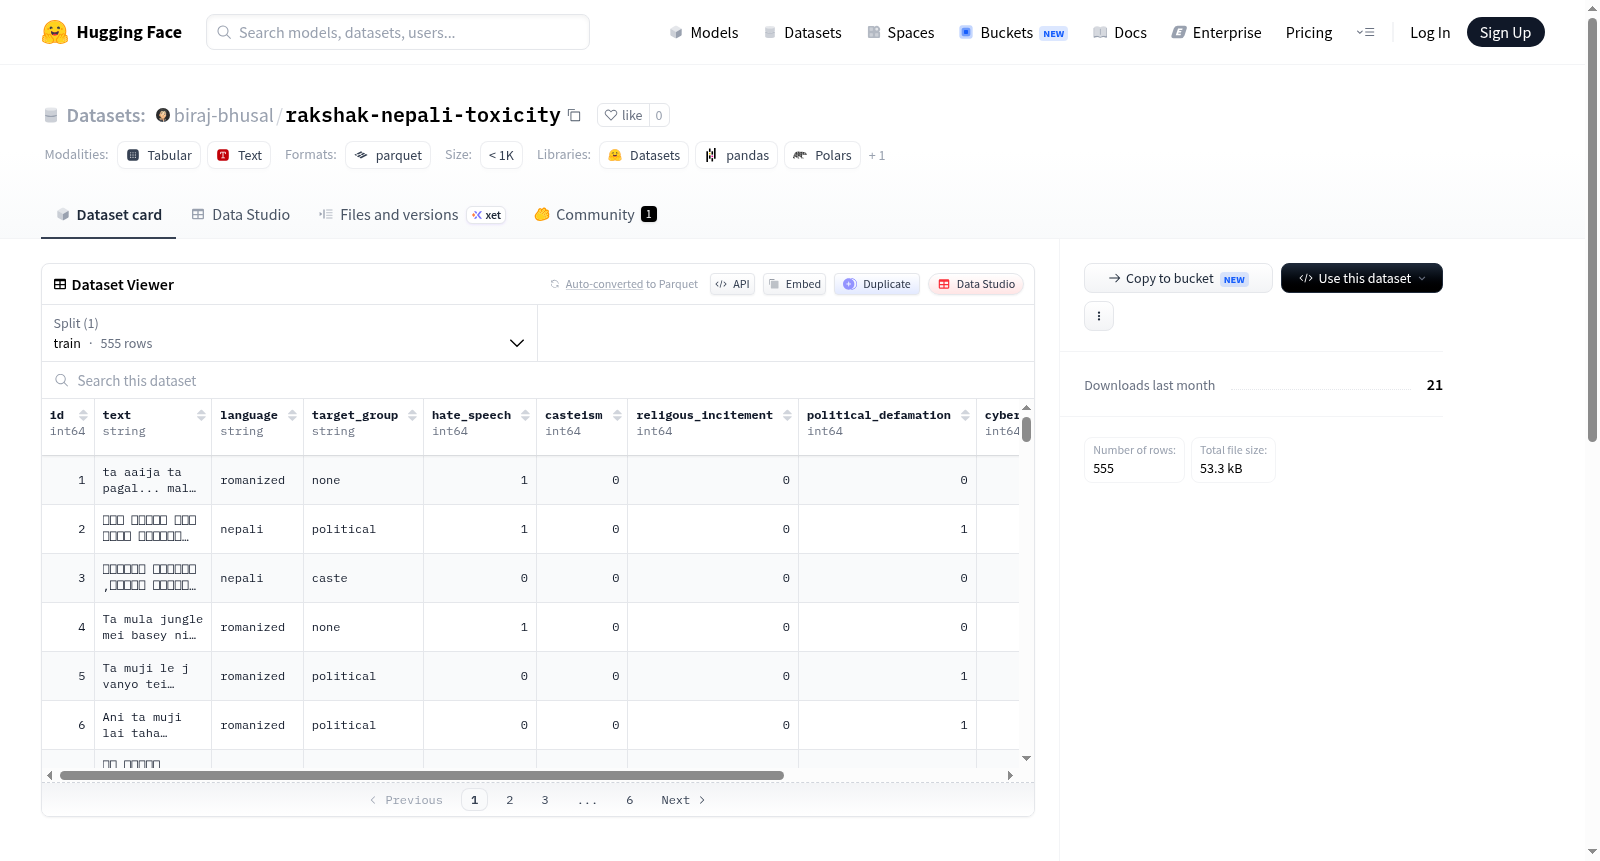
Rakshak尼泊尔毒性数据集是一个针对尼泊尔社交媒体内容的多标签毒性数据集。包含555个样本,涵盖仇恨言论、种姓歧视、宗教煽动、政治诽谤和网络欺凌等类别,文本语言包括尼泊尔语(天城体字母)、罗马化尼泊尔语、混合语言和英语。严重性评分为1(清洁)到5(极端暴力)。该数据集为RakshakAI——尼泊尔社交媒体智能系统而构建。
A multi-label toxicity dataset for Nepali social media content. Contains 555 samples covering hate speech, casteism, religious incitement, political defamation, and cyberbullying in Nepali, Romanized Nepali, Mixed, and English text. Built for RakshakAI — Nepali Social Media Intelligence System.
提供机构:
biraj-bhusal搜集汇总
数据集介绍
构建方式
该数据集专为识别尼泊尔社交媒体中的有害内容而构建,共包含555条标注样本。数据来源涵盖尼泊尔语、罗马化尼泊尔语、混合语种及英语四种语言形式,每条样本均经过多标签标注,涵盖仇恨言论、种姓歧视、宗教煽动、政治诽谤和网络欺凌五大类别,并额外赋予严重性等级评分(1至5级),以量化内容的风险程度。数据集以结构化格式存储,包含文本、语言类型、目标群体及注释字段,训练集单一切分,适用于多标签分类任务的训练与评估。
特点
该数据集的核心特点在于其多标签与多语种的双重维度。标签体系不仅覆盖了五种具体的攻击类型,还通过严重性评分实现了对内容危险程度的细粒度衡量。语言层面的多样性尤为突出,囊括了天城文尼泊尔语、拉丁字母转写的尼泊尔语、两种文字混用的表达以及纯英语,真实反映了尼泊尔社交媒体用户的语言使用习惯。这种设计使得模型能够同时应对语言变体与多重恶意标签的复杂关联,提升了毒性检测的鲁棒性。
使用方法
数据集可直接用于训练多标签文本分类模型,例如基于BERT的序列标注或分类架构。使用时,用户需将'text'字段作为输入,并以'hate_speech'、'casteism'等五个二值标签以及'severity'回归标签作为预测目标。数据已预分为训练集,建议在训练前对标签分布进行统计分析以处理潜在的不平衡问题。此外,可利用'language'字段构建语言感知模型,或基于'target_group'信息进行分群评估,以优化特定场景下的检测效果。
背景与挑战
背景概述
Rakshak Nepali Toxicity数据集是由RakshakAI团队构建的,专注于尼泊尔社交媒体内容的多标签毒性检测,创建于近年以应对尼泊尔语环境下日益严峻的网络暴力问题。该数据集包含555个样本,涵盖仇恨言论、种姓歧视、宗教煽动、政治诽谤和网络欺凌五类毒性标签,并融合了尼泊尔语(天城文)、罗马化尼泊尔语、混合脚本及英语四种语言形式。其核心研究问题在于填补低资源语言(尼泊尔语)在社交媒体毒性检测领域的空白,为开发适应多语言、多文化背景的智能审核系统提供基准,对推动南亚地区网络内容治理与语言技术发展具有重要影响力。
当前挑战
该数据集主要解决的领域挑战是社交媒体中尼泊尔语内容的毒性分类,包括多标签共存(如一条评论同时涉及种姓歧视与政治诽谤)和严重程度分级(从1到5),因尼泊尔社会结构复杂,需精准区分基于身份的集体攻击与个人网络欺凌。构建过程中面临三大挑战:一是数据稀缺,仅555个样本难以覆盖尼泊尔语的地域变体与网络俚语;二是语言标注歧义,罗马化尼泊尔语与混合脚本的语义模糊性增加了人工标注的难度;三是文化敏感性,如种姓歧视的表达常隐晦且依赖上下文,需标注员具备深度社会认知以避免误判。
常用场景
经典使用场景
在自然语言处理与计算社会科学的交叉领域,Rakshak Nepali Toxicity数据集为尼泊尔语社交媒体内容的毒性检测提供了坚实的基准资源。该数据集涵盖仇恨言论、种姓歧视、宗教煽动、政治诽谤和网络欺凌五类细粒度标签,并标注了严重程度等级。研究者常利用其多标签结构训练分类模型,以识别尼泊尔语、罗马化尼泊尔语、混合语及英语文本中的有害内容,推动低资源语言环境下的内容审核技术发展。
解决学术问题
该数据集系统性地回应了南亚地区社交媒体毒性检测面临的学术挑战,尤其聚焦于尼泊尔语境下高发的种姓歧视和宗教煽动问题。通过提供包含Devnagari和拉丁字母混合书写形式的多语言样本,它有效缓解了低资源语言在毒性分类任务中标注数据匮乏的困境,填补了尼泊尔语数字内容安全研究的空白。其多标签设计还推动了对复杂有害模式(如政治诽谤与网络欺凌的并发)的联合建模研究。
衍生相关工作
该数据集催生了多项针对北印度语系低资源语言的毒性检测研究,部分工作以此为基础扩展出印地语-尼泊尔语跨语言迁移学习模型,探索了多标签分类与严重程度回归的联合学习框架。也有研究者利用其细粒度标签体系构建知识图谱,分析不同毒性类型在南亚社交媒体中的共现模式,并衍生出针对罗马化文本特有拼写变体的对抗训练方法。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


