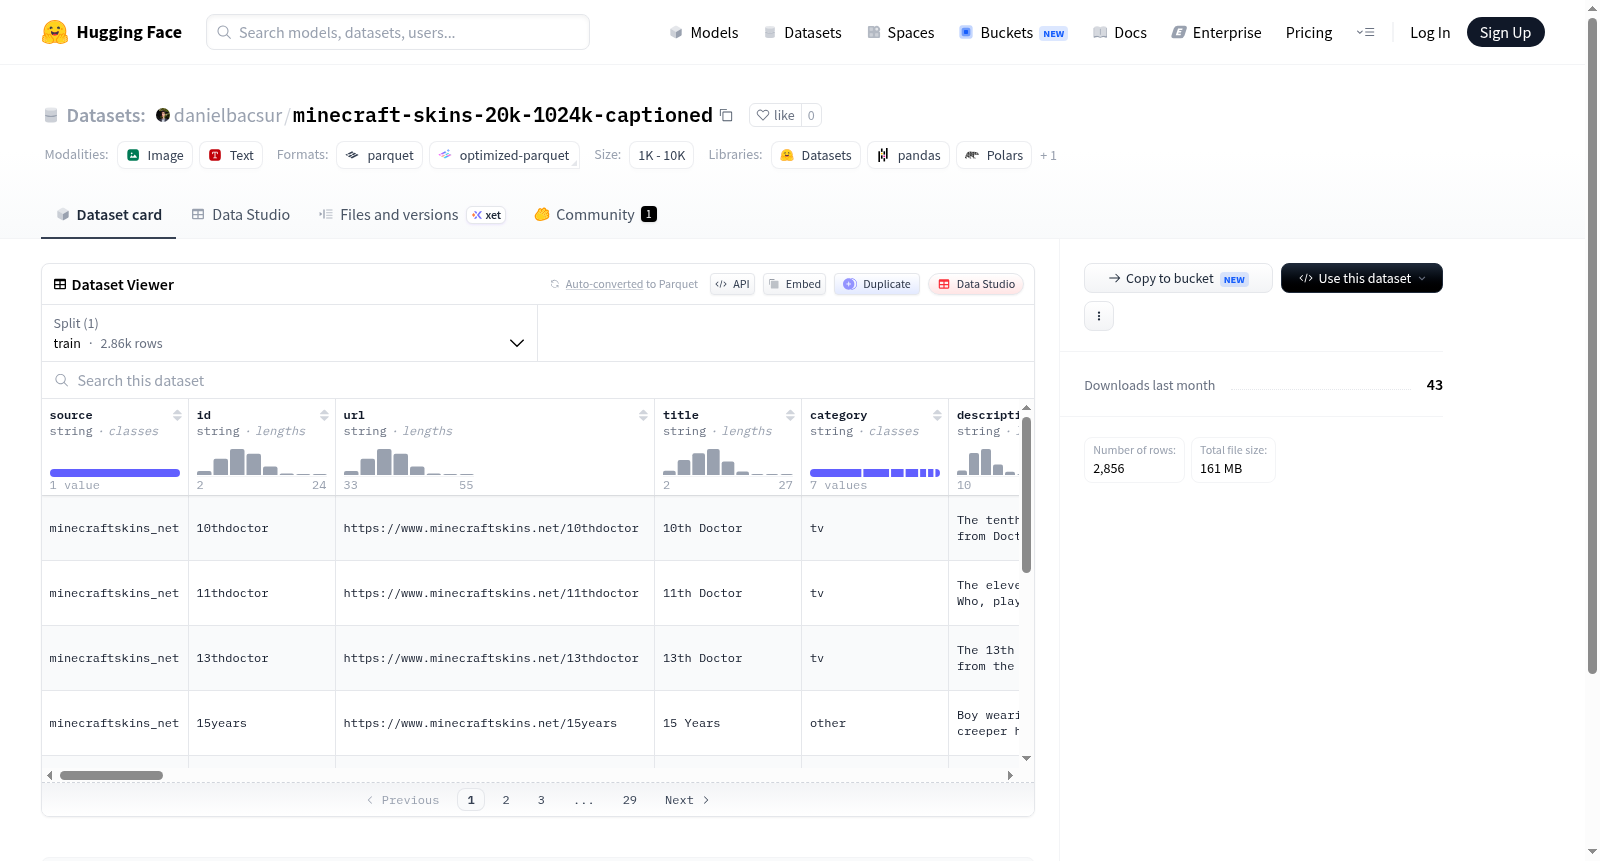
minecraft-skins-20k-1024k-captioned
收藏资源简介:
该数据集是一个多模态的 3D 纹理数据集,包含 2856 个训练样本。每个样本提供纹理图像(原始下载、归一化处理后的纹理)、预览渲染图、多视图渲染图,以及相关的文本描述(标题、描述、标题、身份、外观、关键词等)和嵌入向量(身份嵌入、外观嵌入、多模态嵌入、多视图文本嵌入)。此外,还包含身份支持信息、识别特征数量、观众标志等元数据。数据集可用于 3D 纹理生成、物体外观建模、多模态表示学习等任务。
This dataset is a multimodal 3D texture dataset containing 2856 training samples. Each sample provides texture images (original download, normalized texture), preview renderings, multi-view renderings, along with related text descriptions (title, description, identity, appearance, keywords, etc.) and embedding vectors (identity embedding, appearance embedding, multimodal embedding, multi-view text embedding). Additionally, it includes metadata such as identity support information, number of recognition features, viewer flags, etc. The dataset can be used for tasks such as 3D texture generation, object appearance modeling, and multimodal representation learning.
Minecraft 皮肤数据集(20K/1024K 带标题)
数据集概述
该数据集包含 Minecraft 皮肤相关数据,包含 2,856 个训练样本,数据集总大小为 170,458,558 字节(约 162.5 MB),下载大小为 160,835,176 字节(约 153.4 MB),仅包含一个 train 分割。
数据特征
数据集包含丰富的特征字段,主要分为以下几类:
基础信息
source(字符串):数据来源id(字符串):唯一标识符url(字符串):皮肤资源链接title(字符串):标题category(字符串):类别description(字符串):描述texture_url(字符串):纹理链接
图像数据
downloaded_texture(图像):下载的原始纹理normalized_texture(图像):标准化后的纹理preview_rendering(图像):预览渲染图multiview_rendering(图像):多视角渲染图
标题与描述
caption_schema_version(字符串):标题模式版本caption(字符串):标题内容identity(字符串):身份标识identity_text(字符串):身份文本identity_embedding(浮点数列表):身份嵌入向量appearance(字符串):外观描述appearance_text(字符串):外观文本appearance_embedding(浮点数列表):外观嵌入向量multimodal_embedding(浮点数列表):多模态嵌入向量projection_version(字符串):投影版本appearance_join(字符串):外观拼接信息keywords_text(字符串):关键词文本names(字符串):名称
身份与受众分析
identity_support(字符串):身份支持信息identity_confidence(浮点数):身份置信度identifying_features_count(整数):识别特征数量name_channel_admits(布尔值):名称渠道承认标志audience_flag_kind(字符串):受众标志类型audience_flag_note(字符串):受众标志备注notes(字符串):备注信息
多视图嵌入
view_a_text(字符串):视图 A 文本view_a_embedding(浮点数列表):视图 A 嵌入向量view_b_text(字符串):视图 B 文本view_b_embedding(浮点数列表):视图 B 嵌入向量view_c_text(字符串):视图 C 文本view_c_embedding(浮点数列表):视图 C 嵌入向量view_d_identity_text(字符串):视图 D 身份文本view_d_identity_embedding(浮点数列表):视图 D 身份嵌入向量view_d_appearance_text(字符串):视图 D 外观文本view_d_appearance_embedding(浮点数列表):视图 D 外观嵌入向量
数据配置
- 配置名称:
default - 数据文件路径:
data/train-* - 分割:仅
train,包含 2,856 个示例
适用场景
该数据集适用于 Minecraft 皮肤相关的生成、分类、检索等任务,特别是涉及身份识别、外观描述和多模态理解的应用场景。