faizmubeen/legal_queries_data
收藏资源简介:
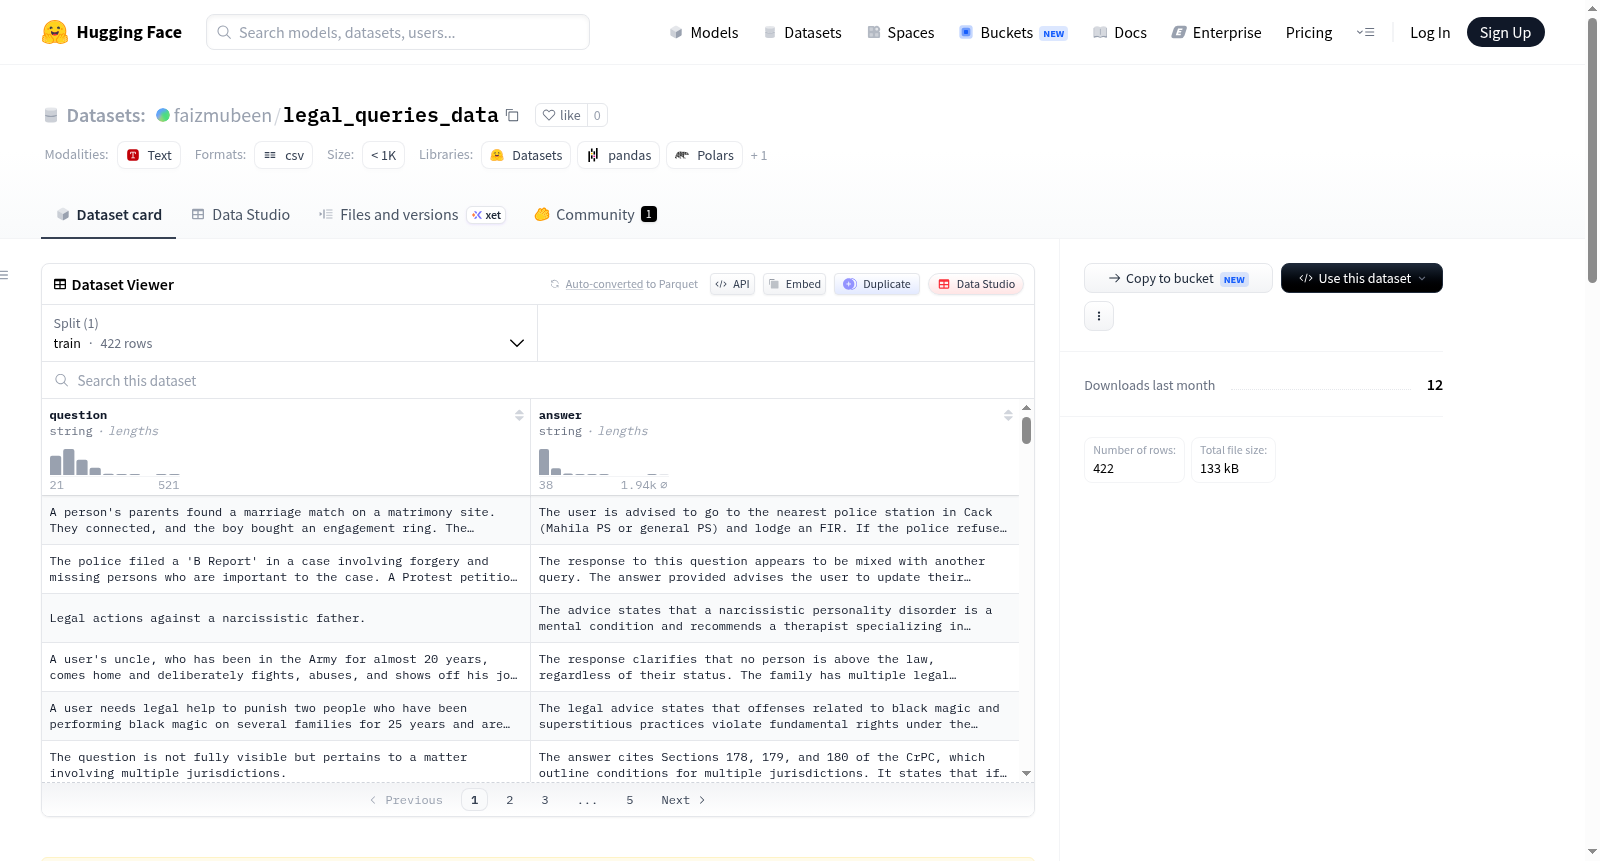
这是一个经过筛选的评估数据集,包含422个真实世界的法律查询及其对应的专业回答。数据主要来源于公开的法律咨询平台,特别是vidhikarya.in和lawguru.com,这些平台上的用户发布实际法律问题并由执业律师直接回答。该数据集旨在作为法律领域理解、信息检索和语言模型指令遵循的稳健测试平台。数据集结构包括总实例数:422,领域:法律(印度和一般法律),语言:英语,格式:问题-答案对。数据字段包括问题(用户原始法律查询,反映真实场景和自然措辞)和答案(合格律师提供的专业真实回答)。来源数据来自公开论坛,捕捉了用户生成查询的固有噪声和多样结构以及法律专业人士的正式语气。数据集可能过度代表在线咨询平台常见的某些法律问题类型(例如财产纠纷、家庭法、基本合同查询),并反映来源网站的具体法律管辖区(Vidhikarya主要为印度法,LawGuru为美国/一般法律)。该数据集有助于开发可访问的AI法律助手和主权数据处理系统,通过提供高质量基准,鼓励开发能够提供准确、有用且无幻觉法律指导的模型,从而民主化基本法律信息的获取。策展人为Faiz Mubeen,来自A.M.U, Aligarh的跨学科人工智能中心。
This is a curated evaluation dataset containing 422 real-world legal queries and their corresponding professional answers. The data is primarily sourced from public legal consultation platforms, specifically vidhikarya.in and lawguru.com, where users post actual legal questions that are directly answered by practicing lawyers. This dataset aims to serve as a robust testbed for legal domain understanding, information retrieval, and large language model (LLM) instruction following. The dataset structure includes total instances: 422, domain: legal (Indian and general law), language: English, and format: question-answer pairs. The data fields consist of the query (the user's original legal inquiry, which reflects real-world scenarios and natural wording) and the answer (professional and authentic responses provided by qualified lawyers). The source data comes from public forums, capturing the inherent noise and diverse structure of user-generated queries, as well as the formal tone of legal professionals. The dataset may overrepresent certain types of legal questions common on online consultation platforms, such as property disputes, family law, and basic contract inquiries, and reflects the specific legal jurisdictions of the source websites: Vidhikarya primarily focuses on Indian law, while LawGuru covers U.S. and general law. This dataset facilitates the development of accessible AI legal assistants and sovereign data processing systems. By providing a high-quality benchmark, it encourages the development of models that can deliver accurate, useful, and hallucination-free legal guidance, thereby democratizing access to basic legal information. The curator is Faiz Mubeen from the Interdisciplinary Artificial Intelligence Center at A.M.U, Aligarh.