
联邦学习驱动 AI 模型迭代优化数据集
收藏官方服务:
资源简介:
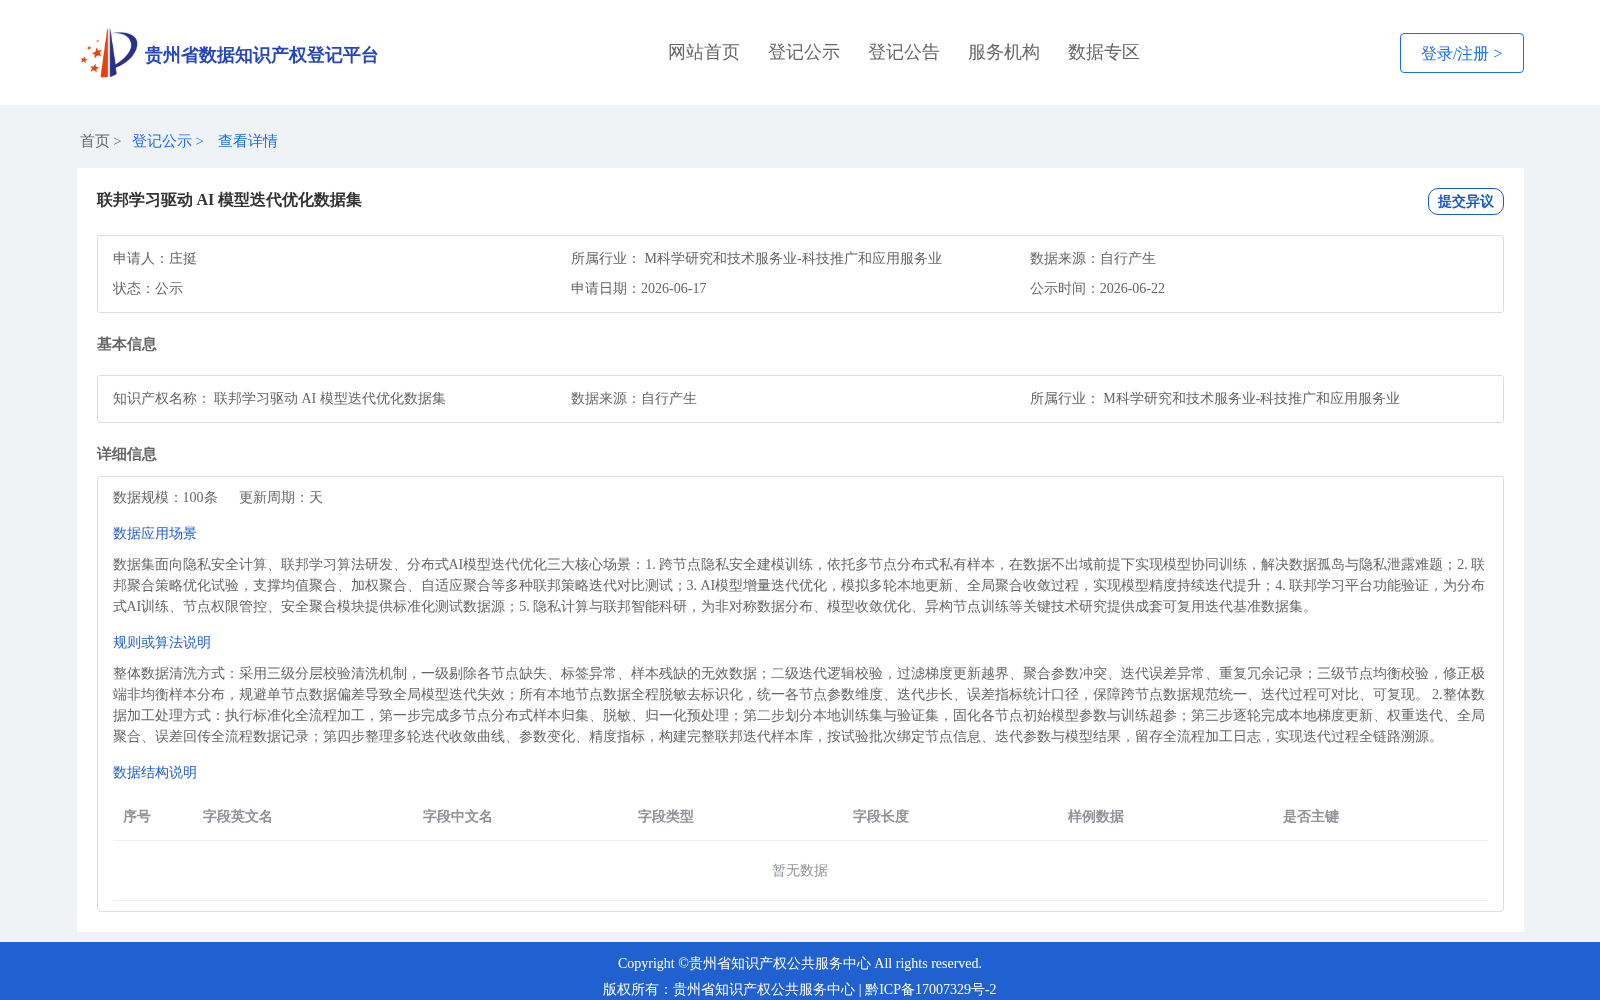
整体数据清洗方式:采用三级分层校验清洗机制,一级剔除各节点缺失、标签异常、样本残缺的无效数据;二级迭代逻辑校验,过滤梯度更新越界、聚合参数冲突、迭代误差异常、重复冗余记录;三级节点均衡校验,修正极端非均衡样本分布,规避单节点数据偏差导致全局模型迭代失效;所有本地节点数据全程脱敏去标识化,统一各节点参数维度、迭代步长、误差指标统计口径,保障跨节点数据规范统一、迭代过程可对比、可复现。 2.整体数据加工处理方式:执行标准化全流程加工,第一步完成多节点分布式样本归集、脱敏、归一化预处理;第二步划分本地训练集与验证集,固化各节点初始模型参数与训练超参;第三步逐轮完成本地梯度更新、权重迭代、全局聚合、误差回传全流程数据记录;第四步整理多轮迭代收敛曲线、参数变化、精度指标,构建完整联邦迭代样本库,按试验批次绑定节点信息、迭代参数与模型结果,留存全流程加工日志,实现迭代过程全链路溯源。
提供机构:
庄挺创建时间:
2026-06-17
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集面向联邦学习与分布式AI模型迭代优化场景,包含通过三级分层校验清洗机制处理后的多节点脱敏数据,并执行了标准化全流程加工,构建了完整的联邦迭代样本库,支持跨节点数据规范统一与迭代过程可复现。
以上内容由遇见数据集搜集并总结生成


