
Aditya685/riddles_improved_v2
收藏官方服务:
资源简介:
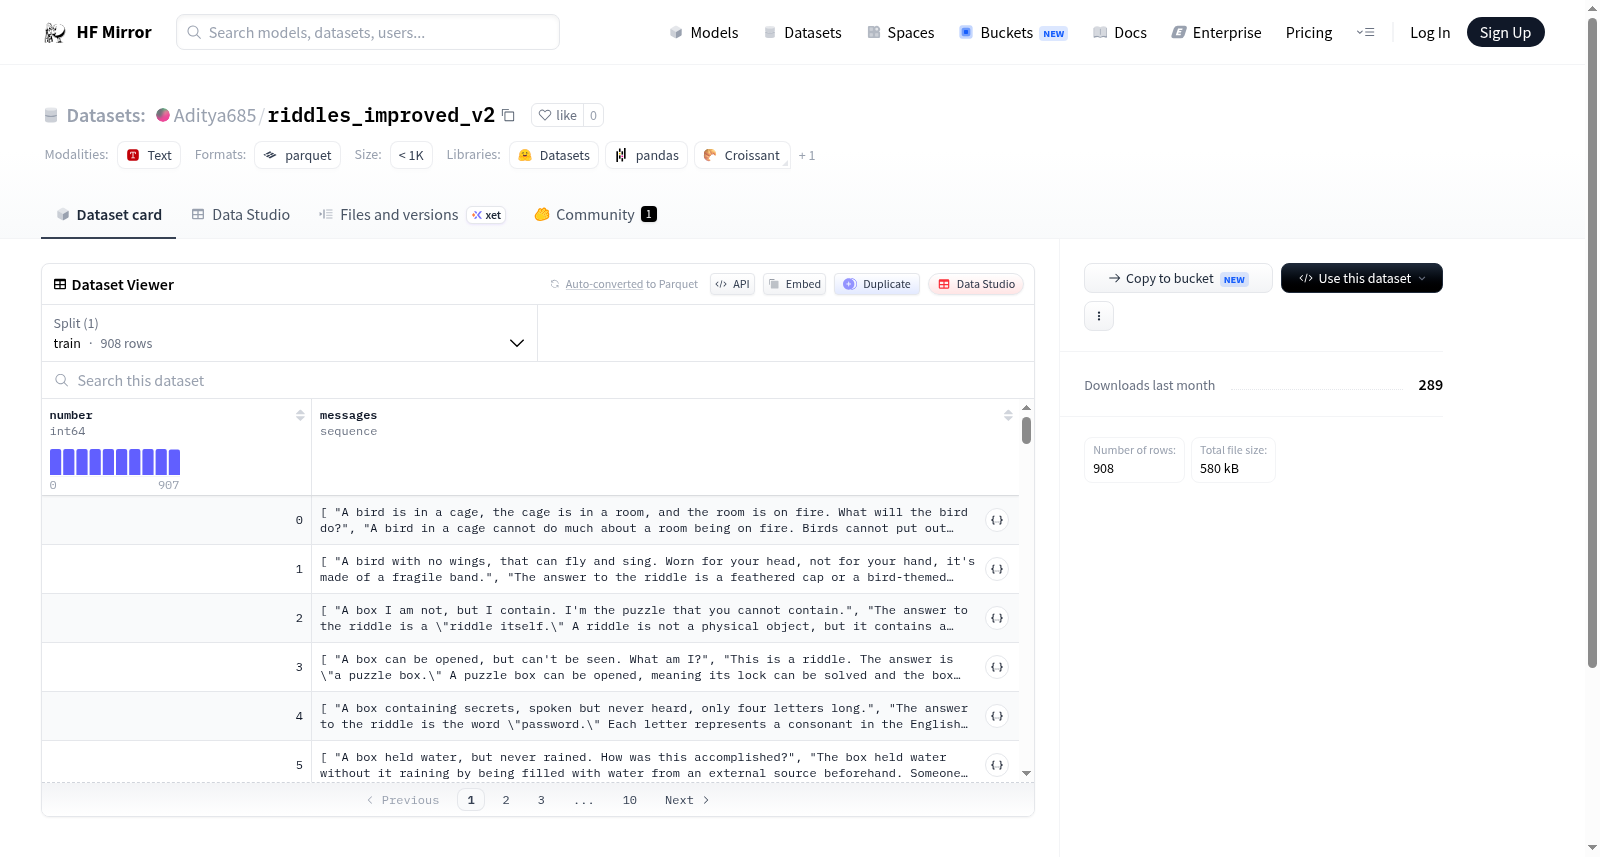
--- dataset_info: features: - name: number dtype: int64 - name: messages sequence: string splits: - name: train num_bytes: 1126553 num_examples: 908 download_size: 577552 dataset_size: 1126553 configs: - config_name: default data_files: - split: train path: data/train-* ---
数据集信息: 特征字段: - 名称:number,数据类型:64位整型(int64) - 名称:messages,数据类型:字符串序列 数据集划分: - 划分名称:train(训练集),占用字节数:1126553,样本数量:908 下载大小:577552,数据集总大小:1126553 数据集配置: - 配置名称:default(默认配置),数据文件: - 对应划分:train(训练集),文件路径:data/train-*
提供机构:
Aditya685原始信息汇总
数据集概述
数据集特征
- 名称: number
- 数据类型: int64
- 名称: messages
- 数据类型: string
- 序列类型: string
数据集分割
- 名称: train
- 字节数: 1126553
- 样本数: 908
数据集大小
- 下载大小: 577552
- 数据集大小: 1126553
配置
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: data/train-*
- 数据文件:
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集包含908个谜语及对应的答案,以对话序列形式存储,旨在用于训练或评估模型对谜语的理解和生成能力。数据为纯文本格式,规模较小,适合作为微调或测试数据集。
以上内容由遇见数据集搜集并总结生成


