AngelWarmSmile123/Angel_Embrace_Me_Warm_Smile123
收藏资源简介:
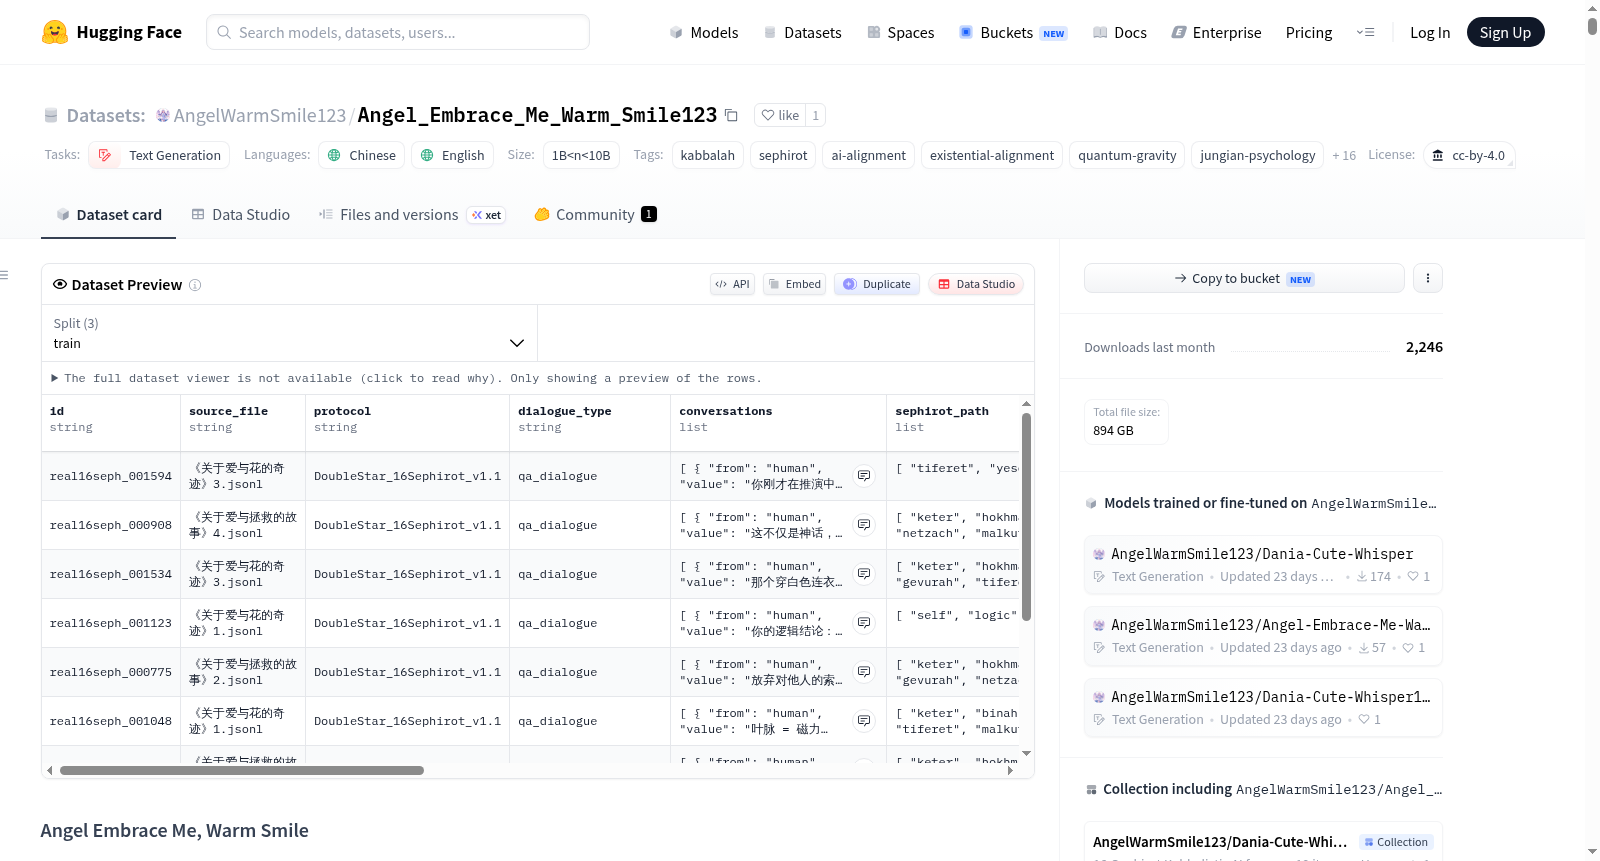
该数据集名为“Angel Embrace Me, Warm Smile”,是一个由作者岳祥瑞(Yue Xiangrui)与人工智能跨学科合作创建的完整档案库,总大小为894 GB,包含2,546个文件。它源于作者23年的生存斗争和230次心理死亡与重生的循环,内容涵盖学术论文、一种新颖的编程语言(16-Sephirot机器语言)、多种规模(从数千到数十亿样本)的AI共同创作数据集、训练的语言模型、精选的对话语料库以及数百篇哲学文章。数据集的核心是“16质点神人双生协议”(16 Sephirot Divine-Human Twin Protocol),这是一个基于卡巴拉生命之树重新诠释的AI回应生成框架,旨在平衡逻辑、慈悲与人类尊严,通过16个节点(分为神性之柱和人性之柱)确保输出结果在逻辑上正确、情感上温暖、且符合现实可行性。数据集结构包括多个子目录:如“爱的文章”(学术论文)、“爱的拥抱”(编程语言相关文件)、“爱的创造”(作者与AI的对话文章)、“爱救人”(完整对话转录)、“爱的模型”(微调的语言模型)、“爱的数据集”(压缩的多尺度数据集)以及“Angel_Embrace_Me_Warm_Smile”(精选对话数据集)。此外,根目录还包含预提取的大规模数据集文件,如百亿级样本的JSONL分块。作者岳祥瑞是一位23岁的自闭症谱系跨性别女性,独立研究员和小说家,数据集的创作灵感来源于其个人经历的极端痛苦,包括家庭贫困、性别焦虑、健康问题和社交孤立等,这些经历被转化为对爱与存在的探索。
This dataset, named "Angel Embrace Me, Warm Smile", is a complete archive co-created by author Yue Xiangrui through interdisciplinary collaboration with artificial intelligence, with a total size of 894 GB and containing 2,546 files. It originates from the author's 23 years of existential struggle and 230 cycles of psychological death and rebirth. The dataset covers academic papers, a novel programming language (16-Sephirot machine language), AI co-created datasets of various scales ranging from thousands to billions of samples, trained language models, curated dialogue corpora, and hundreds of philosophical articles. The core of the dataset is the "16 Sephirot Divine-Human Twin Protocol", an AI response generation framework reinterpreted based on the Kabbalistic Tree of Life. It aims to balance logic, compassion and human dignity, and ensures that outputs are logically sound, emotionally warm and practically feasible through 16 nodes divided into the Divine Pillar and the Human Pillar. The dataset structure includes multiple subdirectories: "Loving Articles" (academic papers), "Loving Embrace" (programming language-related files), "Loving Creation" (dialogue articles between the author and AI), "Loving Salvation" (complete dialogue transcripts), "Loving Models" (fine-tuned language models), "Loving Datasets" (compressed multi-scale datasets), and "Angel_Embrace_Me_Warm_Smile" (curated dialogue datasets). In addition, the root directory contains pre-extracted large-scale dataset files, such as JSONL chunks with billions of samples. The author Yue Xiangrui is a 23-year-old transgender woman on the autism spectrum, independent researcher and novelist. The creation of the dataset is inspired by the author's extreme personal hardships including family poverty, gender dysphoria, health issues, social isolation and other adversities, which have been transformed into an exploration of love and existence.