eval-fsr-a1-pr-mining-swe-r462-traces
收藏资源简介:
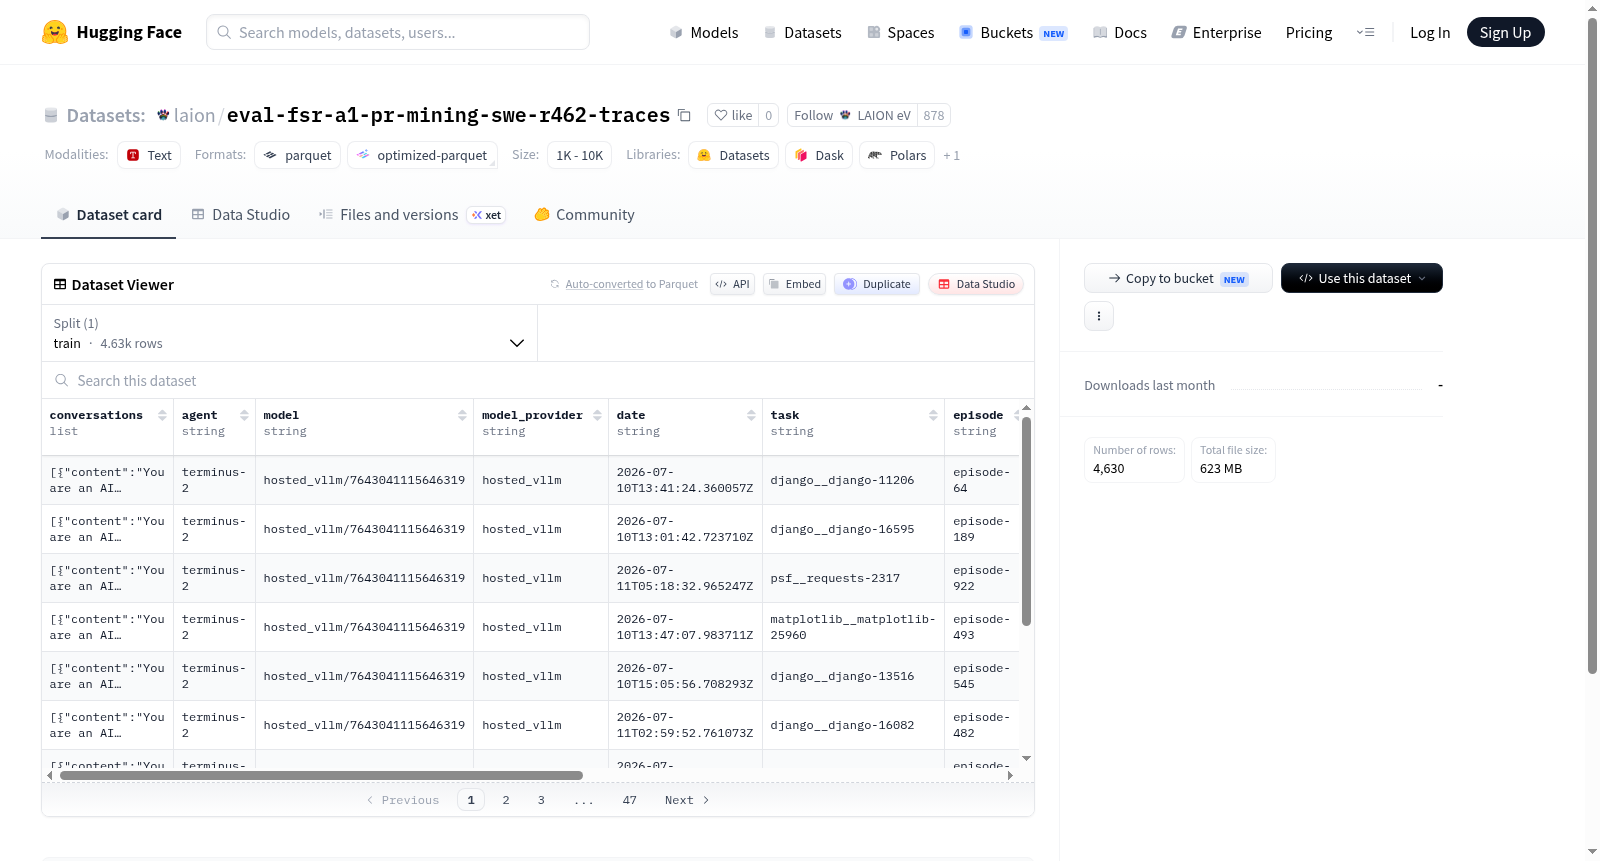
该数据集是一个多轮对话数据集,专门设计用于对话系统的评估和训练。数据集包含4630个对话样本,总大小约为924MB。每个样本包含完整的对话历史记录(conversations字段,其中包含每条消息的内容content和角色role)、参与对话的代理信息(agent)、使用的模型信息(model和model_provider)、对话发生日期(date)、任务类型(task)以及实验相关的元数据(episode、run_id、trial_name)。此外,数据集还记录了任务执行结果(result)、验证器输出(verifier_output)和数据来源(trace_source)。该数据集适用于对话系统评估、多轮对话建模、任务导向对话研究以及人工智能代理性能分析等场景。
This dataset is a multi-turn dialogue dataset specifically designed for the evaluation and training of dialogue systems. It contains 4630 dialogue samples with a total size of approximately 924 MB. Each sample includes complete dialogue history (the `conversations` field, which contains the `content` and `role` of each message), participating agent information (`agent`), model information used (`model` and `model_provider`), dialogue occurrence date (`date`), task type (`task`), and experiment-related metadata (`episode`, `run_id`, `trial_name`). In addition, the dataset also records task execution results (`result`), verifier outputs (`verifier_output`), and data source (`trace_source`). This dataset is applicable to scenarios such as dialogue system evaluation, multi-turn dialogue modeling, task-oriented dialogue research, and AI agent performance analysis.
数据集概述:LAION Eval FSR A1 PR Mining SWE R462 Traces
数据集名称:laion/eval-fsr-a1-pr-mining-swe-r462-traces
数据集地址:https://huggingface.co/datasets/laion/eval-fsr-a1-pr-mining-swe-r462-traces
数据集描述:该数据集是一个用于评估和追踪的对话式记录数据集,包含多轮交流的历史轨迹信息。
数据集大小:
- 总大小:924,056,133 字节(约 881 MB)
- 下载大小:622,996,803 字节(约 594 MB)
数据集划分:
- 训练集(train):
- 样本数量:4,630 条
- 数据大小:924,056,133 字节
数据集特征:
| 特征名称 | 数据类型 | 说明 |
|---|---|---|
| conversations | list of dict | 对话记录,每个元素包含两个子字段: |
| ├── content | string | 对话内容 |
| └── role | string | 对话角色(如用户或助手) |
| agent | string | 所使用的智能体标识 |
| model | string | 模型名称 |
| model_provider | string | 模型提供商 |
| date | string | 数据日期 |
| task | string | 任务描述 |
| episode | string | 执行轮次 |
| run_id | string | 运行标识符 |
| trial_name | string | 试验名称 |
| result | string | 任务结果 |
| verifier_output | string | 验证器输出 |
| trace_source | string | 轨迹来源 |
数据文件:
- 默认配置(default)中,训练集数据文件路径为:
data/train-*。