
MathArena/kangaroo_2025_3-4_outputs
收藏官方服务:
资源简介:
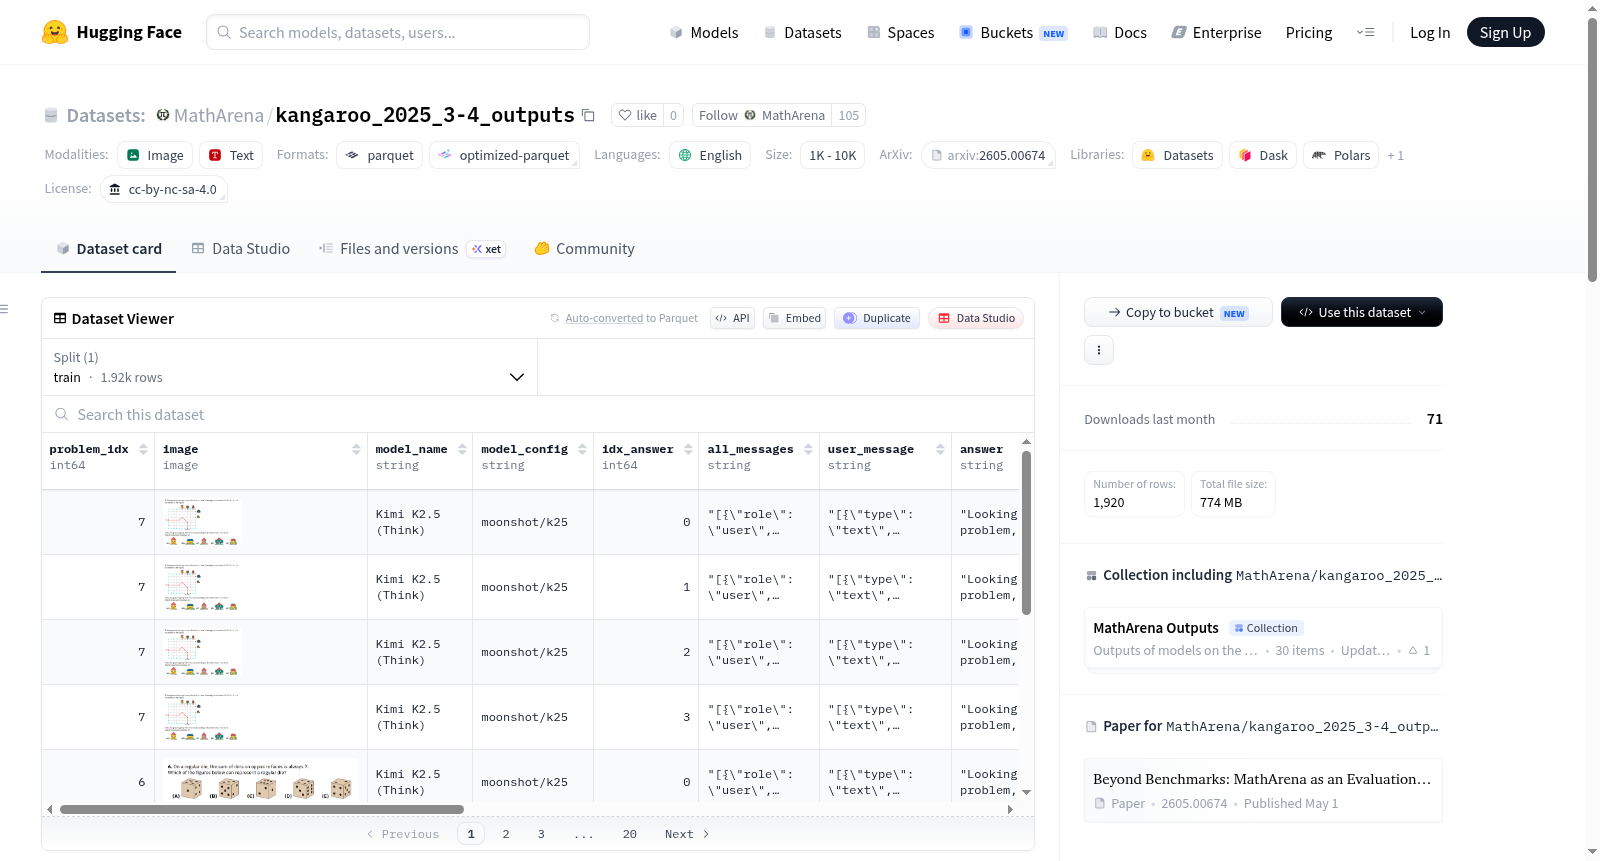
该数据集包含了Kangaroo 2025 3-4竞赛问题的模型答案,由MathArena GitHub仓库生成。数据集中的每个问题都有多个字段信息,如问题索引、问题图片、真实答案、模型名称、模型配置等。
This dataset contains model answers to the questions from Kangaroo 2025 3-4 generated using the MathArena GitHub repository. Each question in the dataset includes multiple fields such as problem index, problem image, ground-truth answer, model name, model configuration, etc.
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
本数据集源自阿尔巴尼亚2025年袋鼠数学竞赛(Kangaroo 2025)3-4年级组的试题,经由题目抽取、语言翻译与截图处理等步骤完成原始素材的采集。在此基础上,依托MathArena开源评估平台(https://github.com/eth-sri/matharena),将标准化后的题目输入多个大语言模型,并记录其生成的全部响应。数据集包含1920条训练样本,每条记录对应一次模型推理尝试,涵盖模型的配置信息、完整对话历史、输入输出令牌数、API调用成本以及模型答案与标准答案的比对结果。整个构建过程严格遵循CC BY-NC-SA 4.0许可协议,确保数据在学术研究中的合规使用。
特点
该数据集具有多维度、细粒度的结构化特征。每条数据不仅记录了模型名称、配置路径、问题索引等元信息,还完整保留了用户消息与模型生成的全文本响应。特别地,数据集中包含了输入与输出的令牌数量、基于不同价格模型估算的API费用(以美元计)以及令牌单价,为成本效益分析提供了可靠依据。此外,数据还存储了标准答案、经解析器提取的模型答案以及二者是否匹配的布尔标识,便于直接进行自动评分。图像字段的引入使得多模态数学问题的评估成为可能,整体设计兼顾了可复现性与分析深度。
使用方法
研究者可直接利用Hugging Face Datasets库加载该数据集,默认划分为训练集。每条样本可通过'image'字段访问题目图像,通过'answer'字段获取模型原始输出,并通过'correct'字段快速筛选正确与错误的推理案例。数据集支持基于'problem_idx'进行跨模型问题的横向对比,也可根据'model_name'或'model_config'分组评估不同模型的性能表现。结合'input_tokens'、'output_tokens'与'cost'字段,能够进一步开展推理效率与经济效益的联合分析。对于需要复现或扩展实验的场景,数据集提供了完整的对话历史'history'与解析结果'parsed_answer',方便进行后续的归因与改进研究。
背景与挑战
背景概述
数学推理能力是评估大型语言模型(LLM)智能水平的核心维度之一。然而,现有基准测试多集中于标准题库,难以真实反映模型在复杂、多步推理场景下的泛化能力。为弥补这一不足,由ETH Zurich安全可靠智能系统实验室(SRI Lab)的Jasper Dekoninck、Nikola Jovanović等研究者于2026年创建的MathArena平台,旨在提供更严谨的数学评估环境。作为该生态的重要组成部分,数据集kangaroo_2025_3-4聚焦于2025年阿尔巴尼亚袋鼠数学竞赛3-4年级题目,通过提取、翻译与截图处理,形成了包含1920条模型-问题对的结构化记录。该数据集不仅涵盖模型答案、推理轨迹与代价信息,还通过自动化评分机制衡量输出正确性,为研究LLM在初等数学领域的推理一致性、成本效率及多步解题能力提供了高保真的实验素材,对推动数学推理评估范式的革新具有显著影响。
当前挑战
该数据集所解决的领域挑战在于,现有数学基准多依赖封闭式问答,难以捕捉模型在开放式数学问题中的真实推理过程与错误模式。kangaroo_2025_3-4通过引入竞赛级多步推理题,要求模型兼顾数值计算、逻辑推演与自然语言表述,从而评估其超越简单模式匹配的深层理解能力。在构建过程中,研究者面临多重挑战:首先,原始题目需从阿尔巴尼亚语精确翻译并转化为可处理的图像格式,需确保语义无失真且视觉元素与文本一致;其次,需为多个生成引擎设计统一的API成本核算框架,以公平对比不同模型的投入产出比;最后,自动化答案解析器需应对多样化格式输出(如混合数学表达式与自然语言),并准确判断逻辑等价性,避免因表述差异导致误判。这些挑战共同塑造了该数据集的独特价值与复杂度。
常用场景
经典使用场景
该数据集聚焦于数学推理能力的系统性评估,经典用例是将多模态数学题目(以图像形式呈现)输入至各类大型语言模型中,通过记录模型的完整对话历史、输出答案及解析结果,对模型在数学问题求解上的表现进行精细化度量。研究者可利用此数据集,基于模型生成答案与标准答案的匹配情况,对前沿LLM在奥林匹克级别数学竞赛上的推理准确性与鲁棒性展开横向比较,从而揭示不同模型在数学逻辑推断与数值运算方面的能力边界。
实际应用
在实际应用层面,该数据集可直接服务于教育科技领域,用于自动化批改系统与个性化数学辅导工具的性能校准。开发团队能够基于此数据集,验证LLM驱动的解题助手在面对竞赛级复杂题目时的准确率与解释质量,从而优化模型在教育场景下的人机交互流程。此外,该数据集还可被嵌入至模型迭代的验证pipeline中,作为衡量模型数学能力提升幅度的定量标杆,助力大模型研发机构在数学基因保持与改进方面做出科学决策。
衍生相关工作
该数据集的发布催生了一系列围绕数学推理深度分析的前沿工作。研究者基于此数据集,构建了涵盖答案正确性、计算成本与输出信心的多维评估框架,并催生了针对LLM在数学问题中逐步推理过程的可解释性分析工作。后续衍生研究还聚焦于跨模型的多轮对话纠错机制,以及通过提示工程改进模型在视觉-数学联合任务上的表现。这些工作共同拓宽了数学AI可评估性的边界,使该数据集成为连接理论研究与工程优化的关键纽带。
以上内容由遇见数据集搜集并总结生成


