
ndla_npk_conversational_nb_to_nn_tags_balanced
收藏数据链接:
官方服务:
资源简介:
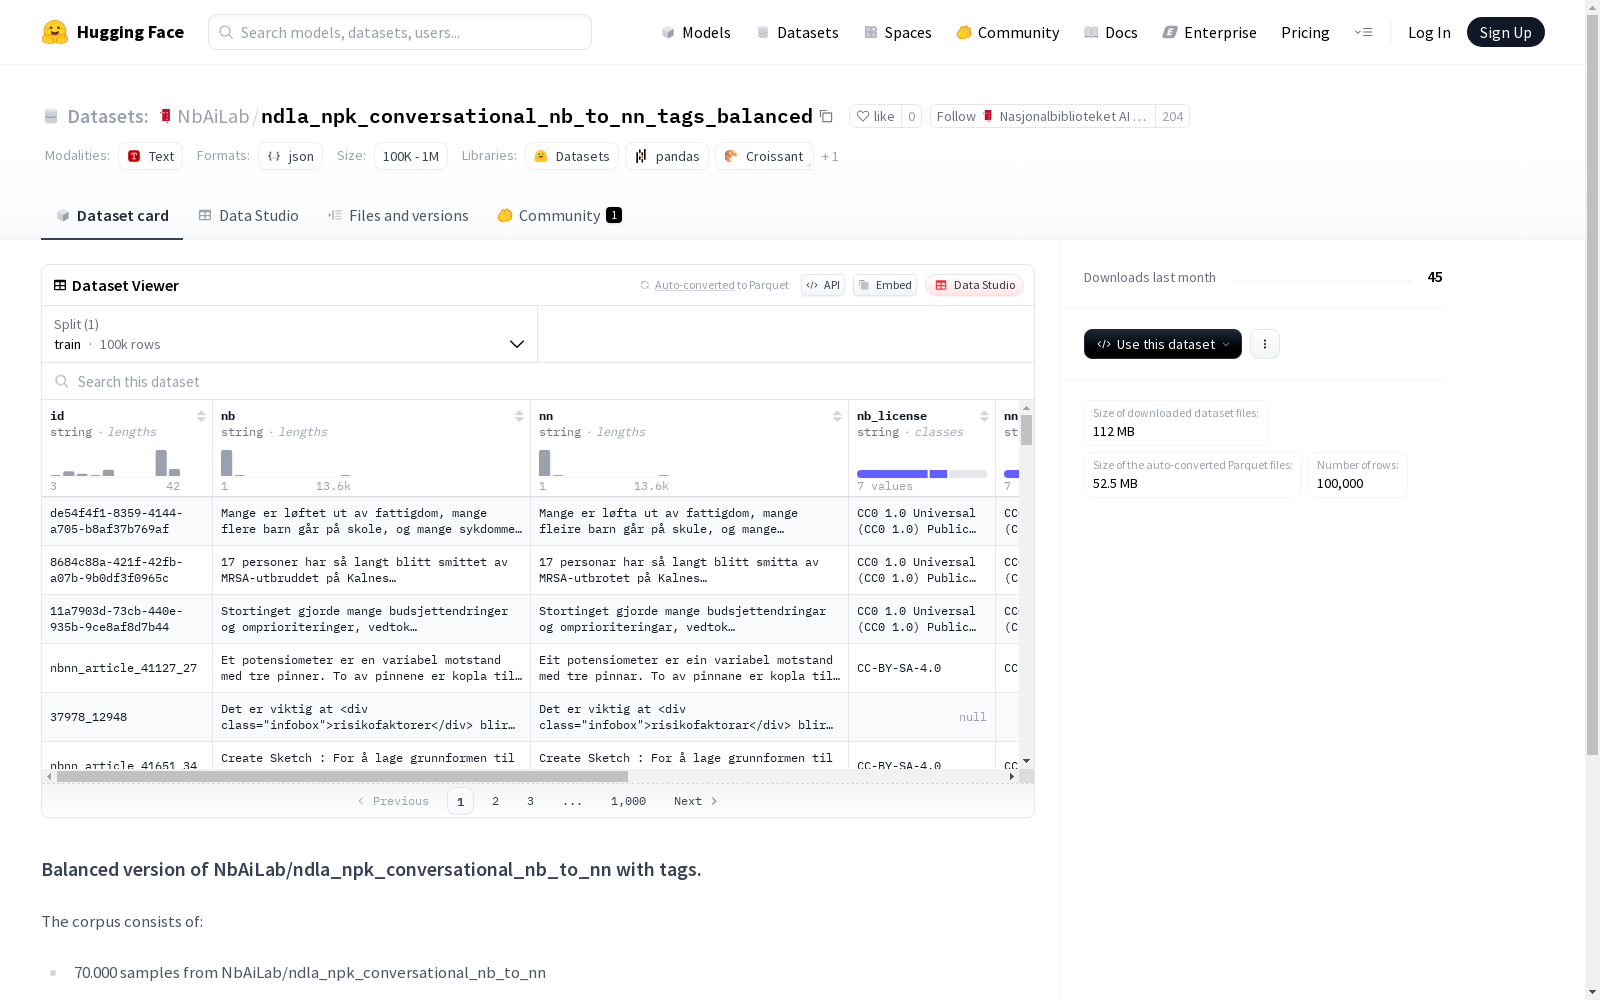
这个数据集是一个平衡版本的会话数据集,包含了70000个来自NbAiLab/ndla_npk_conversational_nb_to_nn的样本,以及15000个带有标签的来自NDLA和NPL的样本。总共有10万个样本。该数据集主要用于GRPO训练。
This is a balanced conversational dataset comprising 70,000 samples from NbAiLab/ndla_npk_conversational_nb_to_nn and 15,000 labeled samples from NDLA and NPL, with a total of 100,000 samples. This dataset is primarily intended for GRPO training.
创建时间:
2025-09-07
原始信息汇总
数据集概述
基本信息
- 数据集名称:Balanced version of NbAiLab/ndla_npk_conversational_nb_to_nn with tags
- 数据格式:JSON
- 训练集文件:data/train.jsonl
数据构成
- 来源1:70,000个样本来自NbAiLab/ndla_npk_conversational_nb_to_nn
- 来源2:15,000个带标签样本来自NDLA
- 来源3:15,000个带标签样本来自NPL
- 总样本量:100,000个样本
主要用途
主要用于GRPO训练
搜集汇总
数据集介绍
构建方式
在挪威语方言转换研究领域,该数据集通过整合多源语料实现平衡构建。核心部分选取NbAiLab对话语料库中的七万条样本,确保基础语言转换任务的覆盖面;进一步纳入挪威数字学习平台与国家语言技术基础设施提供的各一万五千条带标签样本,有效增强了方言特征标注的多样性与准确性。最终形成的十万条样本集合,采用JSONL格式进行标准化存储,为方言转换模型提供了结构化的训练基础。
特点
本数据集显著特点是实现了方言标签与对话语料的深度融合。所有样本均包含明确的挪威博克马尔语至新挪威语转换标签,涵盖教育和技术领域的专业表达。语料平衡性体现在三大权威来源的配比设计,既保留自然对话的流畅性,又强化技术术语的规范性。特别针对强化学习偏好优化训练需求,构建了兼具语言多样性和标注一致性的特色语料库。
使用方法
研究者可加载JSONL格式训练文件直接进行模型微调。建议采用序列到序列架构处理方言转换任务,利用标签信息构建条件生成模型的输入序列。对于强化学习训练场景,可将标签作为奖励模型的参考标准,通过策略梯度优化实现方言转换的精准控制。数据划分建议保留原始集合的完整性,以充分利用十万条样本的语言覆盖广度。
背景与挑战
背景概述
ndla_npk_conversational_nb_to_nn_tags_balanced数据集由挪威人工智能实验室(NbAiLab)主导构建,专注于挪威书面语(Bokmål)与口语(Nynorsk)之间的会话式机器翻译任务。该数据集于2023年发布,核心研究问题在于解决低资源语言对在对话场景中的语义对齐与风格转换难题,通过引入带标签的平衡语料推动多语言自然语言处理技术的发展。其构建显著提升了挪威语语言模型的对话生成质量与跨方言适应性,为北欧语言计算语言学提供了关键数据支撑。
当前挑战
该数据集主要应对挪威语方言间会话翻译的领域挑战,包括方言词汇差异、口语化表达转换以及文化语境适配等复杂语言现象。构建过程中面临语料平衡性处理的难题,需协调NDLA与NPL两个机构的标注标准差异,同时确保带标签样本与原始会话数据的语义一致性。技术实现上需克服低资源语言对数据稀疏性问题,并通过GRPO训练框架优化多标签语料的联合表示学习。
常用场景
经典使用场景
在自然语言处理领域,对话系统与语言生成任务日益受到关注。该数据集专为GRPO训练设计,包含10万条平衡样本,其中7万条来自NbAiLab的对话语料,其余3万条带有NDLA与NPL的标注标签。它常用于训练和评估对话生成模型,特别是在挪威书面语(Bokmål)与新挪威语(Nynorsk)之间的转换任务中,为研究者提供了丰富的跨方言对话数据支持。
解决学术问题
该数据集有效解决了低资源语言对在对话系统中的数据稀缺问题,促进了多语言与方言间自然语言处理的学术研究。通过提供平衡且标注丰富的语料,它支持机器翻译、对话生成及语言模型优化等核心课题,增强了模型在真实语言环境中的泛化能力与准确性,对推动计算语言学与人工智能的跨文化应用具有重要意义。
衍生相关工作
围绕该数据集,已衍生出多项经典研究工作,主要集中在GRPO训练框架的优化与多语言对话模型的创新。例如,基于该语料的生成式预训练模型在挪威语处理任务中表现出色;相关研究还探索了标签增强机制与跨方言迁移学习,推动了低资源语言NLP技术的发展,并为后续类似数据集的构建提供了方法论参考。
以上内容由遇见数据集搜集并总结生成


