miugod/qianyan_nmt
收藏资源简介:
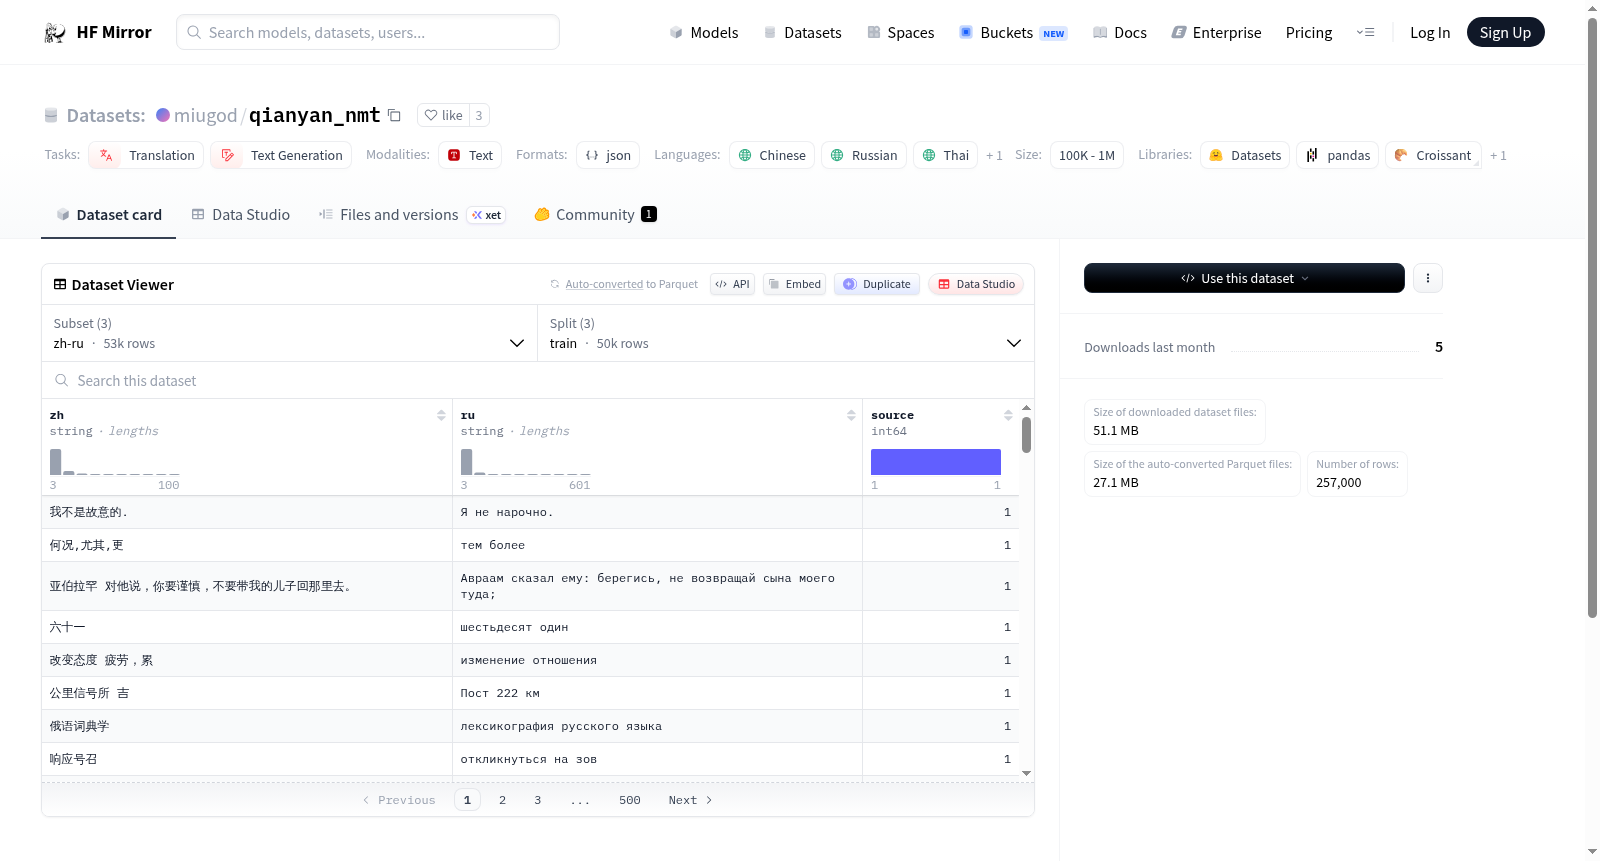
千言数据集:低资源语言翻译,旨在帮助研究人员和开发者解决低资源语言翻译的问题。该数据集包含了中文和俄文的5万条双语平行语料,以及中文和泰文、中文和越南文各10万条目标端单语语料。对于泰文和越南文,使用谷歌翻译进行回译,从而生成对应的中文数据。source=1表示中文到其他语言的翻译,source=0表示其他语言到中文的翻译,以便区分测试集的语言方向。
Qianyan Dataset: Low-Resource Language Translation is designed to help researchers and developers tackle the challenges of low-resource language translation. This dataset consists of 50,000 pairs of Chinese-Russian bilingual parallel corpora, as well as 100,000 entries of monolingual target-side corpora for Chinese-Thai and Chinese-Vietnamese language pairs respectively. For Thai and Vietnamese, back-translation via Google Translate is employed to generate the corresponding Chinese data. The tag `source=1` indicates translation from Chinese to other languages, while `source=0` denotes translation from other languages to Chinese, so as to distinguish the language directions in the test set.
数据集概述
数据集名称
- Qianyan Low-Resource NMT Dataset
数据集目标
- 旨在帮助研究人员和开发者解决低资源语言翻译的问题。
数据集内容
- 包含中文和俄文的5万条双语平行语料。
- 包含中文和泰文、中文和越南文各10万条目标端单语语料。
- 对于泰文和越南文,使用谷歌翻译进行回译,从而生成对应的中文数据。
数据集语言
- 中文 (zh)
- 俄文 (ru)
- 泰文 (th)
- 越南文 (vi)
数据集大小
- 100K<n<1M
数据集配置
- zh-ru
- 训练集:
data/zhru/train.json - 验证集:
data/zhru/valid.json - 测试集:
data/zhru/test.json
- 训练集:
- zh-th
- 训练集:
data/zhth/train.json - 验证集:
data/zhth/valid.json - 测试集:
data/zhth/test.json
- 训练集:
- zh-vi
- 训练集:
data/zhvi/train.json - 验证集:
data/zhvi/valid.json - 测试集:
data/zhvi/test.json
- 训练集:
数据集使用说明
source=1表示中文到其他语言的翻译。source=0表示其他语言到中文的翻译,以便区分测试集的语言方向。