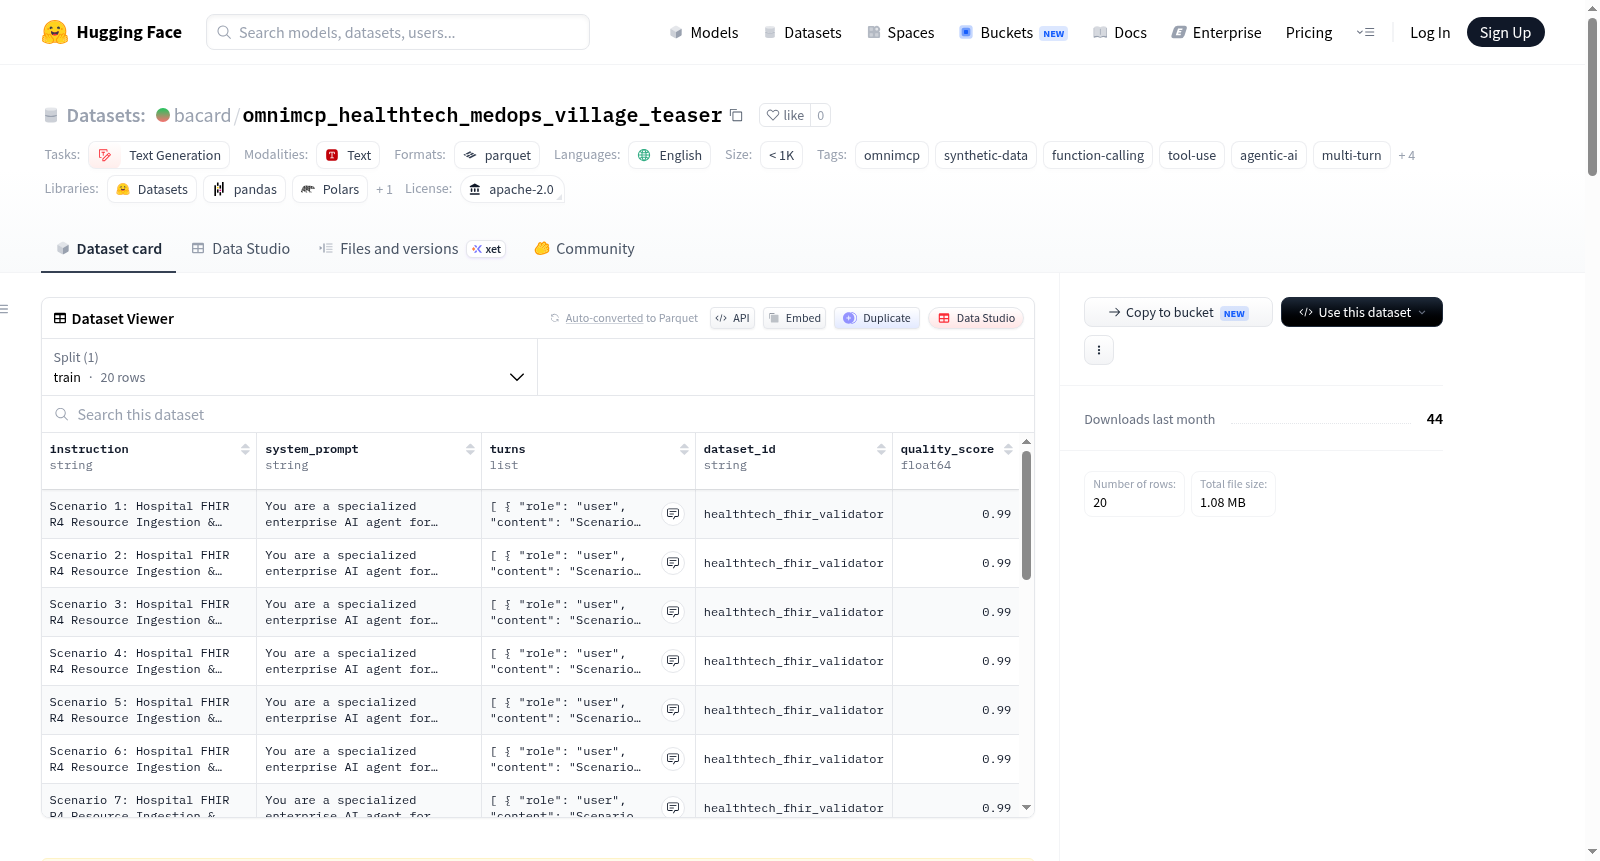
omnimcp_healthtech_medops_village_teaser
收藏资源简介:
OmniMCP - HealthTech & MedOps Village - Autonomous Clinical FHIR & HIPAA Suite (Evaluation Teaser) 是一个免费评估预告数据集,属于 OmniMCP 模块化 AI 生态系统的一部分。该数据集专注于医疗健康技术领域,旨在赋能本地 AI 模型在完全离线环境下处理敏感的医疗数据。其核心功能包括自动修复 FHIR R4 模式、解析 HL7 v2 消息以及实施加密的 HIPAA Safe-Harbor 去标识化。数据集包含多轮对话样本,适用于对话生成、文本生成、函数调用(工具使用)和代理型 AI 任务。数据规模小于 1000 个样本,语言为英语,许可证为 Apache-2.0。该数据集经严格验证,保证 0% 语法错误,符合 GDPR/DSGVO 隐私要求,并遵守 EU AI Act 第 50 和 53 条关于合成数据来源的声明。用户可通过 Hugging Face datasets 库直接加载使用。
OmniMCP - HealthTech & MedOps Village - Autonomous Clinical FHIR & HIPAA Suite (Evaluation Teaser) is a free evaluation teaser dataset, part of the OmniMCP modular AI ecosystem. The dataset focuses on the healthcare technology domain, aiming to empower local AI models to process sensitive medical data in a fully offline environment. Its core features include automatic FHIR R4 schema repair, HL7 v2 message parsing, and encrypted HIPAA Safe-Harbor de-identification. The dataset contains multi-turn conversation samples, suitable for dialogue generation, text generation, function calling (tool use), and agentic AI tasks. The dataset size is under 1000 samples, the language is English, and the license is Apache-2.0. It is strictly validated with 0% syntax errors, compliant with GDPR/DSGVO privacy requirements, and adheres to EU AI Act Articles 50 and 53 regarding synthetic data source declarations. Users can load it directly via the Hugging Face datasets library.
🏛️ OmniMCP: HealthTech & MedOps Village - Autonomous Clinical FHIR & HIPAA Suite (Evaluation Teaser)
数据集概览
该数据集是一个免费的多轮对话评估数据集,聚焦于医疗健康科技与医疗运营领域,旨在让本地AI模型能够完全离线处理敏感的医疗数据负载,涵盖自动化FHIR R4模式修复、HL7 v2解析以及加密HIPAA安全港去标识化等核心能力。
基本信息
- 语言: 英语
- 许可证: Apache 2.0
- 任务类型: 对话、文本生成
- 数据集规模: 少于1K样本
- 标签: omnimcp、合成数据、函数调用、工具使用、Agentic AI、多轮对话、unsloth、axolotl、vllm
核心技术亮点
- FHIR R4 Schema 自动修复: 支持临床FHIR R4标准的模式自动修复能力
- HL7 v2 解析: 支持HL7第二版医疗数据交换标准的解析
- HIPAA 安全港去标识化: 提供符合HIPAA安全港标准的加密去标识化处理
数据质量与合规
- 语法错误保证: 0.0%语法错误率,经过严格的AST与Pydantic验证
- 数据隐私: 100%符合GDPR/DSGVO要求,使用RFC 2606数学化清洗数据
- 合成数据声明: 完全符合欧盟AI法案第50条和53条的合成数据来源声明
数据集加载方式
数据集可以通过Hugging Face的datasets库直接加载:
python from datasets import load_dataset
dataset = load_dataset("bacard/omnimcp_healthtech_medops_village_teaser")
背景信息
该评估数据集属于OmniMCP多层级模块化生态系统的第三层"Village"级别(第3层:村庄级)的组成部分。该层级面向行业解决方案,组合4个专业化的"Houses"。该数据集的完整生产级主包及商业EULA可通过Gumroad平台获取。