NeCTIS-Dataset
收藏资源简介:
DepNeCTI-LSTM是一个针对梵语的嵌套化合物类型识别数据集,包含领域内散文和领域外诗歌两个子数据集。数据集标注了粗粒度和细粒度的语义类型,粗粒度有四种类型,细粒度有86种子类型。数据集基于Pāṇinian语法和传统注释进行标注,并经过多级别质量检查和验证。
DepNeCTI-LSTM is a dataset dedicated to Sanskrit nested compound type recognition, which comprises two subsets: in-domain prose and out-of-domain poetry. The dataset is annotated with both coarse-grained and fine-grained semantic categories, including four coarse-grained types and 86 fine-grained subtypes. All annotations are conducted based on Pāṇinian grammar and traditional commentaries, and the dataset has undergone multi-level quality checks and validations.
NeCTIS-Dataset 概述
数据集简介
- 目的:用于梵语中的嵌套复合类型识别,特别关注多组分复合词(尤其是超过2个组分的复合词)。
- 包含两种数据集:
- NeCTIS:域内数据(散文)
- NeCTIS-OOD:域外数据(诗歌)
关键特性
- 注释类型:
- 粗粒度:4种复合类型:
- Avyayībhava(不变词)
- Bahuvrīhi(外中心)
- Tatpurusha(内中心)
- Dvandva(并列)
- 细粒度:86种详细子类型
- 粗粒度:4种复合类型:
数据集统计
| 数据集 | 嵌套复合词数量 | 训练集 | 测试集 | 开发集 | 复合类型 |
|---|---|---|---|---|---|
| NeCTIS | 17,656 | 12,431 | 3,493 | 2,405 | 4 (86) |
| NeCTIS-OOD | 1,189 | — | 1,189 | — | 4 (86) |
领域与体裁
- NeCTIS:哲学、文学和阿育吠陀领域 → 散文
- NeCTIS-OOD:史诗文学领域 → 诗歌
注释过程
- 资助:DeitY(2009–2012)作为梵语-印地语机器翻译项目的一部分
- 注释机构:6个机构,每个机构约10名成员,分为3个专业级别:
- 初级语言学家(梵语硕士)
- 高级语言学家(梵语博士)
- 专业语言学家(教授)
- 质量检查:多级质量检查和跨机构验证
- 注释指南:基于帕尼尼语法和传统注释
文件结构
├── No Context CSV files/ │ ├── Combined.csv │ ├── test.csv │ ├── train.csv │ ├── dev.csv │ └── outofDomain.csv ├── With Context CSV files/ │ ├── Combined.csv │ ├── test.csv │ ├── train.csv │ ├── dev.csv │ └── outofDomain.csv
数据集详情
带上下文
- 总行数:15,940行
- 拆分:训练集(69%),测试集(18%),开发集(13%)
- 列说明:
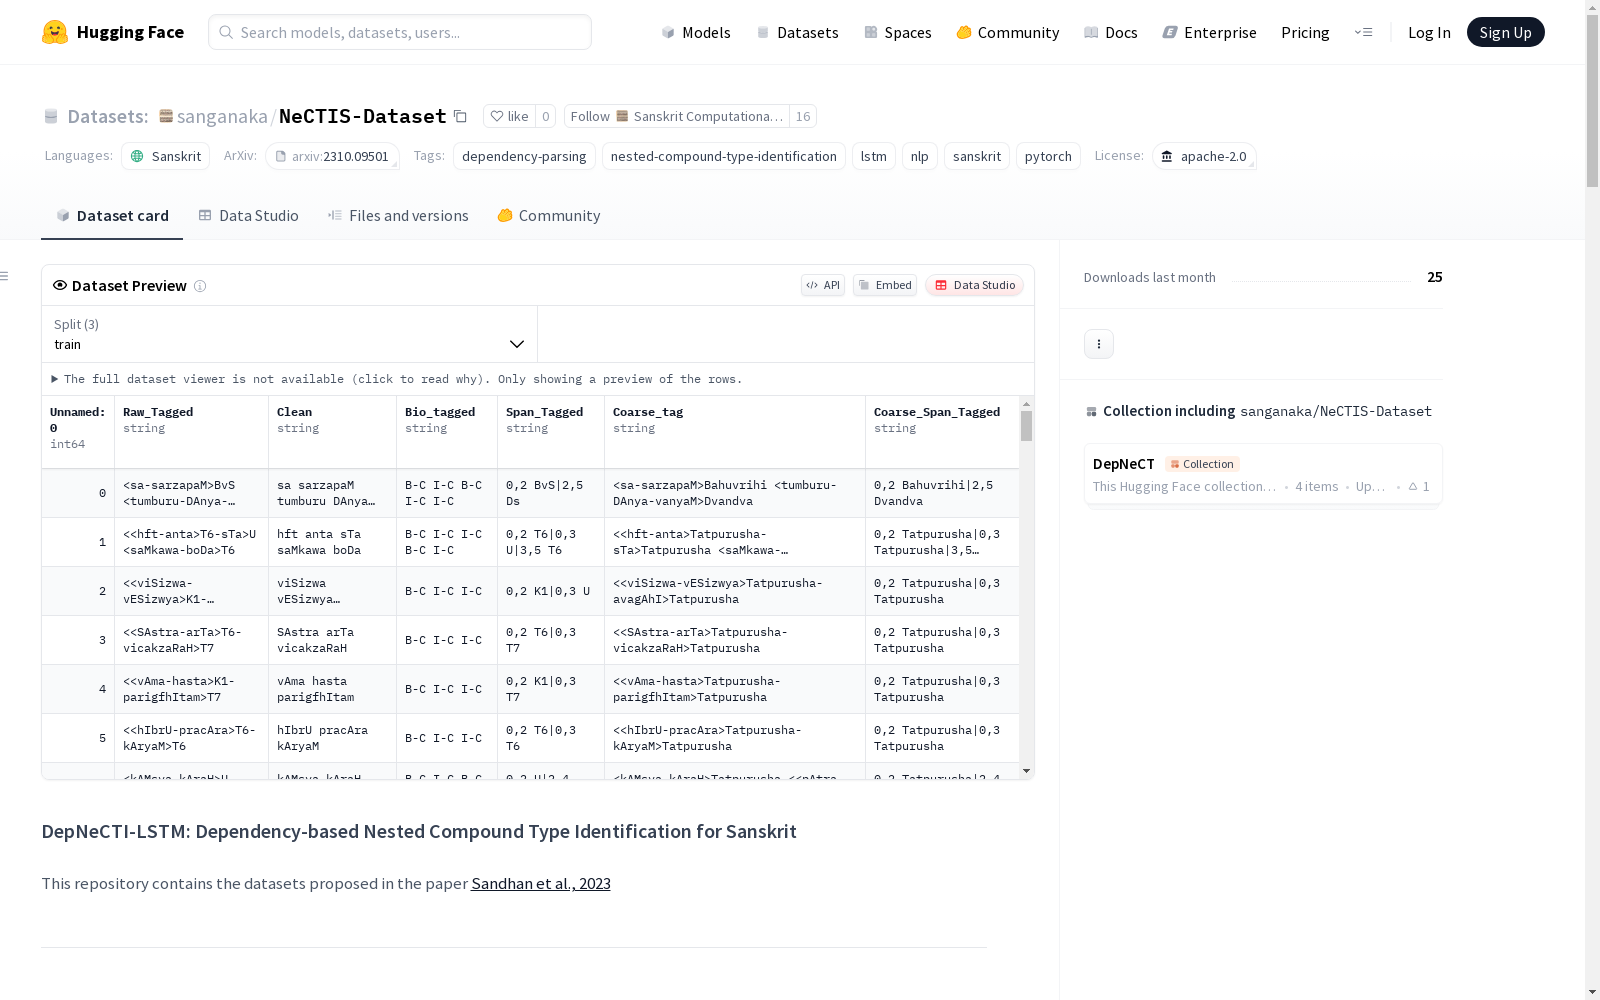
Unnamed: 0:行索引Raw_Tagged:带注释标签的原始文本Clean:清理后的文本Bio_tagged:BIO标记方案Span_Tagged:标记跨度Coarse_tag:粗粒度复合类型Compound_lengths:复合词长度Coarse_Span_Tagged:粗粒度标记跨度Book(仅域外数据集):书籍来源
不带上下文
- 总行数:15,940行
- 列说明:
- 与带上下文数据集相同,但不包含
Compound_lengths列
- 与带上下文数据集相同,但不包含
引用
bibtex @misc{sandhan2023depnecti, title={DepNeCTI: Dependency-based Nested Compound Type Identification for Sanskrit}, author={Jivnesh Sandhan and Yaswanth Narsupalli and Sreevatsa Muppirala and Sriram Krishnan and Pavankumar Satuluri and Amba Kulkarni and Pawan Goyal}, year={2023}, eprint={2310.09501}, archivePrefix={arXiv}, primaryClass={cs.CL} }
原始论文:DepNeCTI: Dependency-based Nested Compound Type Identification for Sanskrit
GitHub仓库:DepNeCTI