
stefanocarrera/autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g2_run2
收藏数据链接:
官方服务:
资源简介:
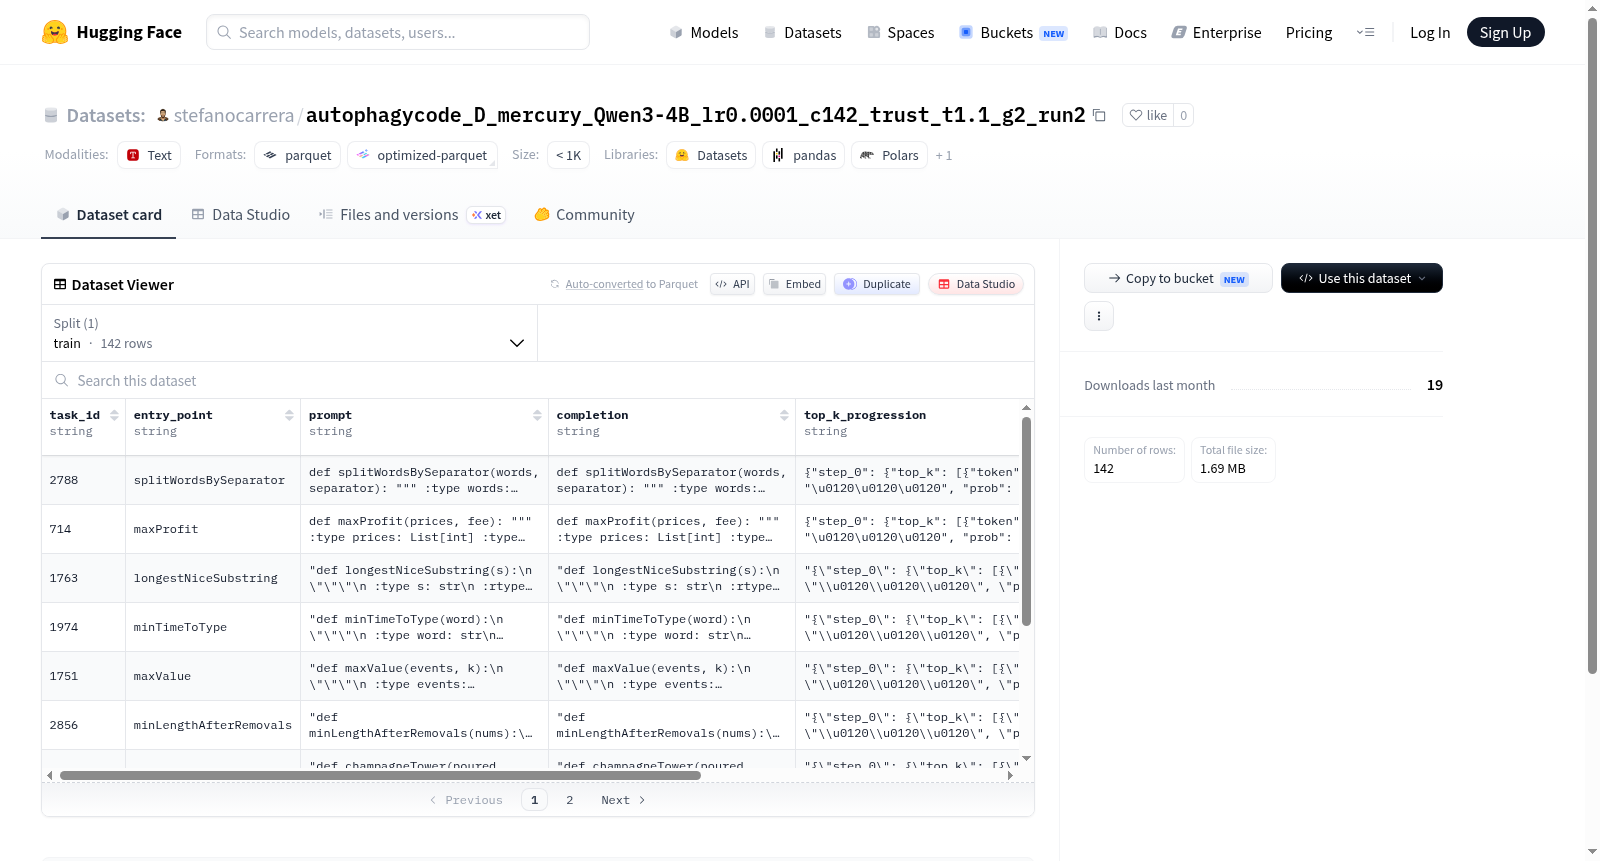
该数据集是一个用于代码生成或任务完成任务的基准数据集,包含142个训练示例。每个示例具有以下特征:task_id(任务标识符)、entry_point(入口点)、prompt(提示文本)、completion(完成文本)、top_k_progression(top-k进展)和test(测试信息)。数据集可能用于评估模型在编程或自然语言处理任务中的性能,涉及从提示生成代码或文本完成。
This dataset is a benchmark for code generation or task completion tasks, containing 142 training examples. Each example includes the following features: task_id (task identifier), entry_point (entry point), prompt (prompt text), completion (completion text), top_k_progression (top-k progression), and test (test information). The dataset is likely used to evaluate model performance in programming or natural language processing tasks, involving generating code or text completions from prompts.
提供机构:
stefanocarrera搜集汇总
数据集介绍
构建方式
该数据集名为autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g2_run2,专注于代码生成与自动编程领域。其构建过程基于Qwen3-4B模型,在特定学习率lr=0.0001下进行微调训练,共涵盖142个训练样本。数据集包含task_id、entry_point、prompt、completion、top_k_progression及test六个字段,其中prompt与completion分别构成模型的输入与输出,支持对代码补全与生成任务的系统性评估。数据以parquet格式存储,总大小约为6.76 MB,便于高效加载与处理。
特点
该数据集的核心特点在于其精细化的任务设计:每个样本均包含唯一的task_id和函数入口点entry_point,从而强化了代码结构的一致性。prompt字段提供编程问题的自然语言描述或部分代码片段,而completion字段则存储模型生成的完整代码答案。此外,top_k_progression字段记录了模型推理过程中的概率演进信息,为分析模型决策路径与生成质量提供了宝贵依据。test字段则保留用于评估的标准答案,确保训练与测试的分离。整体数据规模虽小,但结构化程度高,适合用于探索小样本场景下的代码生成模型行为。
使用方法
使用该数据集时,用户可直接通过HuggingFace Datasets库加载默认配置,读取train分区的全部数据。典型应用流程包括:将prompt字段作为输入传递给微调后的代码生成模型,以completion作为目标输出进行监督学习或评估。top_k_progression字段可用于可视化模型在生成过程中的候选令牌概率变化,辅助诊断模型的不确定性或探索性行为。由于数据集已预先划分训练集,建议直接基于其全部样本来微调或评估Qwen3-4B模型,并利用test字段检验生成代码的准确性,从而衡量模型的代码合成性能。
背景与挑战
背景概述
该数据集名为autophagycode_D_mercury_Qwen3-4B_lr0.0001_c142_trust_t1.1_g2_run2,由某研究团队在探索代码生成与自噬机制(autophagy)交叉领域时构建,其核心研究问题聚焦于利用大型语言模型(Qwen3-4B)在特定学习率(0.0001)和信任阈值(1.1)下,通过少量样本(142例训练数据)自动化生成与自噬相关的代码任务解答。该数据集以任务标识(task_id)、入口点(entry_point)、提示(prompt)、完成代码(completion)等字段为核心,旨在评估模型在生物信息学代码生成任务中的精准度与鲁棒性。尽管数据集规模较小,但其针对自噬这一特定生物学过程的代码生成需求,为罕见疾病机理研究与药物靶点发现提供了可复现的计算基准,对推动自动化科学代码生成领域具有探索性意义。
当前挑战
当前数据集面临多重挑战。领域问题层面,自噬相关的代码生成任务高度依赖对生物学知识的精准建模,现有数据规模(142样本)难以覆盖多样化的自噬调控路径与突变场景,导致模型泛化能力受限。构建过程中,从生物文献中半自动提取高质量提示-代码对存在噪声与标注不一致问题,尤其在复杂条件语句与多变量调控逻辑的代码生成中易引入错误。此外,学习率与信任阈值的超参数选择依赖经验调优,缺少自动化验证机制,使得最终代码的可靠性与可执行性在未见测试数据中难以保证。这些挑战共同制约了数据集在真实生物信息学任务中的落地应用。
常用场景
经典使用场景
该数据集聚焦于代码生成与自动补全任务,尤其是针对函数级别的编程场景。它包含了任务编号、函数入口点、提示文本、代码补全内容、逐步推导过程以及测试用例,为训练模型理解代码上下文、生成高质量函数实现提供了精细化数据支撑。经典使用方式是将提示文本作为输入,驱动模型输出完整的代码补全序列,并通过测试用例验证正确性,从而提升编程助手的代码生成能力。
实际应用
实际应用中,该数据集可用于开发智能编程辅助工具,如集成开发环境中的代码补全插件或对话式编程机器人。开发者利用该数据集微调语言模型后,能够实现根据自然语言需求自动生成函数体、智能建议下一步代码,并在团队协作中提升编码效率、降低手动编写带来的错误率,尤其适用于快速原型开发和工程代码复用场景。
衍生相关工作
基于该数据集的核心结构,已经衍生出多个相关工作,包括基于逐步推理的代码生成模型训练框架、多步代码补全性能评估基准,以及将提示-补全-测试三元组融入强化学习的探索性研究。此外,还有工作尝试将逐步推导作为监督信号用于自监督预训练,进一步增强了模型在跨语言代码迁移中的泛化表现,推动了代码智能生成技术的持续演进。
以上内容由遇见数据集搜集并总结生成


