
遇见数据集

bengaliAI/bethik-lexicon

收藏
Hugging Face2026-07-18 更新2026-07-22 收录
官方服务:

资源简介:

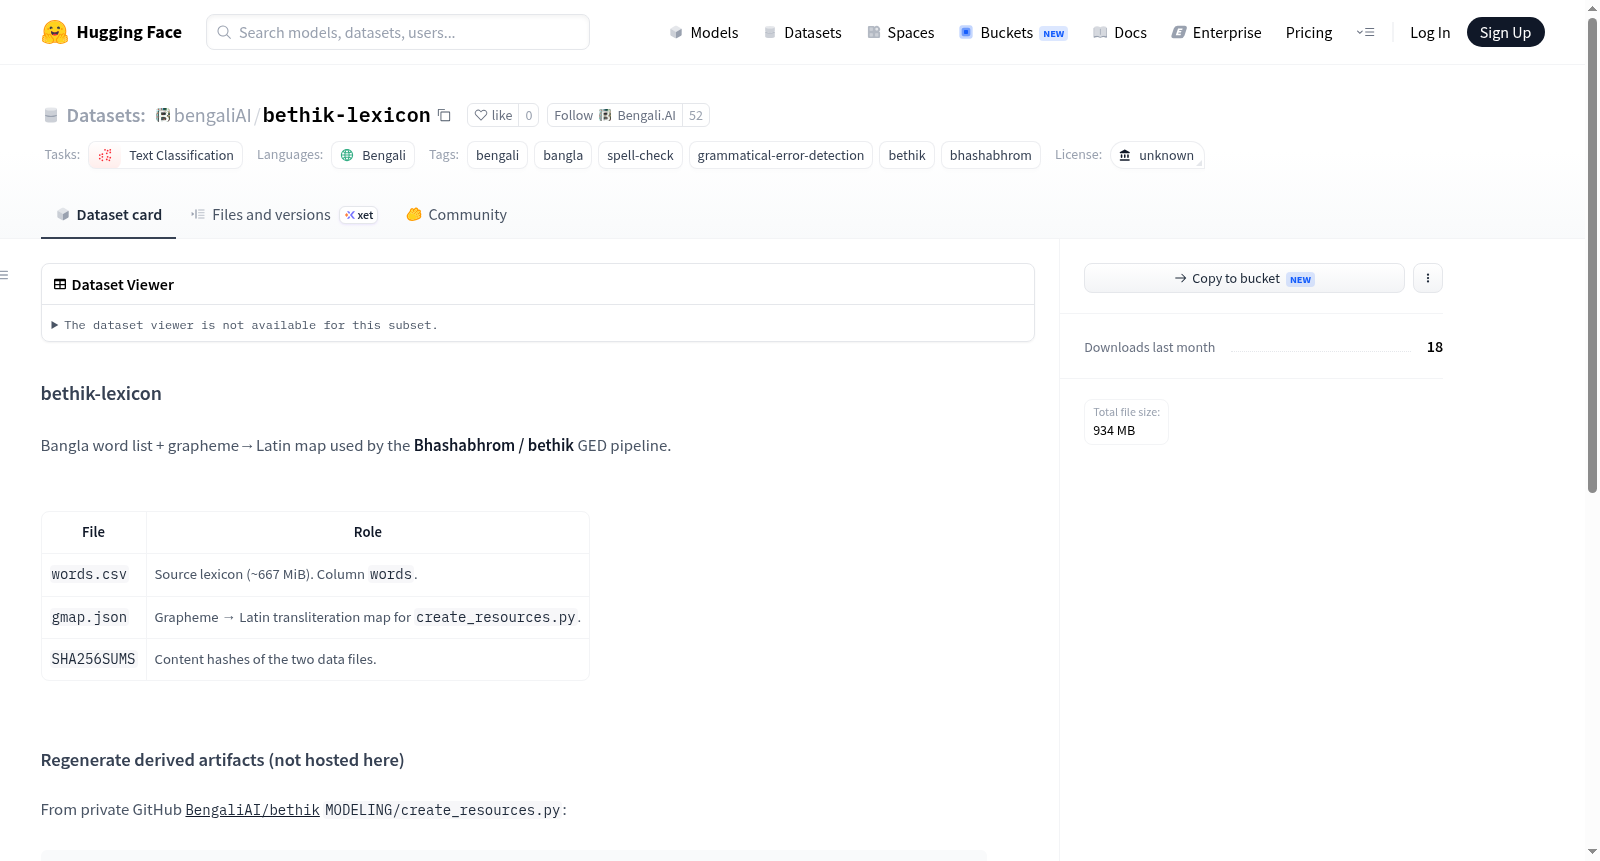
bethik-lexicon是一个用于孟加拉语语法错误检测(GED)的数据集,包含孟加拉语单词列表和字素到拉丁字母的映射。它用于Bhashabhrom/bethik GED管道,支持拼写检查和语法错误检测任务。数据集包括两个主要文件:words.csv(源词典,约667 MiB,包含单词列)和gmap.json(用于资源创建脚本的映射文件)。语言为孟加拉语(bn),涉及标签包括bengali、bangla、spell-check和grammatical-error-detection。

The bethik-lexicon is a dataset dedicated to Bengali grammatical error detection (GED). It contains a list of Bengali words and a grapheme-to-Latin letter mapping. This dataset is employed in the Bhashabhrom/bethik GED pipeline to support both spell-check and grammatical error detection tasks. The dataset comprises two core files: words.csv (a source lexicon with a size of approximately 667 MiB, including a word column) and gmap.json (a mapping file for resource creation scripts). The language of the dataset is Bengali (bn), and its associated tags include bengali, bangla, spell-check, and grammatical-error-detection.
提供机构:
bengaliAI
搜集汇总
数据集介绍
bengaliAI/bethik-lexicon 数据集图片
构建方式
bethik-lexicon数据集的构建旨在支持孟加拉语的语法错误检测(GED)流程,其核心资源包括一个包含约667 MiB词汇的words.csv文件,以及一个用于将孟加拉语字素映射为拉丁字母的gmap.json文件。这些原始数据通过私有代码库中的create_resources.py脚本处理,可生成trans.csv、trans.json和weights.npy等衍生文件,这些文件总计约5.9 GB,可通过脚本自行再生,从而保证了数据源的透明性与可重复性。
特点
该数据集的特点在于其作为孟加拉语拼写与语法错误检测管道的基石,词汇量庞大且专注于语言规范性任务。字素到拉丁字母的映射机制为多语种处理提供了桥梁,尤其适合需要音译的NLP应用。数据集完整性通过SHA256校验和得到验证,确保内容未遭篡改。尽管许可证状态尚不明确,但当前在HuggingFace上的公开托管已允许社区访问与研究使用。
使用方法
使用bethik-lexicon数据集时,可直接加载words.csv中的词汇列表作为孟加拉语词典,或利用gmap.json实现字素到拉丁字母的转换。推荐通过运行create_resources.py脚本(位于BengaliAI/bethik仓库中)来再生完整的GED管道所需文件,从而获得trans.csv等结构化数据。这些资源可进一步用于训练或评估文本分类模型,特别是在Kaggle孟加拉语语法错误检测竞赛的上下文中应用。
背景与挑战
背景概述
Bethik-lexicon数据集由孟加拉语AI研究社区于2026年创建,旨在支持孟加拉语的拼写检查与语法错误检测(GED)任务。该数据集的核心贡献在于提供了一个包含约667 MiB词汇量的孟加拉语词表(words.csv)以及一份音素-拉丁转写映射图(gmap.json),为后续的语法错误检测管线提供了基础资源。该数据集源于Kaggle上的孟加拉语GED竞赛,其设计初衷是解决孟加拉语自然语言处理中资源匮乏的瓶颈问题。通过标准化词汇表示与转写规则,Bethik-lexicon为研究人员提供了可复现的实验基础,推动了低资源语言中文本纠错与语法分析领域的发展。
当前挑战
该数据集面临的核心挑战包括:其一,孟加拉语作为低资源语言,其拼写变体与语法错误模式多样,缺乏大规模标注语料支持模型泛化;其二,音素-拉丁转写映射的准确性直接影响下游GED性能,需处理孟加拉语复杂的连字与元音符号系统;其三,数据集构建中需要平衡词汇覆盖度与存储效率(衍生工件约5.9 GB),且许可状态不明确限制了公开重分发与商业应用。此外,词表中可能包含噪声词汇或过时用法,需持续维护以保持与真实语言使用的一致性。
常用场景
经典使用场景
在孟加拉语自然语言处理领域,Bethik词库作为拼写检查与语法错误检测(GED)的核心资源,承载着构建高精度语言校正模型的基础使命。该数据集包含约667 MiB的孟加拉语单词列表及其对应的字素到拉丁字母的转写映射,为开发者提供了统一的词汇基准和音译桥梁。经典的使用场景包括:基于统计或神经网络的拼写纠错系统训练、字素级嵌入表示学习,以及跨模态的语法错误检测管道构建。通过将原始词表与映射文件输入指定的资源生成脚本,可产出词汇转写表、向量权重等衍生工件,从而支撑起端到端的语言校正推理流程。这一设计使得研究者和工程师能够聚焦于模型架构与算法创新,而非重复造数据预处理轮子。
实际应用
在孟加拉语信息化建设的实际浪潮中,Bethik词库为多类社会场景注入了精准的语言矫正能力。典型的落地应用涵盖孟加拉语输入法中的智能拼写建议、新闻出版系统中的自动校对模块,以及教育科技领域的学生作文语法批改工具。例如,面向孟加拉本土的移动端写作助手可利用该词库快速建立用户词典,从而识别非标准拼写(bethik形式)并提供规范化的替换建议。此外,在政府公文处理与电商客服对话的语义质量管控中,基于该数据集训练的GED管道能够有效降低因拼写错误导致的歧义解读,提升人机交互的自然度与效率。这些实际案例充分彰显了该数据集从学术资源转化为生产工具的纽带价值。
衍生相关工作
Bethik词库作为孟加拉语GED竞赛与开源工具链的核心枢纽,已衍生出多个标志性工作。最直接的当属Kaggle平台举办的Bengali GED竞赛,该赛事依托此词库构建了标准化的训练-验证-测试划分,催生了一批基于Transformer架构与字符级CNN融合的顶尖方案。与此同时,关联的私有仓库BengaliAI/bethik中整合了词汇折叠(fold)策略、人工标注样例及私密测试集,构成了完整的模型迭代与消融实验体系。此外,研究者围绕该词库衍生了字素嵌入预训练任务、跨语言迁移学习基线,以及结合词形还原的端到端纠正管道;这些工作不仅验证了数据集的扩展性,还推动了孟加拉语计算资源建设中“数据集-竞赛-工具链”三位一体的生态模式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

