
遇见数据集

ZurichNLP/romansh-mt-evaluation

收藏
Hugging Face2026-07-12 更新2026-03-29 收录
官方服务:

资源简介:

该数据集包含对从德语翻译成六种罗曼什语变体机器翻译结果的人工评估结果。评估由相应罗曼什语方言的母语者以及专业语言学家进行。评估涵盖三个质量维度:- **文档准确性**,其中标注者评估完整文档翻译的充分性。- **片段准确性**,其中标注者为文档中的单个片段选择更准确的翻译。- **片段流畅性**,其中标注者评估单个翻译片段的流畅性。对于文档准确性任务,标注者会看到同一源文档的两个完整翻译。每个翻译获得0到6之间的分数,标注者还指示每个单独片段的优选翻译。对于片段流畅性任务,标注者独立于文档上下文评估翻译片段对,并为每个片段分配0到6之间的分数。

This dataset contains the results of a human evaluation of machine translations from German into the six Romansh varieties. The evaluations were carried out by native speakers of the respective Romansh idioms as well as professional linguists. The evaluation covers three quality dimensions: - **Document accuracy**, in which annotators assessed the adequacy of complete document translations. - **Segment accuracy**, in which annotators selected the more accurate translation for individual segments within the document. - **Segment fluency**, in which annotators assessed the fluency of individual translated segments. For the document accuracy task, annotators were presented with two complete translations of the same source document. Each translation received a score between 0 and 6, and annotators additionally indicated the preferred translation for each individual segment. For the segment fluency task, annotators evaluated pairs of translated segments independently of their document context and assigned each segment a score between 0 and 6.
提供机构:
ZurichNLP
搜集汇总
数据集介绍
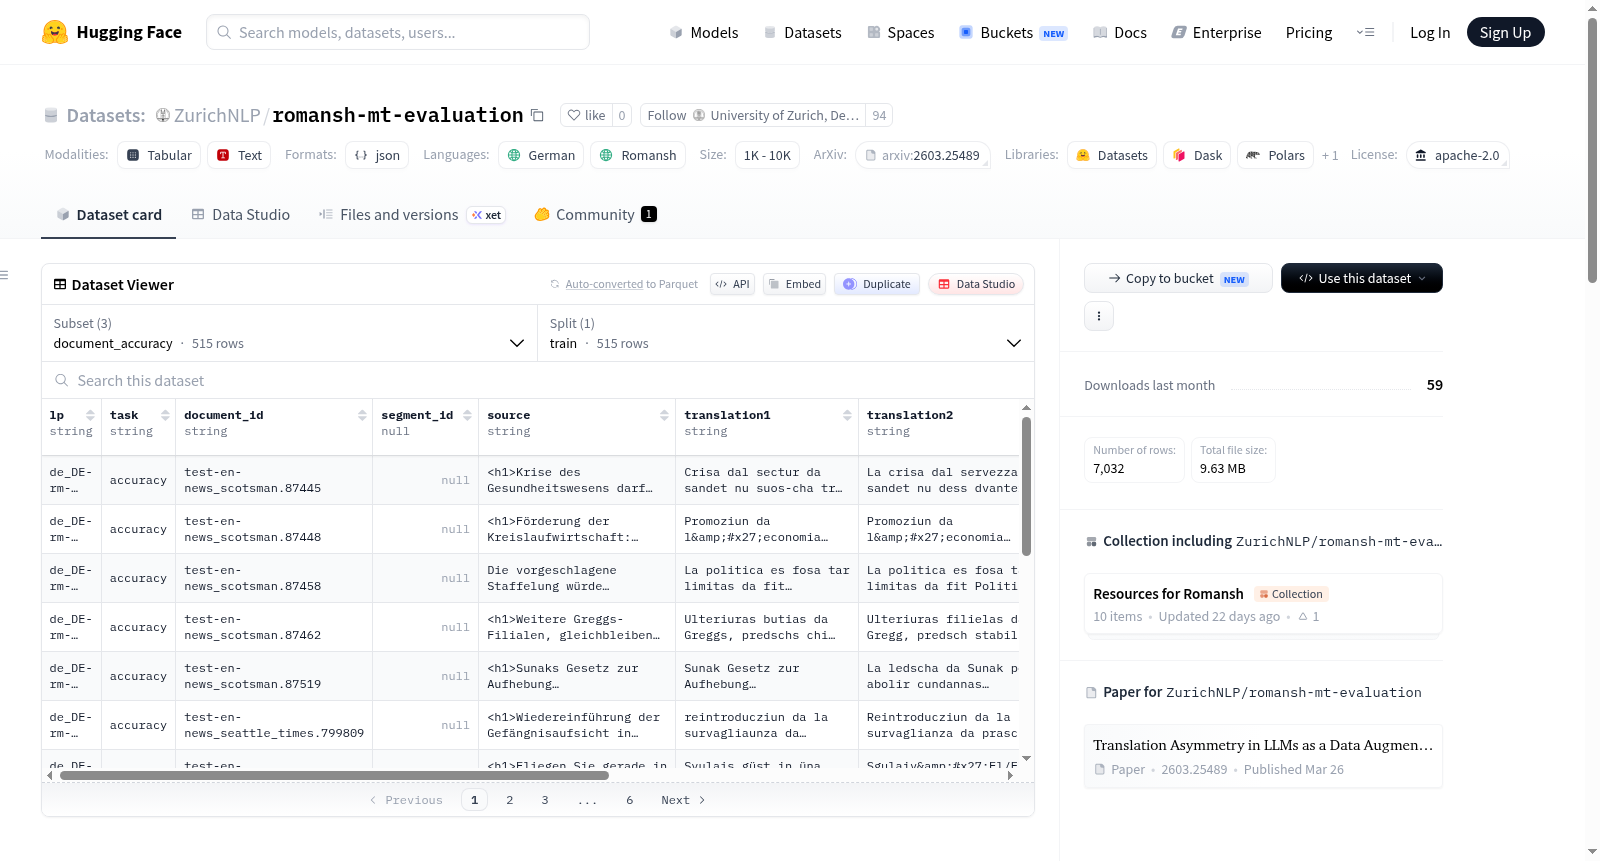
ZurichNLP/romansh-mt-evaluation 数据集图片
构建方式
该数据集源自针对德语至六种罗曼什方言机器翻译结果的人工评估,评估由对应方言母语者与职业语言学家共同完成。数据集构建覆盖三大质量维度:文档准确性、片段准确性与片段流利度。在文档准确性任务中,标注者需评估同一源文档的两个完整译稿,并为每个译文赋予0至6的评分,同时指明每段的首选译文。片段准确性任务中,标注者从两个候选译文中挑选更优者,片段流利度任务则要求独立于文档语境对成对译段进行0至6的评分。所有原始评分与归一化数值均被记录,并附有标注者标识符与语种对信息。
特点
该数据集具备多层次、细粒度的评估结构,覆盖从整篇文档到单个片段的三个维度,提供了综合性的翻译质量画像。数据集中每个译文候选均标注了来源系统:包括Gemini Pro、针对罗曼什语微调的NLLB模型以及人工参考译文。评分同时保留原始值与归一化值,适应不同分析需求。此外,通过文档与片段标识符可实现多标注者之间的一致性比对。源文本与参考译文取自WMT24++基准,确保了数据来源的权威性与可复现性。
使用方法
该数据集可通过HuggingFace Datasets库加载,使用前需指定配置名称以选择评估维度,可选配置包括document_accuracy、segment_accuracy与segment_fluency。各配置均包含train分片,数据格式为JSONL。用户可利用lp字段筛选特定语种对,通过task字段区分评估任务类型。评分列(rating1、rating2及其原始版本)可直接用于计算系统间的相对性能,document_id与segment_id支持跨标注者的一致性分析。推荐参考Vamvas等人(2026)的论文以获取更详尽的分析示例与评估协议。
背景与挑战
背景概述
该数据集由苏黎世大学等机构的研究人员于2026年创建,聚焦于罗曼什语这一瑞士少数语言的机器翻译质量评估。罗曼什语包含六种方言变体,资源匮乏且形态复杂,长期以来在神经机器翻译研究中面临数据稀缺与评估标准缺失的双重困境。该数据集以德语到六种罗曼什语方言的翻译为对象,通过母语者与语言学家的联合标注,覆盖文档准确度、片段准确度与片段流利度三个质量维度,首次建立了一个系统化、多维度的人工评估基准。它不仅为WMT24++基准的扩展提供了补充资源,更因引入基于大语言模型(如Gemini Pro)与传统模型(如NLLB)的对比评估,推动了低资源语言机器翻译评估方法学的进步,对语言多样性与技术公平性的研究具有深远影响。
当前挑战
该数据集面临的核心挑战在于低资源语言评估本身所固有的复杂性。一方面,罗曼什语各方言间的差异性使得构建统一、可靠的评估标准极为困难,标注者需同时具备方言能力与语言学素养,导致人工标注成本高昂且难以规模化。另一方面,现有机器翻译系统在罗曼什语上的表现参差不齐,该数据集需解决如何在不同翻译输出间进行公平比较的问题,特别是大语言模型与专用翻译模型之间的系统偏差。此外,在构建过程中,研究者还面临处理细粒度碎片级注释与全局文档级评估之间的逻辑一致性挑战,以及确保来自不同方言区的标注者之间评分标准的可靠性,这些环节共同构成了数据集构建与使用中的关键技术难题。
常用场景
经典使用场景
romansh-mt-evaluation数据集专为低资源语言机器翻译评估而设计,其经典使用场景在于对德语至六种罗曼什方言的翻译质量进行细粒度人工评测。该数据集覆盖文档准确性、片段准确性与片段流利性三个核心维度,通过母语者与语言学家的联合标注,为评估神经机器翻译系统在高度濒危且多方言语言上的表现提供了标准化基准。研究者可借助此数据集比较不同翻译架构(如通用大模型Gemini Pro与领域微调模型Romansh NLLB)在复杂语言变体下的输出质量,从而推动面向少数族裔语言的翻译技术发展。
解决学术问题
该数据集解决了机器翻译领域长期存在的低资源、多方言场景下评测标准缺失的学术难题。传统评估依赖单一参考译文,难以捕捉方言差异与流利性变化,而romansh-mt-evaluation通过多维度人工打分和对比较优翻译的设计,量化了翻译系统在准确性、忠实度与自然度上的表现差异。这一方法为研究翻译不对称性(即不同语言变体在机器翻译中表现不一致的现象)提供了实验基础,揭示了数据增强策略在缓解低资源语言稀疏性方面的潜力,对推进机器学习在语言多样性保护中的理论建设具有重要学术意义。
衍生相关工作
该数据集衍生了多项关键研究,最直接的是Jannis Vamvas等人基于此评测结果提出的“翻译不对称性作为数据增强因素”理论,发表于arXiv(2603.25489),揭示了LLM在不同罗曼什方言间的表现差异及其对训练数据构成的依赖。此外,数据集依赖的WMT24++基准(Vamvas et al., 2025)进一步扩展了多语言机器翻译评估的边界,引入了Rumantsch Grischun等六种方言的评测体系。这些工作共同推动了低资源语言翻译评测方法的标准化,并催生了针对方言级翻译的鲁棒性研究,为后续模型蒸馏与跨语言迁移学习提供了实证参考。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

