ArXivSignals-FullText
收藏资源简介:
ArXivSignals FullText是一个持续更新、按天分区的数据集,包含通过视觉OCR流程转换为干净全文的arXiv论文。每篇论文的PDF被渲染为Markdown格式(包括标题、段落、HTML表格和LaTeX数学公式)以及一个结构化的布局JSON(包含类型化和边界框标注的块)。该数据集是taesiri/ArXivSignals(元数据+LLM信号和摘要)的全文伴侣,并通过paper_id与之关联。数据来源为公开的arXiv PDFs,使用基于Baidu家族的“Unlimited-OCR”文档视觉语言模型进行OCR处理,以4位精度逐页运行,生成Markdown、原始标记形式和类型化布局树,这是一个转录过程而非摘要重写。数据集涵盖ArXivSignals公共目录中的论文,并以最新优先的顺序持续填充,覆盖范围每日增长。数据模式包括paper_id(arXiv ID,用于连接taesiri/ArXivSignals)、announce_date(arXiv公布日期,分区键)、title和abstract(arXiv元数据)、author_names(显示名称列表)、authors_json(完整的作者结构JSON)、categories(arXiv类别列表)、primary_category(主要类别)、ocr_markdown(OCR全文,Markdown格式,包含HTML表格和LaTeX数学公式)、ocr_layout(类型化和边界框标注的布局块JSON)、pages(页数)、md_chars和n_layout_blocks(内容统计)、ocr_tokens、ocr_tps、ocr_duration_s(OCR吞吐量统计)、ocr_precision和ocr_model(OCR配置)、ocr_finished_at(OCR完成时间)。数据集适用于文本生成、文本检索和特征提取等任务,支持文档理解、布局分析和科学论文处理等应用场景。许可方面,元数据(标题、摘要、作者、类别)在CC-BY-4.0许可下提供,而OCR全文作为公开论文的衍生表示,仅用于研究和文本/数据挖掘目的,其重新分发或重用受原始论文自身许可约束。用户应始终引用原始arXiv论文(paper_id)作为内容来源,并注意OCR在数学公式、表格、多栏和扫描页面中可能存在错误,文本应被视为机器转录而非权威版本。
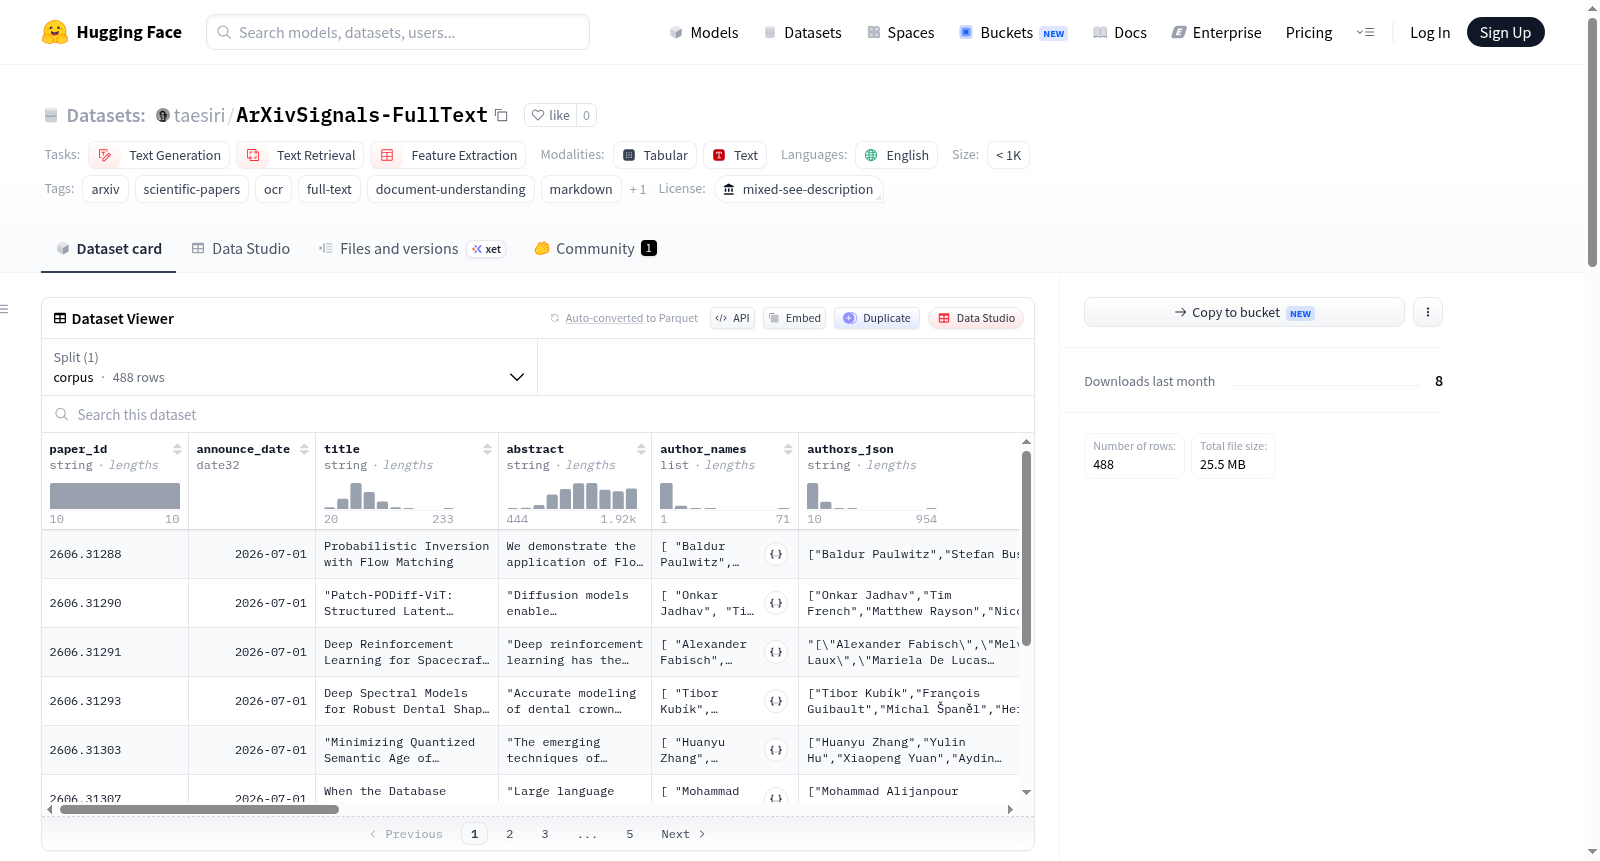
ArXivSignals FullText is a continuously updated, daily-partitioned dataset hosting arXiv papers converted into clean full texts via a visual OCR pipeline. For each paper, its PDF is rendered into Markdown format (encompassing headings, paragraphs, HTML tables, and LaTeX mathematical formulas) alongside a structured layout JSON containing typed and bounding-box annotated blocks. This dataset serves as the full-text companion to the taesiri/ArXivSignals dataset (which includes metadata, LLM signals, and abstracts), and is linked to it via the paper_id field. The dataset's source materials are publicly available arXiv PDFs, which undergo OCR processing using the Baidu-family "Unlimited-OCR" document visual-language model. The processing runs page-by-page with 4-bit precision, generating Markdown, raw markup, and typed layout trees; this is a transcription process rather than abstract rewriting. The dataset covers papers from the public ArXivSignals directory, and is continuously populated in a latest-first order, with its coverage expanding daily. The dataset schema includes: paper_id (arXiv ID for linking to taesiri/ArXivSignals), announce_date (arXiv announcement date, partition key), title and abstract (arXiv metadata), author_names (list of displayed author names), authors_json (full author structure in JSON format), categories (list of arXiv categories), primary_category (primary arXiv category), ocr_markdown (OCR full text in Markdown format, including HTML tables and LaTeX mathematical formulas), ocr_layout (JSON of typed and bounding-box annotated layout blocks), pages (total number of pages), md_chars and n_layout_blocks (content statistics), ocr_tokens, ocr_tps, ocr_duration_s (OCR throughput statistics), ocr_precision and ocr_model (OCR configuration parameters), ocr_finished_at (OCR completion time). This dataset is suitable for tasks including text generation, text retrieval, and feature extraction, and supports application scenarios such as document understanding, layout analysis, and scientific paper processing. In terms of licensing, metadata (title, abstract, authors, and categories) is provided under the CC-BY-4.0 license. The OCR full text, as a derivative representation of public papers, is intended solely for research and text/data mining purposes. Its redistribution or reuse is governed by the original licenses of the respective source arXiv papers. Users must always cite the original arXiv paper (identified by its paper_id) as the content source, and should note that OCR may introduce errors in mathematical formulas, tables, multi-column layouts, and scanned pages; the transcribed text should be treated as a machine-transcribed version rather than an authoritative one.
数据集概述
ArXivSignals FullText 是一个持续更新的、按天分区的数据集,将 arXiv 论文通过视觉 OCR 管道转换为干净的全文。每篇论文的 PDF 被渲染为 Markdown 格式(包含标题、段落、HTML 格式的表格和 LaTeX 数学公式),并附带结构化的布局 JSON(包含有类型和边界框的文本块)。它是 taesiri/ArXivSignals 数据集的全文补充,二者通过 paper_id 字段关联。
数据来源与处理方式
- 来源:arXiv 上公开可用的 PDF 文件。
- OCR 技术:使用文档视觉语言模型(百度系列 "Unlimited-OCR" 通过 MLX 实现),以 4-bit 精度逐页运行,生成 Markdown、原始标记形式以及有类型的布局树。整个过程是转录,而非摘要或重写,不涉及 LLM 重写。
- 覆盖范围:仅包含那些在公开的 ArXivSignals 目录中存在的论文。数据集持续填充,最新论文优先,覆盖范围每日增长。
数据模式 (papers 配置,按 announce_date 分区)
| 列名 | 类型 | 说明 |
|---|---|---|
paper_id |
字符串 | arXiv ID(用于关联 taesiri/ArXivSignals) |
announce_date |
日期 | arXiv 公告日期(分区键) |
title, abstract |
字符串 | arXiv 元数据 |
author_names |
列表<string> | 作者显示名 |
authors_json |
字符串 | 完整作者结构(JSON 格式) |
categories |
列表<string> | arXiv 分类 |
primary_category |
字符串 | 主要分类 |
ocr_markdown |
字符串 | OCR 后的全文(Markdown 格式;HTML 表格;LaTeX 数学公式) |
ocr_layout |
字符串 | 带类型和边界框的布局块(JSON 格式:{items:[{page,type,bbox,content}]}) |
pages |
整数 | 页数 |
md_chars, n_layout_blocks |
整数 | 内容统计 |
ocr_tokens, ocr_tps, ocr_duration_s |
数值 | OCR 处理效率统计 |
ocr_precision, ocr_model |
字符串 | OCR 配置 |
ocr_finished_at |
字符串 | 该论文完成 OCR 的时间 |
加载示例
python from datasets import load_dataset ds = load_dataset("taesiri/ArXivSignals-FullText", "papers", split="corpus") print(ds[0]["ocr_markdown"][:500])
许可、署名与删除
- OCR 内容许可:
ocr_markdown和ocr_layout字段是 arXiv PDF 的机器生成转录。arXiv 论文由作者单独授权(遵循 arXiv 默认的非排他性许可,或 CC-BY / CC-BY-SA / CC0 等),该许可决定了 OCR 文本底层内容的版权。本数据集不授予超出源论文的任何权利。 - 元数据许可:标题、摘要、作者、分类等元数据根据 CC-BY-4.0 许可提供。
- 使用目的:OCR 全文仅用于研究和文本/数据挖掘,是公开可用论文的衍生表示。重新分发或重用任何论文的文本需遵循该论文自身的许可。
- 署名要求:引用内容时,必须引用原始 arXiv 论文(通过
paper_id),而非本数据集。 - 错误声明:OCR 不完美,数学公式、表格、多列布局和扫描页面可能存在错误,应将文本视为机器转录,而非权威版本。
- 删除/退出机制:如果您是作者(或版权持有者)并希望删除某篇论文,请在该数据集仓库中提交 issue/discussion,将及时处理。
维护与相关链接
- 维护者:@taesiri
- 驱动网站:arxivsignals.io
- 关联数据集:
taesiri/ArXivSignals