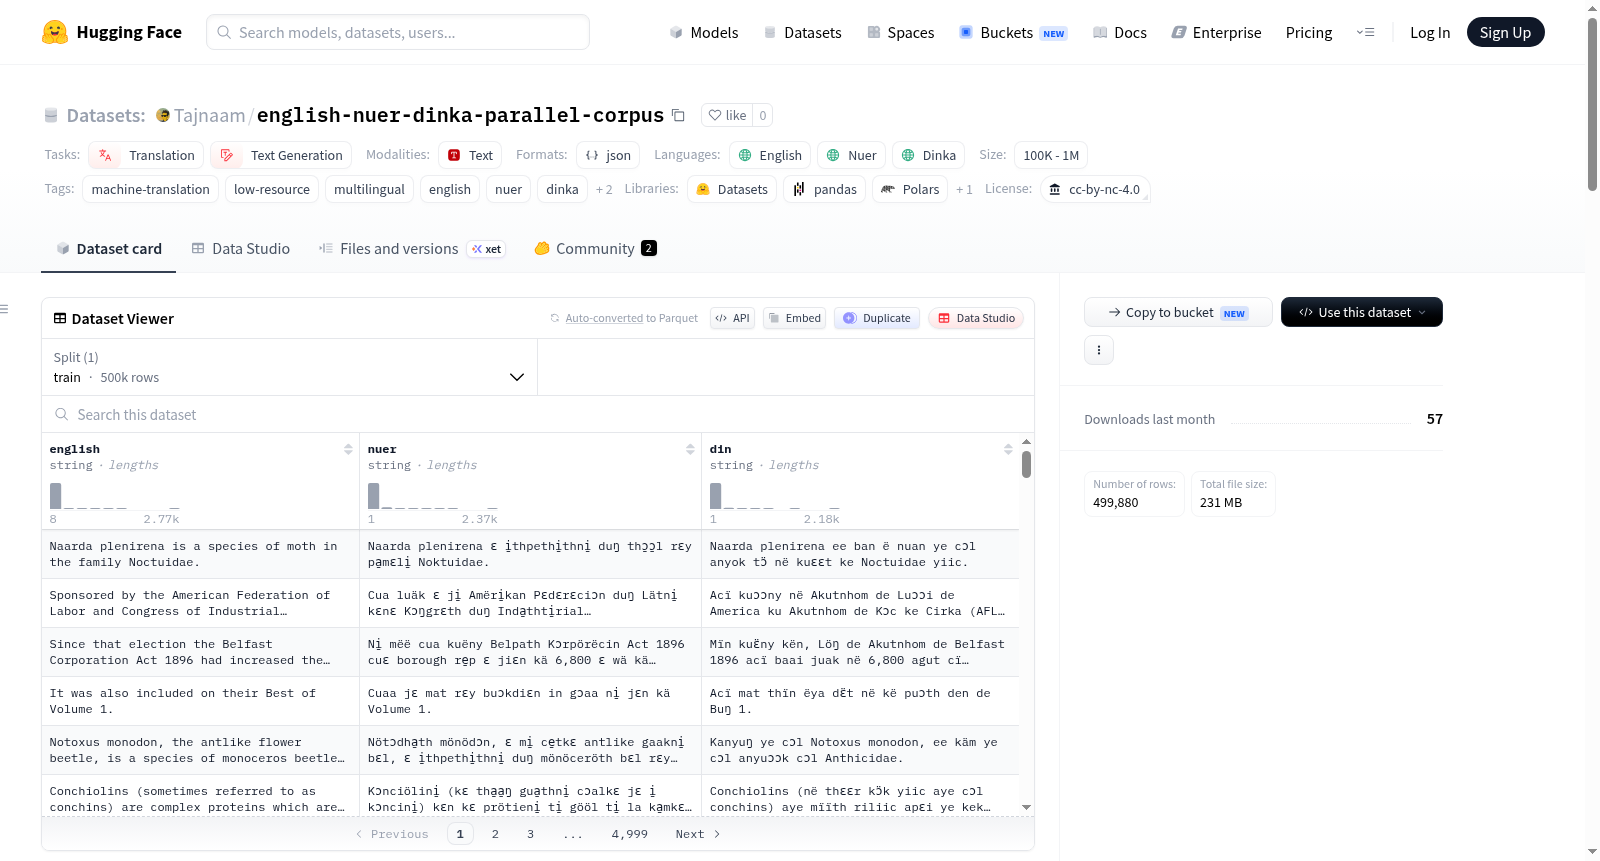
english-nuer-dinka-parallel-corpus
收藏资源简介:
英语-努尔语-丁卡语平行语料库是一个多语言平行数据集,旨在支持低资源非洲语言的研究。该语料库包含英语、努尔语和丁卡语三种语言的对齐文本,适用于自然语言处理(NLP)、机器翻译(MT)、多语言语言建模和语言保护等领域。数据集的主要目标是增加努尔语和丁卡语在数字领域的可见性,并帮助研究人员为这些代表性不足的语言开发更好的语言技术。语料库包含英语(en)、努尔语(nus)和丁卡语(din)的文本。数据集适用于学术研究、教育目的、机器翻译、多语言NLP、大语言模型(LLM)研究、语言记录、语言学分析以及低资源语言模型的基准测试。数据集采用知识共享署名-非商业性使用4.0国际许可协议(CC BY-NC 4.0)发布,允许共享、复制、重新分发、改编和修改,但必须注明出处,且不得用于商业目的。
The English-Nuer-Dinka Parallel Corpus is a multilingual parallel dataset designed to support research on low-resource African languages. This corpus contains aligned texts in three languages: English, Nuer, and Dinka, and is applicable to fields such as natural language processing (NLP), machine translation (MT), multilingual language modeling, and language documentation. The primary goal of this dataset is to increase the digital visibility of Nuer and Dinka, and to assist researchers in developing better language technologies for these underrepresented languages. The corpus includes texts in English (en), Nuer (nus), and Dinka (din). This dataset is suitable for academic research, educational purposes, machine translation, multilingual NLP, large language model (LLM) research, language documentation, linguistic analysis, and benchmarking of low-resource language models. This dataset is released under the Creative Commons Attribution-NonCommercial 4.0 International Public License (CC BY-NC 4.0), which permits sharing, copying, redistribution, adaptation, and modification, provided that proper attribution is given and the dataset is not used for commercial purposes.
数据集名称
English–Nuer–Dinka Parallel Corpus
数据集概况
该数据集是一个多语言平行语料库,包含英语(en)、努埃尔语(nus)和丁卡语(din)的对齐文本,旨在支持低资源非洲语言的自然语言处理(NLP)、机器翻译(MT)、多语言语言建模及语言保护研究。
主要目标
提升努埃尔语和丁卡语的数字存在感,帮助研究人员为这些代表性不足的语言构建更好的语言技术。
语言
- 英语(en)
- 努埃尔语(nus)
- 丁卡语(din)
预期用途
- 学术研究
- 教育用途
- 机器翻译
- 多语言自然语言处理
- 大语言模型研究
- 语言文档记录
- 语言分析
- 低资源语言模型基准测试
非预期用途(禁止商业使用)
- 商业人工智能产品
- 商业翻译服务
- 付费API
- 专有语言模型
- SaaS产品
- 商业性销售或再分发数据集
- 商业使用需事先获得数据集作者书面许可
许可证
Creative Commons Attribution-NonCommercial 4.0 International (CC BY-NC 4.0)
许可协议链接:https://creativecommons.org/licenses/by-nc/4.0/
允许:
- 分享、复制、再分发、改编、修改
条件:
- 必须提供适当署名
- 不得用于商业目的
- 在发表的研究中引用本数据集
引用格式
bibtex @dataset{tajnaam2026englishnuerdinka, author = {Tajnaam}, title = {English–Nuer–Dinka Parallel Corpus}, year = {2026}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/Tajnaam/english-nuer-dinka-parallel-corpus} }
免责声明
数据集按“原样”提供,不提供任何形式的保证,作者不对任何滥用行为负责。
联系与协作
如有问题、合作或商业许可需求,请通过Hugging Face仓库联系数据集作者。