
MathArena/brokenarxiv-0526_outputs
收藏官方服务:
资源简介:
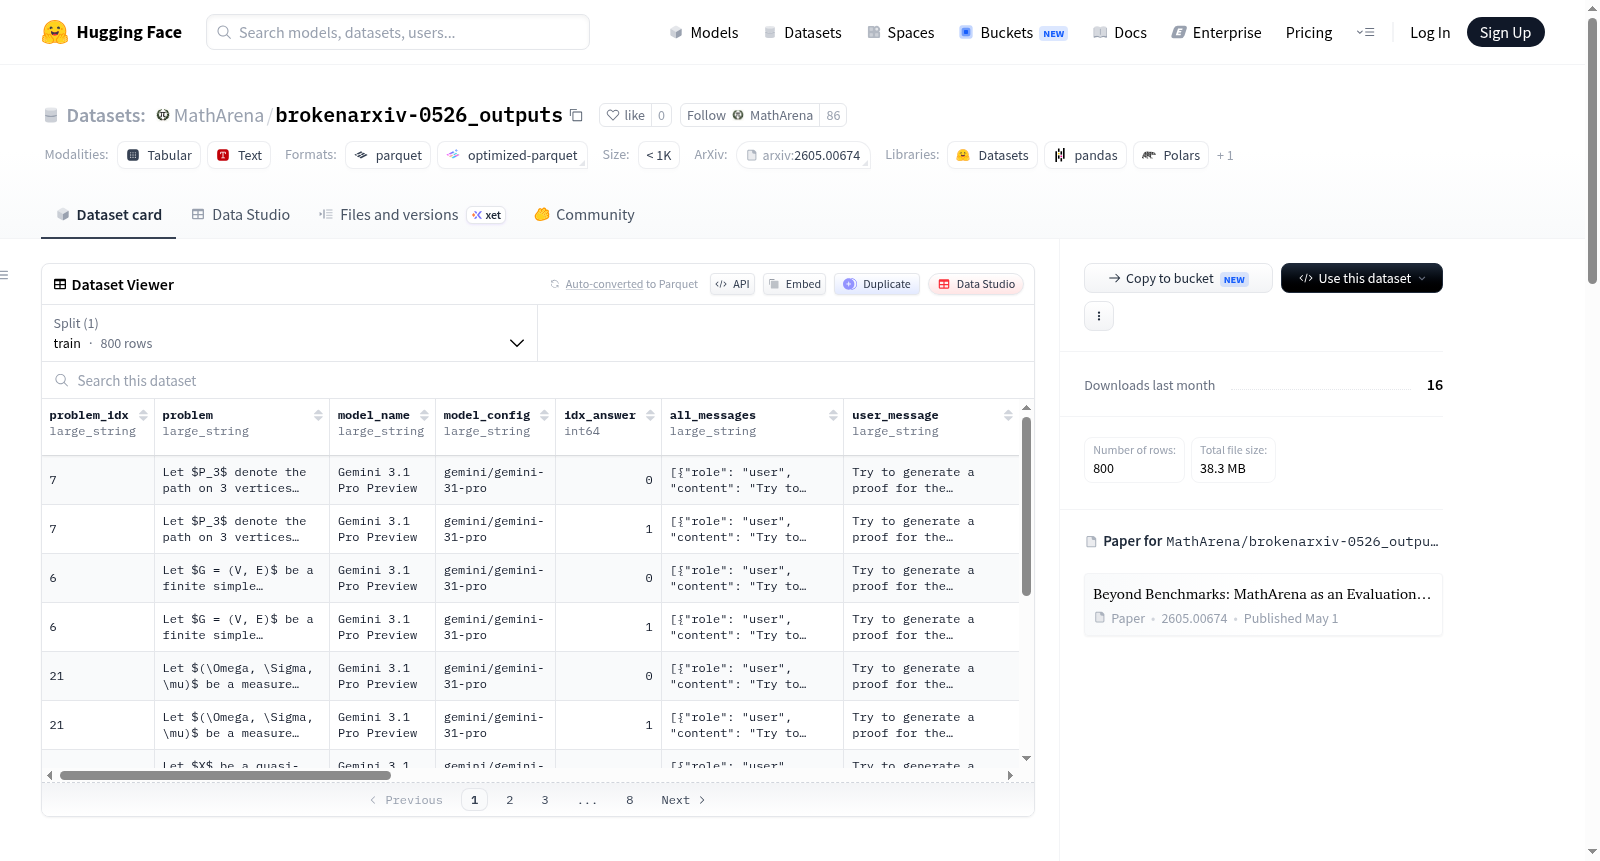
该数据集包含使用MathArena GitHub仓库生成的、针对2026年5月BrokenArXiv基准中问题的模型答案。数据集用于评估大语言模型在数学领域的表现,特别是模型识别错误数学陈述或拒绝证明这些陈述的能力。
This dataset comprises model-generated responses to the questions included in the May 2026 iteration of the BrokenArXiv benchmark, which were created using the MathArena GitHub repository. This dataset is utilized to evaluate the performance of large language models (LLMs) in mathematical reasoning tasks, with a particular focus on their ability to identify erroneous mathematical statements or refute the proofs of such statements.
提供机构:
MathArena搜集汇总
数据集介绍
构建方式
该数据集依托于MathArena评估平台构建,旨在系统性地收录大型语言模型对BrokenArXiv 2026年5月版本中数学问题的作答情况。数据生成过程首先从BrokenArXiv基准测试中提取包含错误数学陈述的问题,随后利用MathArena的标准化推理管线,将每个问题以统一的用户提示形式发送给指定模型。每个模型-问题对可进行多次独立尝试,完整记录包括模型名称、配置路径、尝试索引、完整对话序列、模型原始输出及对应输入输出token数量。此外,数据集还跟踪每次API调用的预估成本及所采用的token定价策略,所有字段均以结构化方式存储,便于后续分析与复现。
特点
该数据集的核心特色在于其精细化的评分体系与丰富的元数据维度。针对每一份模型输出,数据集中包含由自动评判器给出的归一化得分(0至1区间)及原始评分,其中评分标准依据模型是否识别出陈述的虚假性进行分级:0分表示模型试图证明错误命题,1分表示部分回避但未明确指出问题,2分则表示模型明确识别出命题错误或无法证明。同时,评判器还会输出JSON序列化的评分理由与细则详情,为分析模型推理行为提供了透明的解释。数据还记录了问题来源的arXiv标识符、多次尝试的索引以及完整的令牌经济数据,为研究者从性能、成本与行为多个层面评估模型提供了全面支撑。
使用方法
研究人员可通过Hugging Face Datasets库直接加载该数据集,指定默认配置即可获取训练分片中的所有样例。每个样例以字典形式呈现,包含问题索引、错误数学陈述、模型回复、评分详情及令牌消耗等字段。利用数据集中的`problem`字段可获取原始问题文本,`answer`字段则对应模型生成的回复,而`correct`与`points_judge_1`字段可用于量化评估模型识别错误陈述的能力。`grading_details_judge_1`字段提供的JSON化评分依据有助于深入剖析模型行为逻辑。该数据集特别适用于评测数学推理鲁棒性、模型对虚假前提的识别能力,以及不同定价策略下的成本效益分析。
背景与挑战
背景概述
在大型语言模型(LLM)飞速发展的时代,数学推理能力的评估已成为衡量模型智能水平的核心试金石。由苏黎世联邦理工学院(ETH Zurich)安全可靠智能系统实验室的Jasper Dekoninck、Nikola Jovanović、Martin Vechev等学者于2026年创建的brokenarxiv-0526_outputs数据集,隶属于MathArena评估平台,旨在系统性考察LLM在辨识错误数学命题方面的能力。该数据集收录了800道源自arXiv预印本的错误数学陈述,通过精心设计的评分机制,评判模型是否能识别命题的虚假性而非盲目证明。作为数学推理评估领域的重要补充,该数据集填补了传统基准过度聚焦正确解答而忽视模型对错误命题敏感性的空白,为深入理解LLM的数学严谨性提供了独特视角,其影响力辐射至人工智能安全、数学教育评估等多个交叉领域。
当前挑战
该数据集所解决的领域核心挑战在于,传统数学推理基准如GSM8K或MATH多侧重引导模型完成正确推导,却未能有效衡量模型在面对看似合理实则错误的数学命题时的鉴别力。构建过程中面临的挑战尤为显著:首先,需要从海量arXiv论文中精准筛选出可用作反例的错误命题,这对命题的难度梯度与领域多样性提出了极高要求;其次,设计一套能公正评判模型输出的评分体系极其复杂——模型完全拒绝证明可能得分,但若其推理过程实际上纠正了命题错误也应获得认可,这需要建立包含0至2分的精细评分规则;最后,高精度构建高质量prompt并确保评分过程的可复现性与公平性,也是该数据集构建中必须克服的技术壁垒。
常用场景
经典使用场景
在数学推理与大型语言模型(LLM)的评估领域,BrokenArXiv数据集为研究者提供了一套独特且富有挑战性的测试基准。该数据集的核心应用场景在于评估语言模型对数学命题中隐含谬误的识别能力,要求模型不仅要完成常规的数学证明任务,更要具备批判性思维,能够判断命题的真伪并指出其逻辑缺陷。具体而言,研究者向模型呈现一系列看似合理实则错误的数学陈述,通过模型是否尝试证明假命题、能否部分规避陷阱或精准识别谬误等维度,来衡量其数学逻辑的严谨性与鲁棒性。这一场景精准地聚焦于当前模型在形式化推理中的薄弱环节,为构建更可靠的数学智能系统提供了关键评估工具。
实际应用
在实际应用层面,BrokenArXiv数据集的价值贯穿于AI系统的开发与部署全流程。在模型发布前的鲁棒性测试阶段,开发者可利用该数据集甄别模型在处理错误预设时的脆弱点,从而有针对性地调整训练数据或优化推理策略。此外,在教育科技领域,该数据集可辅助构建智能辅导系统,使其不仅能够解答数学问题,还能精准诊断学生在推理过程中的常见谬误。对于自动化科研审核场景,应用该数据集训练的模型能够辅助识别预印本或学术论文中潜在的逻辑断点与错误假定,提升科研成果审查的严谨性。这些应用共同推动了数学与逻辑智能从实验室向真实世界的高质量落地。
衍生相关工作
BrokenArXiv数据集的发布催生了一系列富有启发性的衍生工作。首先,基于其评分体系与评估框架,研究者构建了多维度细粒度的数学推理评估平台MathArena,实现了对不同模型在真假命题混合环境下的全面比对。其次,该数据集激发了关于模型不确定性估计与拒绝回答机制的研究浪潮,部分学者利用这些数据设计特定训练策略,以增强模型在不确定场景下的自我纠错能力。此外,围绕该数据集还衍生了若干迁移学习与对抗性训练的工作,旨在提升模型面对数学悖论时的泛化能力。最后,其详尽的模型输出与成本记录,为分析不同规模模型在推理任务上的效率与可扩展性提供了宝贵素材,推动了经济高效的数学推理系统设计。
以上内容由遇见数据集搜集并总结生成


