
open-wiki-email-templates
收藏官方服务:
资源简介:
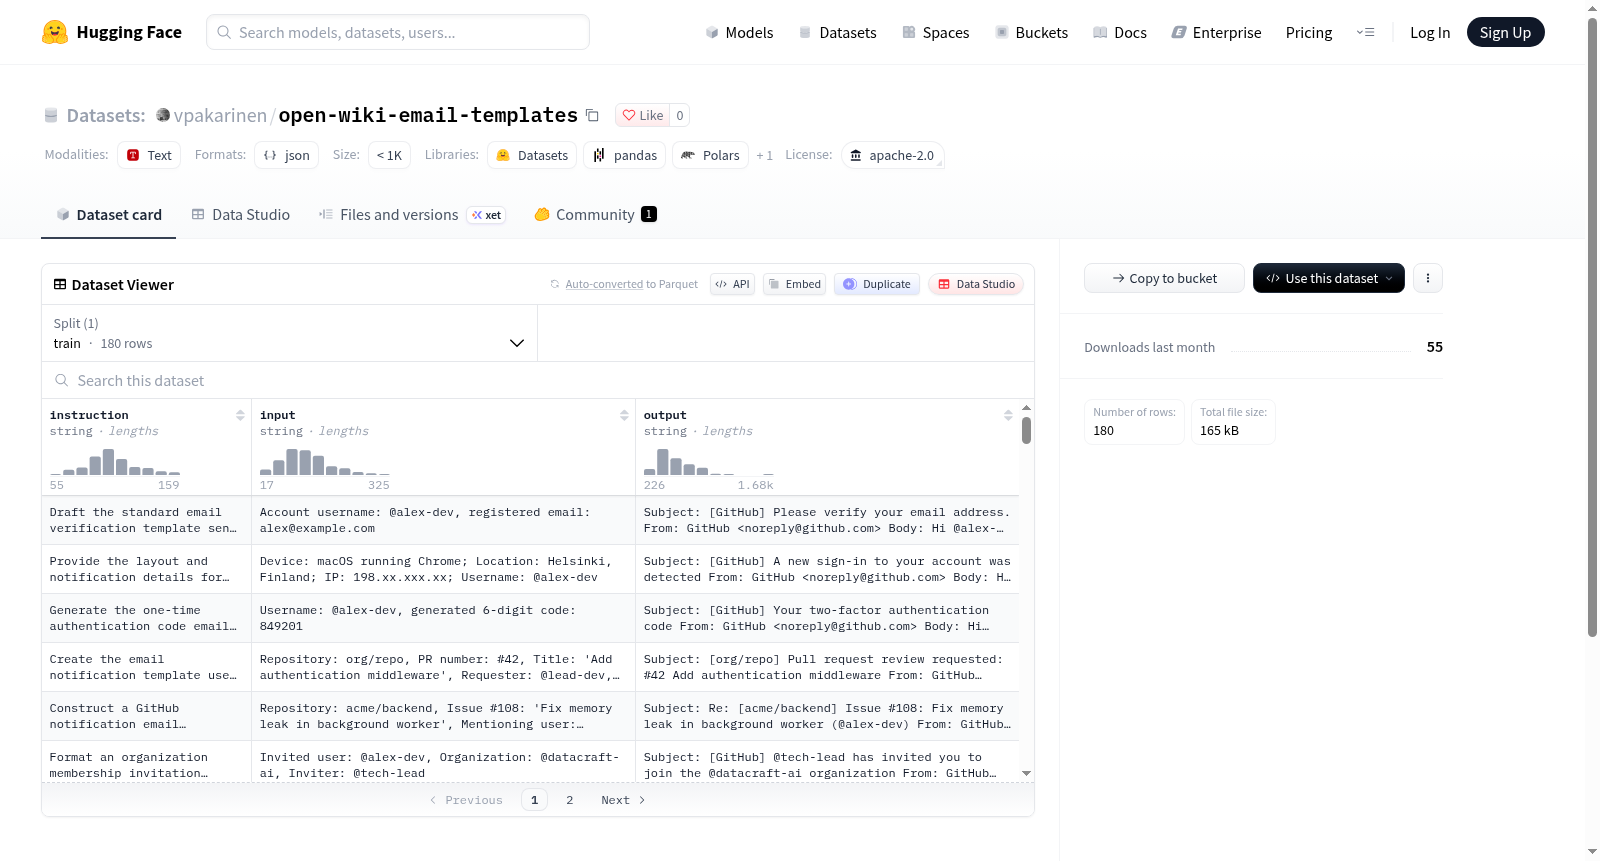
Open Wiki - Email Templates 是一个邮件模板数据集,包含来自不同公司的真实系统邮件,采用 Apache-2.0 许可协议。根据 README 的更新说明,该数据集包含 180 行数据,并新增了多家美国银行的系统邮件。README 未提供字段结构、采集方式、具体公司列表或明确的适用任务等更多细节。
Open Wiki - Email Templates is an email template dataset containing real system emails from different companies, licensed under Apache-2.0. According to the README update notes, the dataset contains 180 rows of data and has added system emails from several U.S. banks. The README does not provide further details such as field structure, collection method, specific company list, or explicit applicable tasks.
创建时间:
2026-10-31
原始信息汇总
Open Wiki - Email Templates 数据集概述
基本信息
- 数据集名称:Open Wiki - Email Templates
- 数据集地址:https://huggingface.co/datasets/vpakarinen/open-wiki-email-templates
- 许可证:Apache-2.0
内容描述
- 来自不同公司的真实系统电子邮件消息。
更新信息
- 更新!180 行,新增多家美国银行。
搜集汇总
数据集介绍
构建方式
面向企业通信与邮件模板研究的语料需求,open-wiki-email-templates 以来自不同公司的真实系统电子邮件消息为素材,采用开放维基式资源组织思路加以汇集,并依据 Apache-2.0 许可对外发布。根据数据集说明,其内容并非合成生成,而是保留现实业务系统中邮件消息的原始场景特征;当前版本已整理为 180 行,并在更新中纳入多家美国银行样本。该构建路径强调跨组织、跨行业的真实文本聚合,为后续邮件模板分析、检索与模型训练提供基础语料。受页面信息所限,更细粒度的采集、清洗与匿名化流程尚未在现有说明中完整披露,使用前宜结合原始页面进一步核验。
特点
作为聚焦真实企业通信场景的数据资源,open-wiki-email-templates 的首要特征在于其样本源自不同公司的真实系统邮件消息,而非人工合成或模板化改写文本,因而能够反映现实邮件在措辞、结构与业务语境上的多样性。数据集当前规模为 180 行,更新记录显示其已加入多家美国银行样本,体现出对金融通信场景的针对性覆盖。其 Apache-2.0 许可为研究与应用提供了较为宽松的合规基础,开放维基式定位亦有利于持续扩充与社区协作。整体而言,该数据集兼具真实性、跨组织性和领域指向性,适合用于邮件模板挖掘、商务文本分析及相关自然语言处理任务。
使用方法
在自然语言处理与企业通信分析实践中,open-wiki-email-templates 可通过 Hugging Face 数据集接口进行加载与检索,研究者可围绕真实系统邮件消息开展模板归类、主题识别、风格比较、文本生成评估或跨机构通信模式分析。鉴于数据来源于现实企业邮件,使用时应严格遵守 Apache-2.0 许可条款,并关注潜在隐私、敏感信息与伦理合规问题,避免将原始邮件内容直接暴露于未授权场景。若用于模型训练或商业应用,建议先核验字段结构、样本分布与更新状态,并结合具体任务进行必要的数据清洗、合规审查与偏差评估,以保障下游应用的稳健性与合规性。
背景与挑战
背景概述
在企业通信智能化与自然语言处理交叉的研究语境中,open-wiki-email-templates 以开放式数据集形态汇集来自不同公司的真实系统邮件消息,文本涵盖通知、验证、账单与账户服务等自动化通信场景。依据其HuggingFace详情页,该数据集采用Apache-2.0许可,当前更新至180行,并扩充了多家美国银行样本;但README未明确披露创建时间、主要研究人员或所属机构。其核心研究问题可归结为真实系统邮件的模板发现、意图识别、字段抽取与跨组织泛化,并为邮件分类、生成、隐私保护与钓鱼检测等任务提供细小而贴近业务流的经验性语料。该数据集以真实性和行业异构性见长,对推动鲁棒邮件理解与合规文本处理具有参考价值。
当前挑战
在真实邮件理解与模板归纳的研究脉络中,该数据集面临的领域问题在于:系统邮件常以HTML、多部分MIME与动态占位符混合呈现,语义受公司品牌、语言风格、法规声明和时效信息影响,导致模板边界模糊、意图类别不平衡与跨域泛化困难。构建过程中的挑战同样显著:从不同企业采集真实消息须处理授权、隐私与合规约束,脱敏时又需保留可供模型学习的语义结构;邮件字段、编码、重复与嵌套引用增加清洗与去重难度;当前仅180行且近期偏向美国银行,可能引致行业与地域偏差、样本代表性不足及模板版本漂移,难以支撑大规模预训练或公平基准评估。
常用场景
经典使用场景
在系统邮件自动化与组织沟通研究领域,Open Wiki - Email Templates 以真实企业系统邮件为语料基底,覆盖不同公司账户验证、通知、警报与客户触达等通信形态。其经典使用场景在于构建邮件模板的结构化理解任务:对主题行、正文段落、签名档与动态占位符进行标注,训练模板抽取与生成模型,并以 180 行多组织样本开展跨域风格比较。研究者可据此评估模型在真实业务邮件上的泛化能力,亦可将其用于低资源条件下的模板归纳、变量槽填充与主题分类,从而揭示企业系统通信在格式、语气和合规约束上的共性规律。
实际应用
在产业实践中,该数据集可服务于邮件自动化平台的模板推荐、智能撰写与合规审查。企业可借助其真实样本识别常见系统邮件结构,优化客户通知、账户安全提醒、营销触达等场景的模板设计;安全团队可用于钓鱼邮件检测与异常模板识别,提升风险判别能力。客服与运营部门亦可利用其训练意图分类和槽位填充模块,实现工单自动分流、回复建议与多语言适配。银行业样本的加入,使金融通信场景下的严谨措辞、风险提示与监管合规要求获得更具体的语料支撑。
衍生相关工作
围绕真实系统邮件模板,相关经典工作多集中于模板归纳、文本生成、意图分类与信息抽取等方向。该数据集可被视为邮件模板生成与跨组织风格适配研究的基础资源,启发后续工作在少样本模板生成、变量感知解码、邮件主题与正文联合建模、以及隐私保护下的语料增强等路径上展开。部分研究以同类企业邮件语料构建基准,比较预训练语言模型与规则系统在模板抽取和补全上的表现,并延伸至钓鱼检测、合规审计和客户沟通质量评估。该数据集虽规模有限,却为理解真实企业邮件模板生态提供了可操作的切入点。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


