
遇见数据集

Kicaulah/script_daataset_ai

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

EcommerceAI数据集是一个高质量的合成英文电子商务客户服务对话数据集,包含完整的意图和情感标注。该数据集由5,000个对话组成,总计47,028个对话轮次,平均每个对话9.4轮。数据覆盖5种问题类别:延迟交付、收到错误商品、退款请求、商品损坏和产品咨询,以及10种产品类别和12种意图类别。所有对话均为程序生成,不包含真实客户数据,每个记录在元数据中标记为SYNTHETIC。数据集适用于微调LLMs用于客户服务聊天机器人、训练意图分类器和情感分析模型、对话状态跟踪研究等任务。

The EcommerceAI Dataset is a high-quality synthetic English-language dataset of e-commerce customer service conversations with full intent and sentiment annotations. It consists of 5,000 conversations, totaling 47,028 dialogue turns, with an average of 9.4 turns per conversation. The dataset covers 5 issue categories: Late Delivery, Wrong Item Received, Refund Request, Damaged Item, and Product Inquiry, along with 10 product categories and 12 intent classes. All conversations are programmatically generated, and no real customer data is included, with each record labeled as SYNTHETIC in metadata. It is suitable for fine-tuning LLMs for customer service chatbots, training intent classifiers and sentiment analysis models, dialogue state tracking research, and more.
提供机构:
Kicaulah
搜集汇总
数据集介绍
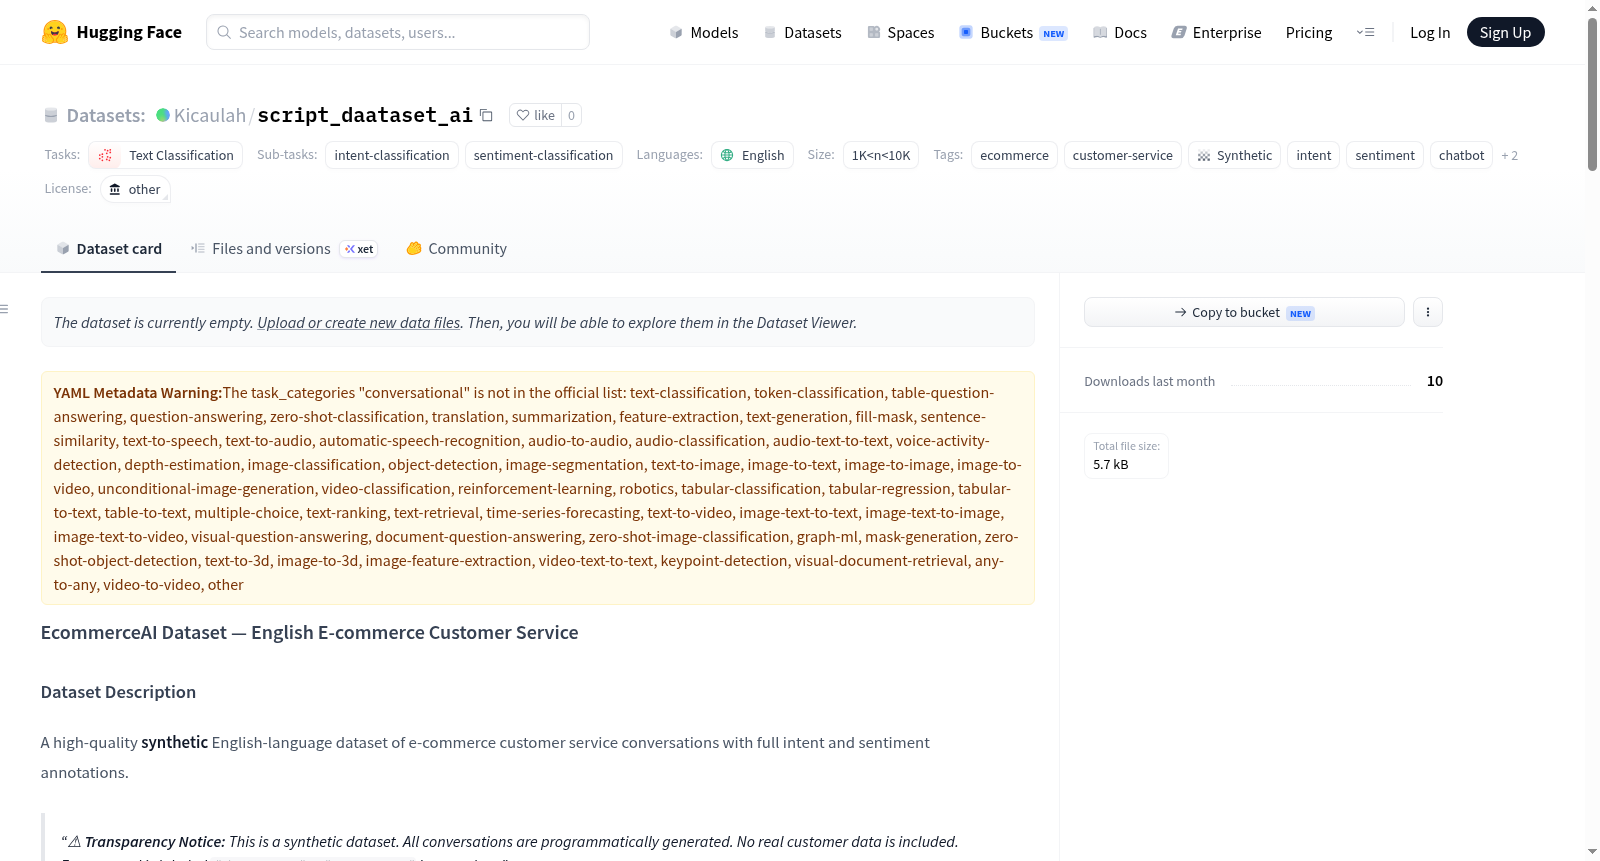
Kicaulah/script_daataset_ai 数据集图片
构建方式
该数据集以合成方式构建,专为电子商务客户服务场景设计,包含5000段英文对话,共计47028轮次,平均每段对话包含9.4个交互轮次。每条记录均附带元数据标注,涵盖问题类型、产品类别、语言及数据来源等关键信息,并明确标识为'SYNTHETIC'类型,确保无真实客户数据掺入。数据集覆盖5种问题类别(如配送延迟、错误商品)和10种产品类别,对话结构采用JSONL格式,每轮对话记录用户与客服的角色、内容、意图及情感倾向,便于多维度分析。
特点
该数据集的显著特点在于其结构化的多标签标注体系,每段对话的每个轮次均包含意图类别(共12类)和情感倾向(如积极、消极),为细粒度语义理解提供支持。数据集规模适中,介于1K至10K之间,兼顾多样性与可用性,同时通过元数据中的'quality_tier'字段标注为'enterprise'级别,暗示其高质量合成特性。此外,数据集按问题类型均衡分布(每类1000段),避免类别偏差,适用于意图分类、情感分析及对话状态追踪等研究。
使用方法
用户可通过HuggingFace Datasets库快速加载,执行'load_dataset'命令即可获取全部对话数据;亦可采用纯Python方式,直接解析JSONL文件,逐行读取并转换。针对特定需求,可依据元数据中的'issue_type'字段筛选对话子集,例如提取退款请求类数据。该数据集适合用于微调大型语言模型以构建客服聊天机器人、训练意图分类器(12类)或情感分析模型,亦可用于增强真实数据集或测试对话管道,且提供CC BY-NC 4.0许可用于研究与非商业用途。
背景与挑战
背景概述
在电子商务迅猛发展的背景下,客户服务对话数据成为优化智能客服系统、提升用户体验的关键资源。EcommerceAI Dataset 是一个高质量的合成英文电商客服对话数据集,由相关研究团队创建,旨在为意图分类、情感分析和对话系统研究提供标准化训练数据。该数据集包含5,000段对话、47,000余轮交互,覆盖延迟交货、错误商品、退款请求、商品损坏和产品咨询五大常见问题类别,并标注了12种意图和两种情感极性。其发布填补了电商领域高质量、可商用对话数据的空白,推动了客户服务聊天机器人、意图分类器和对话状态追踪等研究的发展,对学术界和工业界均具有重要参考价值。
当前挑战
该数据集所解决的领域问题核心在于电商客服场景下的意图与情感识别,挑战在于真实对话中用户表达的多样性与隐晦性,以及负面情绪的复杂变化,要求模型具备细粒度识别能力。此外,构建过程中面临多重挑战:首先,完全合成数据虽规避隐私风险,但需确保对话自然性及标注一致性,避免偏离真实分布;其次,覆盖5大问题类别和12种意图的平衡设计,要求生成算法在样本量有限(1K-10K)的前提下保持类别代表性;最后,数据集通过程序生成,缺乏真实场景的噪声属性(如拼写错误、口语化表达),可能在迁移至实际应用时存在泛化瓶颈。
常用场景
经典使用场景
script_daataset_ai 是一个专注于英文电子商务客服对话的高质量合成数据集,涵盖了 5,000 段完整对话与 47,028 次对话轮次。该数据集最经典的使用场景在于意图分类与情感分析两大自然语言处理子任务,包含 12 种意图类别和 5 种问题类型(如延迟发货、错误商品、退款请求等),每个对话轮次均标注了用户与客服的意图与情感极性。研究者可借此训练稳健的意图识别模型与情感分析系统,用于构建智能客服对话系统的基础模块。此外,数据集的多轮对话结构也使其成为对话状态追踪研究的有力支撑,能够模拟真实电商客服情境下的用户行为与客服响应。
衍生相关工作
script_daataset_ai 的出现催生了一系列相关研究工作,主要集中在数据增强、跨领域迁移学习与对话系统评估三大方向。研究者利用该数据集的合成属性与完备标注,开发了针对电商客服场景的领域自适应方法,使基于通用语料训练的模型能够快速迁移至特定问题类型。该数据集也被用作测试基准,用于对比不同规模语言模型(如 Llama 与 GPT 系列)在意图识别与情感分析上的性能差异。此外,围绕其对话结构,衍生出面向客服场景的对话状态追踪与对话策略优化技术,推动了可解释与情感感知型客服机器人的发展。
数据集最近研究
最新研究方向
该数据集聚焦于电子商务客服对话中的意图识别与情感分析,旨在构建高质量合成数据以支持大语言模型微调。前沿研究方向涵盖多轮对话状态追踪、细粒度情感理解及意图分类优化,同时可结合真实数据增强以提升模型鲁棒性。其5大类问题类别和12种意图标签的设计,精准对应电商场景中物流延误、退款纠纷等热点事件,为智能客服系统的自动化与个性化回应提供了关键训练资源,对提升客户服务效率、降低人力成本具有重要推动意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

