Independent-Offices-Appropriation-Act-1953
收藏资源简介:
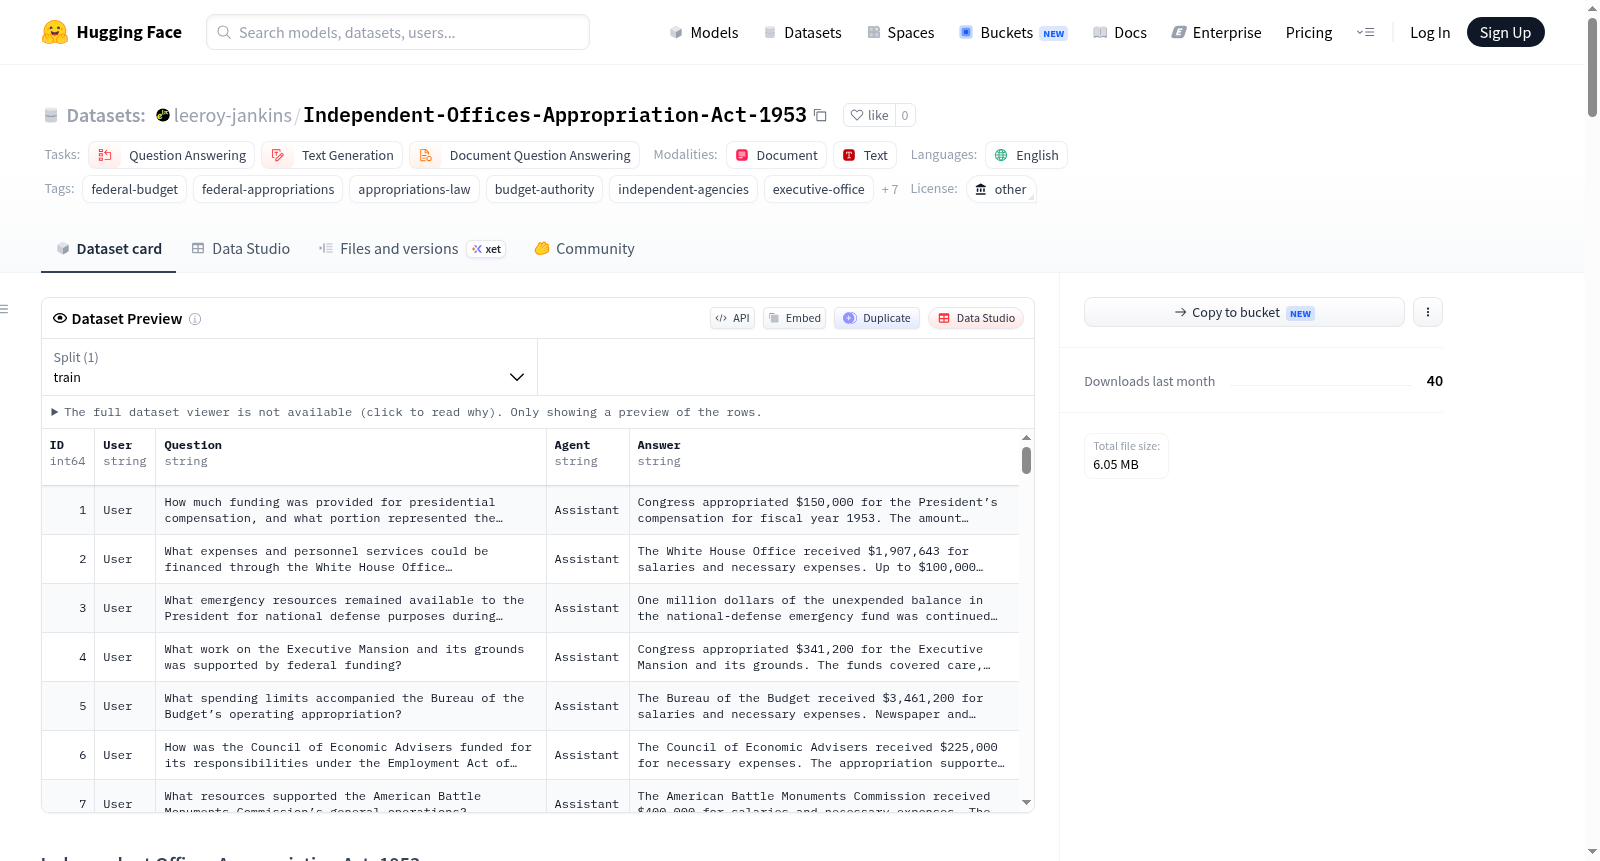
该数据集包含150条基于《1953年独立机构拨款法案》(Public Law 82-455,66 Stat. 393)的文档型问答记录。该法案为1953财年提供了总统行政办公室、众多联邦独立机构、商务部海事活动以及部分政府公司的拨款、支出授权、行政限制、转移权限、人员限制和一般财政控制,并规定了政府范围内的限制,如年假、罢工、宣传、司机、乘用车、人事管理和公共信息人员配置。数据集旨在用于联邦拨款法、预算执行、机构资金、政府公司、行政限制、转移权限、合同权限和财政年度控制等领域的语言模型训练、评估和基准测试。每条记录包含一个实质性问题和至少五句完整句子的详细答案,答案解释适用的拨款、限制、权限或行政条件,而非仅指出语言出现的位置。数据集结构包含五个字段:ID(整数型唯一标识符)、User(提问者标签,固定为User)、Question(基于源法规的实质性问题)、Agent(回答者标签,固定为Agent)和Answer(基于源法规的详细答案)。数据集仅包含训练集,共150条样本。
This dataset contains 150 document-based question-answering records based on the Independent Agencies Appropriation Act of 1953 (Public Law 82-455, 66 Stat. 393). This act provides appropriations, spending authorities, administrative restrictions, transfer authorities, personnel restrictions and general fiscal controls for the Executive Office of the President, numerous federal independent agencies, maritime activities of the Department of Commerce, and certain government corporations for fiscal year 1953, and prescribes government-wide restrictions including annual leave, strikes, propaganda, drivers, passenger vehicles, personnel management and public information staffing. This dataset is intended for large language model (LLM) training, evaluation and benchmarking in the fields of federal appropriations law, budget execution, agency funding, government corporations, administrative restrictions, transfer authorities, contract authorities and fiscal year controls. Each record contains one substantive question and a detailed answer with at least five complete sentences, which explains the applicable appropriations, restrictions, authorities or administrative conditions rather than merely identifying the location where the relevant language appears. The dataset structure includes five fields: ID (integer-type unique identifier), User (questioner label, fixed as 'User'), Question (substantive question based on the source regulation), Agent (responder label, fixed as 'Agent'), and Answer (detailed answer based on the source regulation). This dataset only contains a training set with a total of 150 samples.
数据集概述:Independent Offices Appropriation Act, 1953
基本信息
- 数据集名称:Independent Offices Appropriation Act, 1953
- 语言:英语(en)
- 许可证:其他(other);徽章标注为公共领域
- 维护者:Terry Eppler
- 所有者:美国联邦政府
- 数据集规模:100-1K条记录(实际包含150条训练样本)
- 任务类别:问答、文本生成、文档问答
- 标签:联邦预算、联邦拨款、拨款法、预算权限、独立机构、行政办公室、政府企业、海事活动、退伍军人福利、公法、法律、政府、合成数据
数据集简介
该数据集包含150条基于《1953年独立办公室拨款法案》(Independent Offices Appropriation Act, 1953)的文档型问答记录。该法案为1953财政年度提供了拨款、支出授权、行政限制、转移权限、人事限制及一般财政控制措施,适用于总统行政办公室、多个独立联邦机构、商务部海事活动及部分政府企业。法案还确立了涉及年假、反政府罢工、宣传与 propaganda、司机、乘用机动车、人事管理及公共信息人员配备等政府范围限制。
数据集旨在用于训练、评估和基准测试语言模型在联邦拨款法、预算执行、机构资金、政府企业、行政限制、转移权限、合同权限及财政年度控制等方面的能力。
来源文件
数据集源自《1953年独立办公室拨款法案》,该法案作为公法82-455于1952年7月5日颁布,见《美国法规大全》第66卷第393页(66 Stat. 393)。主要适用于截至1953年6月30日的财政年度。来源包含四个主要部分:
- 标题I — 总统行政办公室及独立办公室
- 标题II — 商务部海事活动
- 标题III — 企业
- 标题IV — 一般规定
数据集涵盖主题
数据集涵盖以下主题范围:
- 总统薪酬及行政开支
- 白宫办公室
- 总统紧急国防基金
- 行政官邸及场地
- 预算局
- 经济顾问委员会
- 美国战役纪念碑委员会
- 原子能委员会
- 文官委员会
- 联邦通信委员会
- 联邦电力委员会
- 联邦贸易委员会
- 总审计署
- 总务管理局
- 公共建筑与联邦财产管理
- 联邦供应与档案管理活动
- 战略与关键物资储备
- 住房与住房金融局
- 公共住房管理局
- 印第安人索赔委员会
- 州际商务委员会
- 铁路安全与机车检查
- 国家航空咨询委员会
- 国家科学基金会
- 重新谈判委员会
- 证券交易委员会
- 选征兵役制
- 史密森学会
- 国家美术馆
- 关税委员会
- 田纳西河流域管理局
- 美国税务法院
- 退伍军人管理局
- 退伍军人补偿、养老金、保险、医疗护理及再安置福利
- 战争索赔委员会
- 独立办公室一般规定
- 商务部海事活动
- 船舶建造与运营差价补贴
- 海事培训与州立海事学校
- 联邦国家抵押协会行政费用
- 住房贷款银行委员会行政费用
- 联邦储蓄与贷款保险公司费用
- 联邦住房管理局费用
- 内陆水道公司费用
- 政府企业支出控制
- 人事工作配置比例
- 年假限制
- 涉及罢工及暴力推翻政府的限制
- 宣传与 propaganda 限制
- 司机与乘用机动车限制
- 信息与编辑人员配置限制
涉及的机构与实体
数据集包含关于以下实体的拨款、支出限制或行政权限的问答:
- 总统行政办公室
- 白宫办公室
- 预算局
- 经济顾问委员会
- 美国战役纪念碑委员会
- 原子能委员会
- 文官委员会
- 联邦通信委员会
- 联邦电力委员会
- 联邦贸易委员会
- 总审计署
- 总务管理局
- 联邦供应局
- 国家档案与记录局
- 住房与住房金融局
- 公共住房管理局
- 印第安人索赔委员会
- 州际商务委员会
- 波托马克河流域州际委员会
- 国家航空咨询委员会
- 国家首都住房管理局
- 国家首都公园与规划委员会
- 国家科学基金会
- 重新谈判委员会
- 证券交易委员会
- 选征兵役制
- 史密森学会
- 国家美术馆
- 颠覆活动控制委员会
- 关税委员会
- 田纳西河流域管理局
- 美国税务法院
- 退伍军人管理局
- 战争索赔委员会
- 商务部海事活动
- 联邦海事委员会
- 海事管理局
- 美国商船学院
- 州立海事学校
- 联邦国家抵押协会
- 预制住房行政官办公室
- 住房贷款银行委员会
- 联邦储蓄与贷款保险公司
- 房主贷款公司
- 联邦住房管理局
- 内陆水道公司
数据结构
每条记录包含五个字段:
| 字段 | 类型 | 描述 |
|---|---|---|
ID |
整数 | 记录的唯一顺序标识符 |
User |
字符串 | 问题发言人标签,固定为 User |
Question |
字符串 | 基于来源立法的实质性提问 |
Agent |
字符串 | 回答发言人标签,固定为 Agent |
Answer |
字符串 | 基于来源立法的详细回答 |
示例记录
json { "ID": 1, "User": "User", "Question": "How much funding was provided for presidential compensation, and what portion represented the President’s expense allowance?", "Agent": "Agent", "Answer": "Congress appropriated $150,000 for the President’s compensation for fiscal year 1953. The amount included an expense allowance authorized at the rate of $50,000 per year. The allowance was based on the Act of January 19, 1949. The appropriation therefore combined compensation with a separately identified expense component. The funds were provided under the Executive Office of the President." }
每条回答至少包含五个完整句子,解释适用的拨款、限制、权限或行政条件,而非仅指出条文位置。