mvarma/medwiki
收藏资源简介:
MedWiki是一个从维基百科医学相关子集中收集的大型句子数据集,标注了统一医学语言系统(UMLS)知识库中的生物医学实体。每个实体都包含从UMLS和WikiData中获取的丰富类型信息。数据集包含超过1300万个句子和1700万个实体标注,可用作语言模型的预训练资源,并提高医学命名实体识别和消歧系统的性能,特别是对于罕见实体。数据集分为两个配置:MedWiki-Full和MedWiki-HQ,分别代表完整数据集和高质量标签子集。
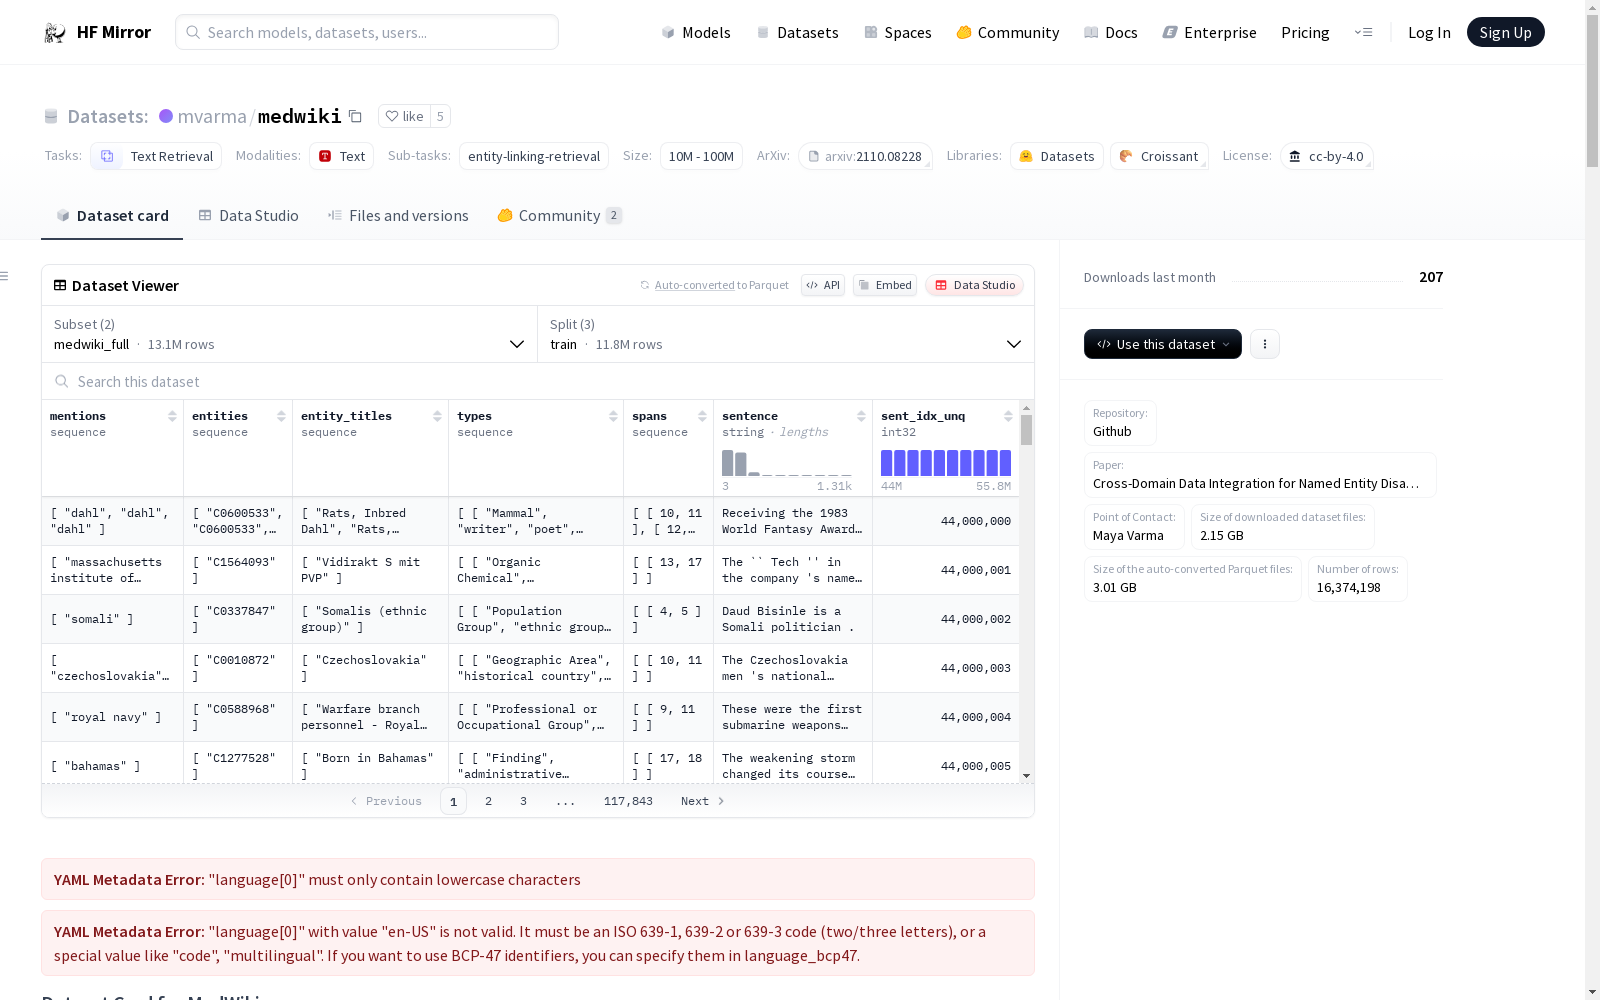
MedWiki is a large-scale sentence-level dataset curated from the medical-related subsets of Wikipedia, annotated with biomedical entities from the Unified Medical Language System (UMLS) knowledge base. Each entity is equipped with rich type information sourced from both UMLS and WikiData. The dataset contains over 13 million sentences and 17 million entity annotations, which can serve as a pre-training resource for language models and enhance the performance of biomedical named entity recognition and disambiguation systems, especially for rare entities. The dataset is divided into two configurations: MedWiki-Full and MedWiki-HQ, which represent the full dataset and the high-quality annotated subset respectively.
数据集概述
名称: MedWiki
语言: 英语 (en-US, en)
许可证: CC-BY-4.0
多语言性: 单语种
数据集大小: 未知
来源数据集: 扩展自Wikipedia
任务类别: 文本检索
任务ID: 实体链接检索
数据集描述
数据集总结: MedWiki是一个从医学相关的Wikipedia子集中收集的大规模句子数据集,注释了来自统一医学语言系统(UMLS)知识库的生物医学实体。数据集包含超过1300万句子及1700万实体注释,可作为语言模型的预训练资源,并能提升医学命名实体识别和消歧系统的性能,特别是对于罕见实体。
数据集结构:
- 数据实例: 每个数据点包含一个来自Wikipedia的句子,注释了UMLS医学实体及其相关的标题和类型。
- 数据字段: 包括
sent_idx_unq(唯一标识符)、sentence(句子文本)、mentions(医学提及)、entities(实体标识)、entity_titles(实体标题)、types(实体类型)和spans(提及的词范围)。 - 数据分割: 数据集分为
MedWiki-Full和MedWiki-HQ两种配置,每种配置的数据被分割为训练、开发和测试集。
数据集创建
来源数据:
- 初始数据收集和标准化: 数据来自2019年11月的英文Wikipedia转储,页面按80/10/10的比例分割为训练/开发/测试集,并进一步按句子级别分割。
- 源语言生产者: 英文Wikipedia的编辑。
注释:
- 注释过程: 使用弱标签技术创建
MedWiki-Full和MedWiki-HQ两种配置。MedWiki-Full通过内部页面链接和基于代词及替代实体名称的弱标签生成黄金实体标签。MedWiki-HQ则是MedWiki-Full的子集,具有更高质量的标签。
使用数据集的考虑
社会影响: 数据集旨在促进更好的生物医学文本命名实体识别系统的创建,特别是针对罕见或不常见实体。
偏见讨论: 数据来源于英文Wikipedia,可能存在由编辑者引起的偏见,尽管这种偏见在医学文章中可能较少。
其他已知限制:
由于使用弱标签技术,实体注释可能存在噪声。为解决此问题,提供了具有更高质量标签的MedWiki-HQ配置。