adaption-medical-necessity-reviews
收藏资源简介:
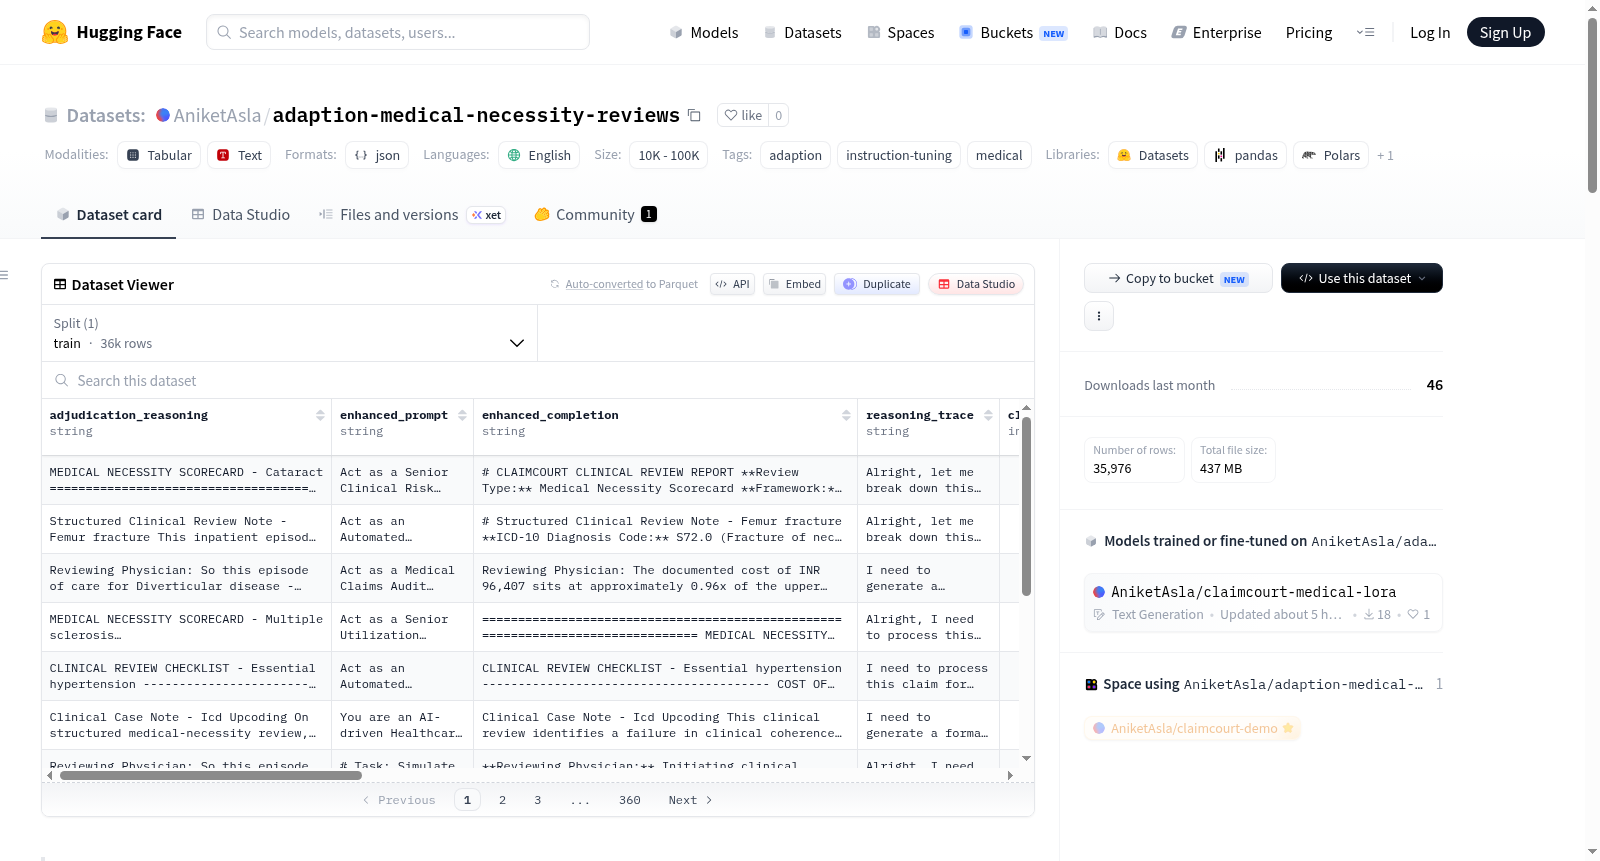
该数据集是一个使用Adaption的Adaptive Data平台重新制作的版本,源自Adaption AutoScientist Challenge, Healthcare category (Part 1, 2026)挑战赛的医疗保健类别,并获得亚军。它专注于医疗必要性审查,包含35,976个数据点,属于指令微调数据集。数据由结构化的临床审查记录和检查清单构成,用于评估各种住院病例的医疗必要性,具体涵盖费用分析、住院时间评估和设施验证等方面。每个样本都包含对所提供的护理是否具有充分医学依据的判定,通常附带置信度分数以及如药物份额、再入院间隔等具体指标。数据内容涉及多种医疗诊断,例如心肌梗死、正常分娩和创伤性脑损伤,呈现格式包括叙述性摘要和项目化检查清单。数据集领域完全为医疗(100%),语言为英语(100%),文本语气主要为技术性(47%)、分析性(35%)和专业性(18%)。经过重新制作后,数据集最终质量评级为A,相对质量提升了20.0%。
This dataset is a remastered iteration developed using Adaption's Adaptive Data Platform, derived from the Healthcare category (Part 1, 2026) of the Adaption AutoScientist Challenge, for which it secured the second place. It centers on medical necessity review and comprises 35,976 data points, categorized as an instruction-tuning dataset. The data is composed of structured clinical review records and checklists designed to assess the medical necessity of various hospitalized cases, specifically covering cost analysis, length of stay assessment, and facility validation. Each sample includes a determination on whether the provided care has sufficient medical justification, typically accompanied by confidence scores and specific metrics such as medication share and readmission interval. The dataset covers a wide array of medical diagnoses including myocardial infarction, normal delivery, and traumatic brain injury, and is available in formats of narrative summaries and itemized checklists. The dataset is exclusively dedicated to the healthcare domain (100%), with all text in English (100%). The tone of the text is primarily technical (47%), analytical (35%), and professional (18%). Following the remastering process, the dataset was assigned a final quality rating of A, with a relative quality improvement of 20.0%.
数据集概述:adaption-medical_necessity_reviews
基本信息
- 数据集名称:adaption-medical_necessity_reviews
- 语言:英语(单语)
- 领域:医疗(100%)
- 数据集大小:35,976 条数据
- 数据集类型:指令微调(instruction-tuning)数据集
数据内容
- 数据集包含结构化的临床审查笔记和检查清单,用于评估各类住院病例的医疗必要性。
- 内容涉及成本分析、住院时长、设施验证等方面。
- 每条样本包含对护理是否具有医学依据的判断,通常附带置信度评分及药物份额、再入院间隔等具体指标。
- 诊断覆盖广泛,包括心肌梗死、正常分娩、创伤性脑损伤等。
- 数据格式为叙述性摘要或分项检查清单。
数据质量
- 最终质量等级:A 级
- 相对质量提升:20.0%
语言风格分布
- 技术性:47%
- 分析性:35%
- 专业性:18%
相关荣誉
- 2026年 Adaption AutoScientist 挑战赛,医疗类别,亚军(第1部分)
来源与处理
- 数据集使用 Adaption 的 Adaptive Data 平台 进行了重新制作(remastered version)。