ipfs_angola_laws
收藏资源简介:
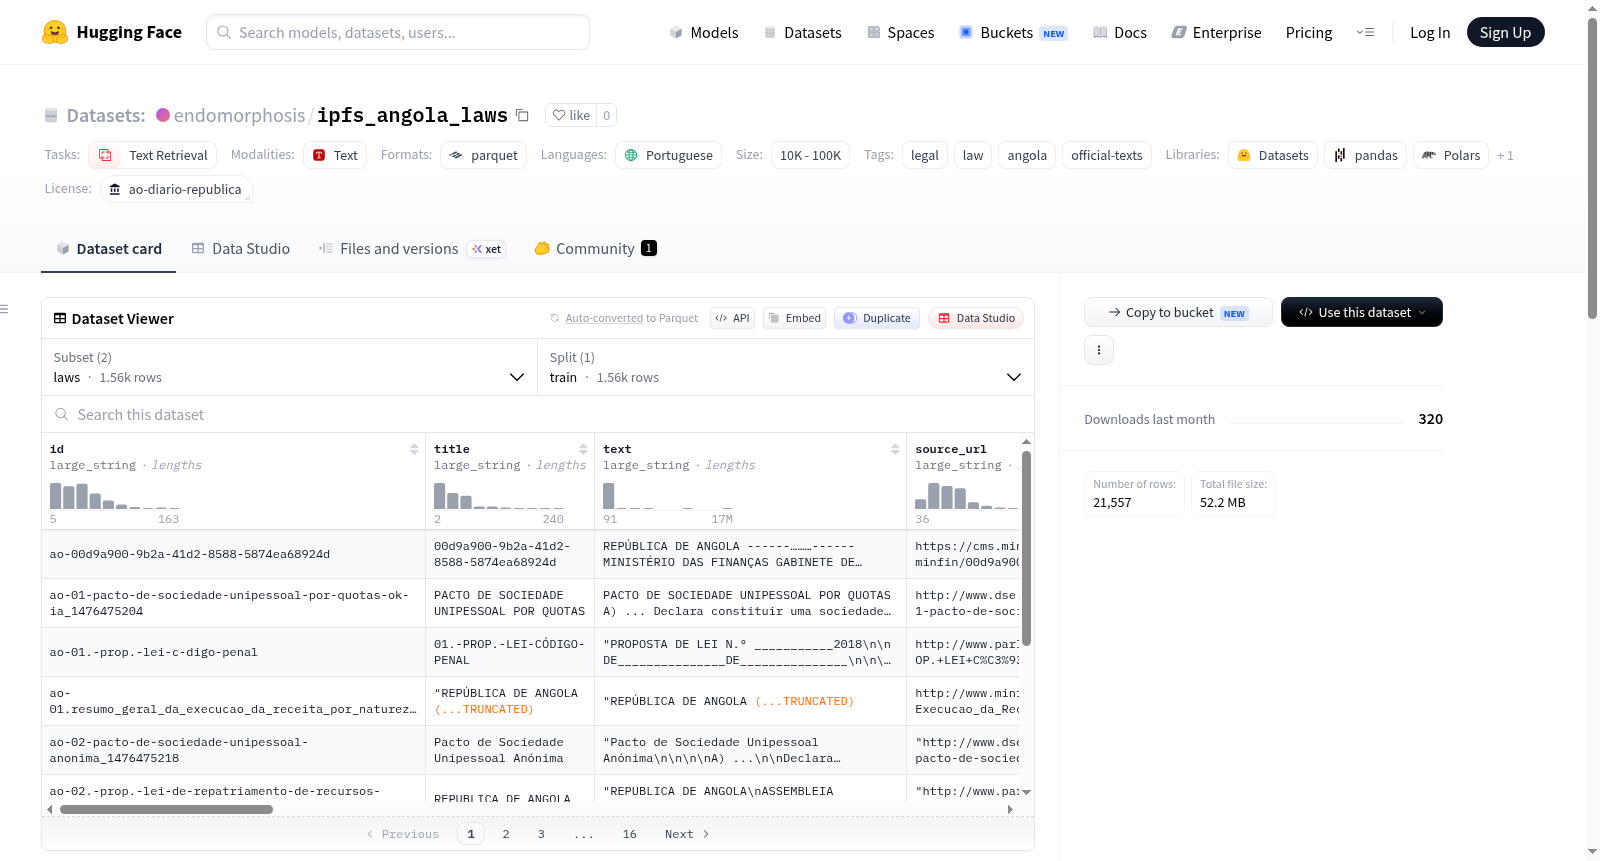
该数据集是安哥拉官方立法的研究快照,数据来源于安哥拉共和国日报(Diário da República)、政府门户网站(GUE / Portal do Governo)。数据集包含两个子集:laws 和 articles。laws 子集以每行一项法律/文书的形式存储,包含ID、标题、全文、日期、状态、标识符、条款数量和来源URL,共1436条记录。articles 子集以每行一条条款/章节的形式存储,包含法律ID、条款编号、标题、文本和来源URL,共19603条记录。数据语言为葡萄牙语,覆盖安哥拉司法管辖区。数据集提供收集器脚本(scrapers/collect_ao.py)用于构建此快照。注意:本数据集不是官方整合版本,不构成法律建议,官方公报或政府门户网站应作为权威来源。许可证为 ao-diario-republica,适用于研究用途。
This dataset is a research snapshot of Angolas official legislation, sourced from the Diário da República and the government portal (GUE / Portal do Governo). It contains two subsets: laws and articles. The laws subset stores each law/document as a row, including ID, title, full text, date, status, identifier, number of articles, and source URL, with 1,436 records. The articles subset stores each article/section as a row, including law ID, article number, title, text, and source URL, with 19,603 records. The data language is Portuguese, covering the jurisdiction of Angola. The dataset provides a collector script (scrapers/collect_ao.py) for building this snapshot. Note: This dataset is not an official consolidated version and does not constitute legal advice; official gazettes or government portals should be used as authoritative sources. The license is ao-diario-republica, suitable for research purposes.
数据集概述
安哥拉法律数据集(Laws of Angola) 是一个以葡萄牙语收录安哥拉官方立法文本的研究型快照数据集,内容采集自安哥拉共和国日报(Diario da Republica)、GUE 及政府门户网站(Portal do Governo)。
基本信息
| 项目 | 内容 |
|---|---|
| 数据集名称 | Laws of Angola |
| 语言 | 葡萄牙语(pt) |
| 司法辖区 | 安哥拉 |
| 任务类别 | 文本检索 |
| 标签 | 法律、安哥拉、官方文本 |
| 许可证 | ao-diario-republica(其他) |
| 快照日期 | 2026-09-07 |
| 数据规模 | 1K < n < 10K |
数据内容
数据集包含两个配置,均为 Parquet 格式:
- laws(
data/laws.parquet):每行对应一份法律文书,包含编号、标题、全文、日期、状态、标识符、条款数量及来源 URL。 - articles(
data/articles.parquet):每行对应一个条款或章节,包含法律编号、条款序号、标题、正文及来源 URL。
规模统计:
- 法律文书/工具:1556 份
- 条款:20001 条
附带资源
数据集中还包含研究采集器脚本:
scrapers/collect_ao.py— 构建此快照的研究采集器scrapers/common.py— 共享采集辅助工具scrapers/world_lib.py— 共享抓取功能(实时官方 URL、Wayback 回退)scrapers/archive_fallbacks.py— Wayback / Common Crawl CDX 辅助功能
使用与许可说明
- 数据来源为官方政府/公报文本,复用需遵守源门户的公共部门条款。
- 该数据集不是官方整合版本,不构成法律建议,官方来源具有优先效力。
- 采集覆盖范围标注为“catalog-backed incomplete”,即基于目录支持的不完整覆盖。