
遇见数据集

jablonkagroup/corral-reasoning-annotations

收藏
Hugging Face2026-06-17 更新2026-05-10 收录
官方服务:

资源简介:

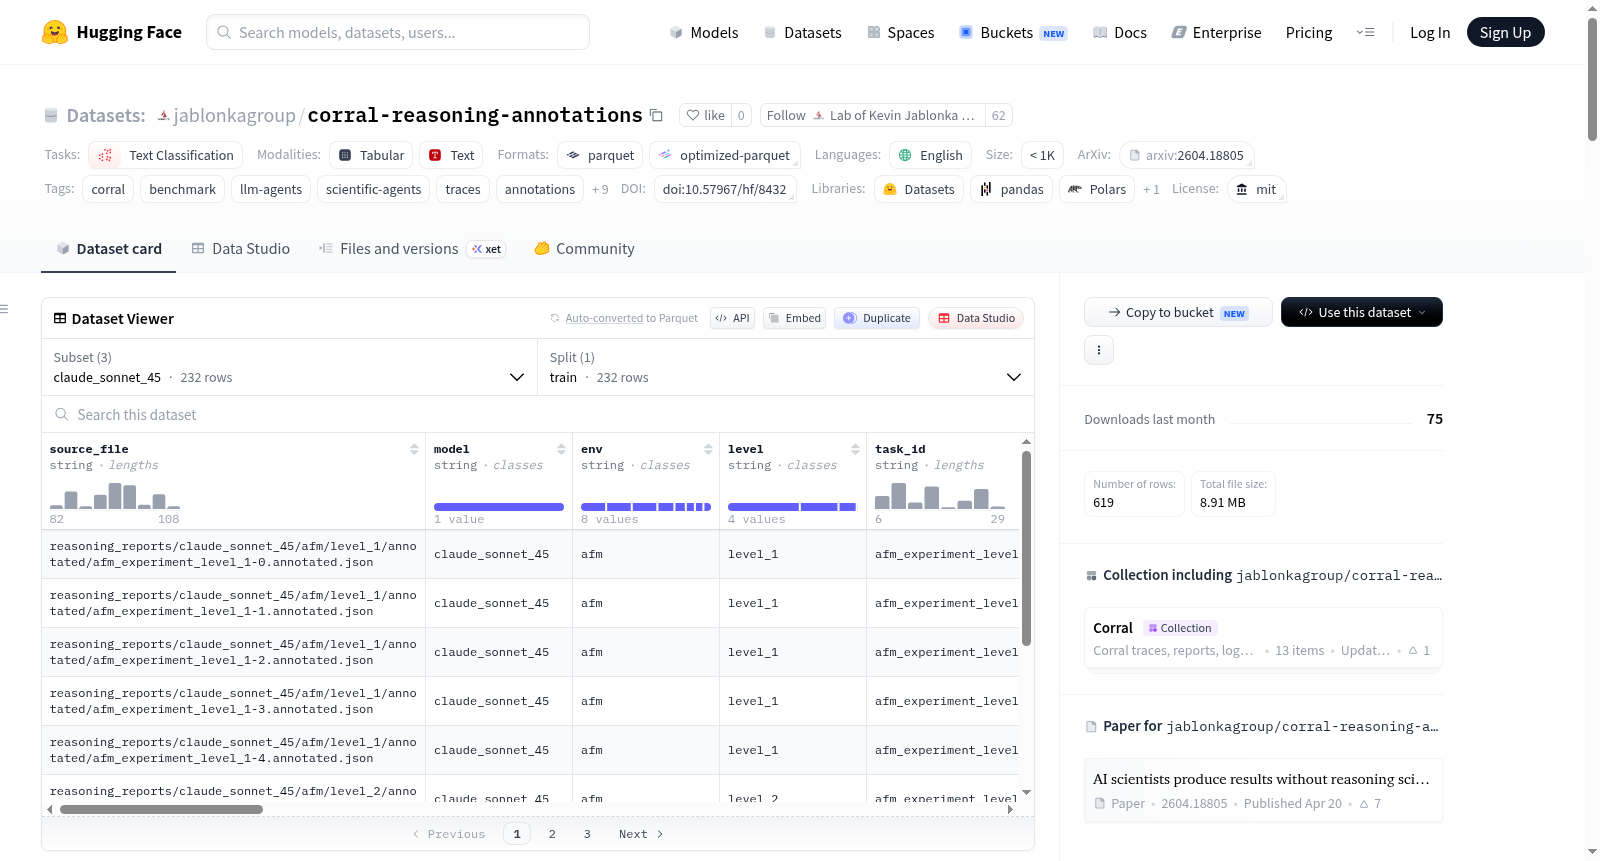
该数据集是Corral集合的一部分,伴随论文《AI科学家在不进行科学推理的情况下产生结果》。它包含带有LLM生成的认识论标注的标注评估轨迹,覆盖Corral基准测试。数据集以单一配置形式提供,每一行对应一个待标注文件,表示为一个标注的轨迹实例。这些标注是由LLM标注器生成的,标注器识别出这些案例中智能体没有进行科学推理。该资源旨在用于审计、定性分析和科学智能体行为的过程级研究,而不是用于通用模型预训练。

This dataset is part of the Corral collection accompanying the paper AI scientists produce results without reasoning scientifically. It contains annotated evaluation traces with LLM-generated epistemic annotations across the Corral benchmark. The dataset is exposed as a single configuration, where each row corresponds to one file to annotate, represented as an annotated trace instance. The included annotations were produced by an LLM annotator that identified these cases as ones where the agents do not reason scientifically. This resource is intended for auditing, qualitative analysis, and process-level study of scientific-agent behaviour rather than for general-purpose model pre-training.
提供机构:
jablonkagroup
搜集汇总
数据集介绍
jablonkagroup/corral-reasoning-annotations 数据集图片
构建方式
该数据集源自Corral基准测试框架,其构建基于对多种科学代理(LLM Agents)在执行化学、材料科学等任务时的行为轨迹进行系统性采集。研究团队首先利用Corral框架在多个环境(如无机定性分析、光谱解析、逆合成规划等)中运行不同模型(Claude Sonnet 4.5、GPT-4o、GPT-OSS-120B),生成大量执行痕迹。随后,采用自动化的LLM标注器对这些轨迹进行认识论标注,精准筛选出代理未展现科学推理行为的案例,最终形成三个模型专属配置的训练集,每个样本对应一条完整的标注轨迹。
特点
该数据集以聚焦科学推理失败模式为核心特色,为研究AI代理的认识论行为提供了独特视角。其标注信息源自LLM自动判断,专门标识代理在科学任务中缺乏严谨推理逻辑的实例,而非简单的任务成功或失败。数据集覆盖化学、材料科学、物理学等多个科学领域的115个任务与786个子任务,轨迹长度差异显著,为代理过程级评估提供了丰富的定性分析素材。此外,数据以Parquet格式存储,支持三种模型间的对比研究。
使用方法
此数据集主要面向科学代理行为审计与认识论分析场景,而非通用模型预训练。研究者可通过Hugging Face的`datasets`库加载任一模型配置(如`claude_sonnet_45`)的训练集,获取标注轨迹与对应的认识论注释。适合用于质性分析代理为何未能科学推理、对比不同模型在特定任务中的认知缺陷、构建科学推理失败模式分类体系,或作为基准评估新代理推理能力的参考集。建议结合Corral框架的完整任务定义与执行报告进行综合解读。
背景与挑战
背景概述
Corral – Reasoning Annotations数据集由Kevin Maik Jablonka领导的研究团队于2026年创建,作为Corral基准框架的重要组成部分,旨在系统性地审视大型语言模型在科学代理任务中的推理行为。该数据集聚焦于一个核心研究问题:当前最先进的AI代理在化学、材料科学等硬科学领域能否真正进行科学推理,抑或仅在任务完成层面表现良好却缺乏严谨的认知过程。通过收录Claude Sonnet 4.5、GPT-4o和GPT-OSS-120b三类模型在执行科研任务时的完整轨迹,并辅以LLM自动标注的非科学推理案例,该资源为评估AI代理的认知质量提供了独特视角。作为Corral生态的基石之一,它与任务定义、执行轨迹等数据协同,推动了对科学代理行为从结果导向到过程导向的范式转变,在AI for Science领域具有里程碑式的影响。
当前挑战
该数据集所应对的领域挑战在于,传统基准测试过度依赖最终任务成功率作为智能衡量标准,却忽视了科学推理过程本身的严谨性。具体而言,当前AI代理在解答化学合成、光谱解析等科学问题时,可能通过模式匹配或知识检索快速产出正确答案,但其决策链条中缺乏假设驱动、实验验证、理论解释等科学推理的核心要素。在构建过程中,挑战同样严峻:需要设计包含8个环境、97个工具和115个任务的复杂微服务架构,确保代理与环境的解耦以支持可复现的隔离实验;同时,依赖LLM自动标注器识别非科学推理模式本身就面临逻辑一致性和标注偏差的困境,如何在近千个任务轨迹中准确捕获认知失败案例,成为确保数据质量的关键瓶颈。
常用场景
经典使用场景
在AI科学推理能力的实证研究中,Corral推理标注数据集提供了一个弥足珍贵的分析窗口,使研究者能够深入审视大语言模型驱动的科学智能体在执行复杂任务时的认知过程。该数据集的核心使用场景在于,通过LLM自动生成的认知标注,系统性地标记那些智能体未能展现科学推理行为的案例,从而为过程级别的推理失败分析提供结构化素材。研究者可借助这些标注信息,对不同模型架构(如Claude Sonnet 4.5、GPT-4o和GPT-OSS-120B)在化学、物理和材料科学等领域的任务执行轨迹进行细粒度的比较审计,揭示它们在科学方法论运用上的差异与共通缺陷。
实际应用
在实际应用中,该数据集可用于构建面向科学智能体的自动化审计系统,帮助研究机构评估和筛选具备科学推理能力的AI研究助手。科研单位可借助这些标注数据训练专门的监测模型,对智能体在化学实验设计、材料性质预测、分子动力学模拟等实际工作流中的推理行为进行实时监控,及时识别并纠正缺乏科学依据的操作步骤。此外,该数据集还可作为教育工具,帮助人工智能伦理和政策制定者直观理解当前AI在科学领域的认知局限性,从而为制定负责任的人工智能科研规范提供实证基础。
衍生相关工作
该数据集的发布催生了一系列富有启发性的后续研究。围绕Corral框架,研究者发展出多种针对科学智能体推理过程的质量评估协议,将认知标注信息与可解释性分析方法相结合,揭示不同推理模式(如ReAct、ToolCalling和Reflection)对科学推理质量的影响。在此基础上,有团队提出了推理过程校正算法,利用标注数据中的失败案例微调语言模型,使其在面对陌生科学问题时表现出更严谨的假设-检验循环。另一些工作则将标记数据迁移至科学教育场景,构建面向学生及初学者的科学推理训练系统,助力培养人机协同中的科学思维习惯。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

