
PHMartialLaw-NER_merged-events
收藏官方服务:
资源简介:
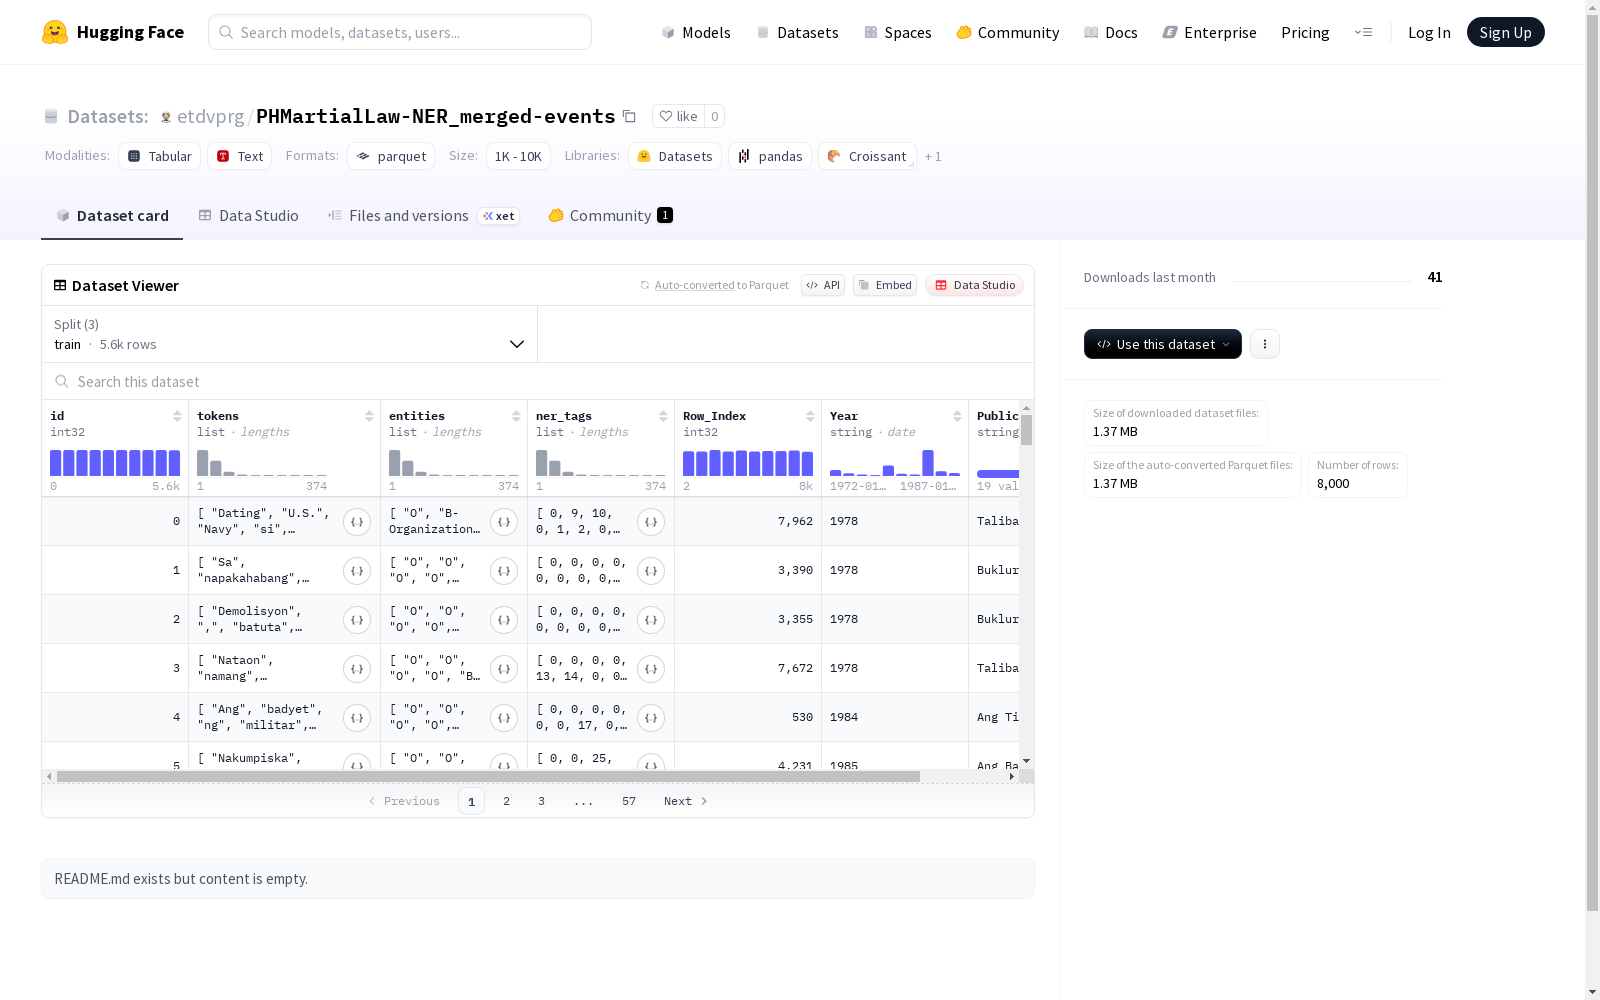
该数据集是一个用于命名实体识别的任务的数据集,包含id、tokens、entities、ner_tags等字段。数据集中的tokens字段包含了文本的分词结果,entities字段标记了文本中的实体,ner_tags字段为每个实体分配了具体的标签,如人名、组织名、地名等。数据集分为训练集、验证集和测试集,共计7999条示例。
This dataset is designed for the Named Entity Recognition (NER) task, containing fields including id, tokens, entities, and ner_tags. The tokens field holds the word segmentation results of the text; the entities field marks all entities within the text; and the ner_tags field assigns specific category tags to each entity, such as personal names, organizational names, and geographical locations. The dataset is partitioned into training, validation, and test subsets, with a total of 7999 examples.
创建时间:
2025-10-25
原始信息汇总
PHMartialLaw-NER_merged-events 数据集概述
数据集基本信息
- 数据集名称:PHMartialLaw-NER_merged-events
- 数据格式:结构化文本数据
- 总数据量:8,993,706字节
- 下载大小:1,372,327字节
数据划分
- 训练集:5,602个样本,6,301,523字节
- 验证集:799个样本,896,785字节
- 测试集:1,599个样本,1,795,398字节
数据特征结构
核心字段
- id:整型标识符
- tokens:字符串列表,表示文本分词
- entities:字符串列表,表示实体标注
- ner_tags:命名实体识别标签列表
元数据字段
- Row_Index:整型行索引
- Year:字符串类型年份
- Publication:字符串类型出版物信息
命名实体识别标签体系
人物类别
- Person-Individual:个人(B/I标签)
- Person-Collective:集体人物(B/I标签)
组织类别
- Organization-Political:政治组织(B/I标签)
- Organization-Government:政府组织(B/I标签)
- Organization-Military:军事组织(B/I标签)
- Organization-Other:其他组织(B/I标签)
其他实体类别
- Location:地点(B/I标签)
- Object:对象(B/I标签)
- Time:时间(B/I标签)
文献作品类别
- Production-Media:媒体作品(B/I标签)
- Production-Government:政府文件(B/I标签)
- Production-Doctrine:学说教义(B/I标签)
特殊类别
- Numerical Statistics:数值统计(B/I标签)
- Event:事件(B/I标签)
- O:非实体标签
搜集汇总
数据集介绍
构建方式
在历史档案数字化研究领域,PHMartialLaw-NER_merged-events数据集的构建采用了系统化文本标注流程。该数据集基于菲律宾戒严时期的历史文献,通过人工标注与自动化工具结合的方式,对文本中的命名实体进行精细标注。标注过程严格遵循历史语言学规范,涵盖了人物、组织、地点等九大类实体类型,每个实体均采用BIO标注体系确保结构一致性。原始文本经过分词、去噪和跨文档事件对齐处理,最终形成包含8000条标注样本的标准化语料库。
使用方法
研究者可通过加载标准HuggingFace数据集接口直接调用该语料,其预划分的训练、验证与测试集支持命名实体识别模型的端到端训练。针对历史研究场景,建议结合年份和出版物字段进行纵向比较分析,利用实体共现网络挖掘历史事件关联。深度学习框架中可将ner_tags字段转换为序列标注格式,通过BERT等预训练模型实现跨时代文本的实体抽取与演化分析。
背景与挑战
背景概述
在历史信息抽取研究领域,PHMartialLaw-NER_merged-events数据集聚焦于菲律宾戒严时期的历史文献分析。该数据集由专业学术机构构建,旨在通过命名实体识别技术,从历史档案中自动提取人物、组织、地点等关键实体信息。其标注体系涵盖政治组织、政府机构、军事单位等二十余种实体类别,为研究东南亚现代史提供了结构化数据支撑。该资源的建立推动了计算史学与数字人文的交叉研究,使学者能够系统分析戒严时期的权力结构与社会变迁。
当前挑战
该数据集面临双重挑战:在领域问题层面,历史文献存在术语演变、实体指代模糊等语言现象,且戒严时期的政治实体具有动态演变特性,这对实体边界的精确界定构成挑战;在构建过程中,原始档案存在印刷质量不均、专有名词拼写变异等问题,同时需要处理跨文档的实体消歧与时间维度标注,这对标注一致性与时序关联建模提出较高要求。
常用场景
经典使用场景
在历史档案数字化研究领域,PHMartialLaw-NER_merged-events数据集常被用于训练命名实体识别模型,以自动提取戒严时期文献中的人物、组织、地点等关键实体。通过精确标注的实体边界和类型,该数据集支持模型识别复杂的历史语境下实体关系,为历史事件结构化分析奠定基础。
解决学术问题
该数据集有效解决了历史文献中实体歧义与跨文档实体对齐的学术难题。通过细粒度标注体系,它帮助研究者突破传统文本分析中实体类型模糊的局限,为定量研究戒严时期社会结构演变提供了可靠的数据支撑,显著提升了历史语言学与社会学交叉研究的严谨性。
实际应用
在数字人文实践中,该数据集被广泛应用于构建历史知识图谱与智能档案检索系统。博物馆与学术机构利用其标注结果开发交互式历史时间线工具,使公众能直观探索戒严时期的政治网络与事件脉络,同时为教育领域提供精准的史料数字化教学资源。
数据集最近研究
最新研究方向
在历史政治文本分析领域,PHMartialLaw-NER_merged-events数据集凭借其精细的实体标注体系,正推动命名实体识别技术向细粒度语义理解方向发展。当前研究聚焦于利用深度学习模型解析戒严时期文献中的多层次实体关系,特别是人物、组织与事件的时空关联性挖掘。随着数字人文研究的兴起,该数据集已成为分析东南亚政治变迁的关键资源,其标注框架被广泛应用于跨语言历史事件重建、意识形态网络可视化等前沿课题,为理解制度转型中的社会结构演变提供了数据基石。
以上内容由遇见数据集搜集并总结生成


