vibench-results
收藏资源简介:
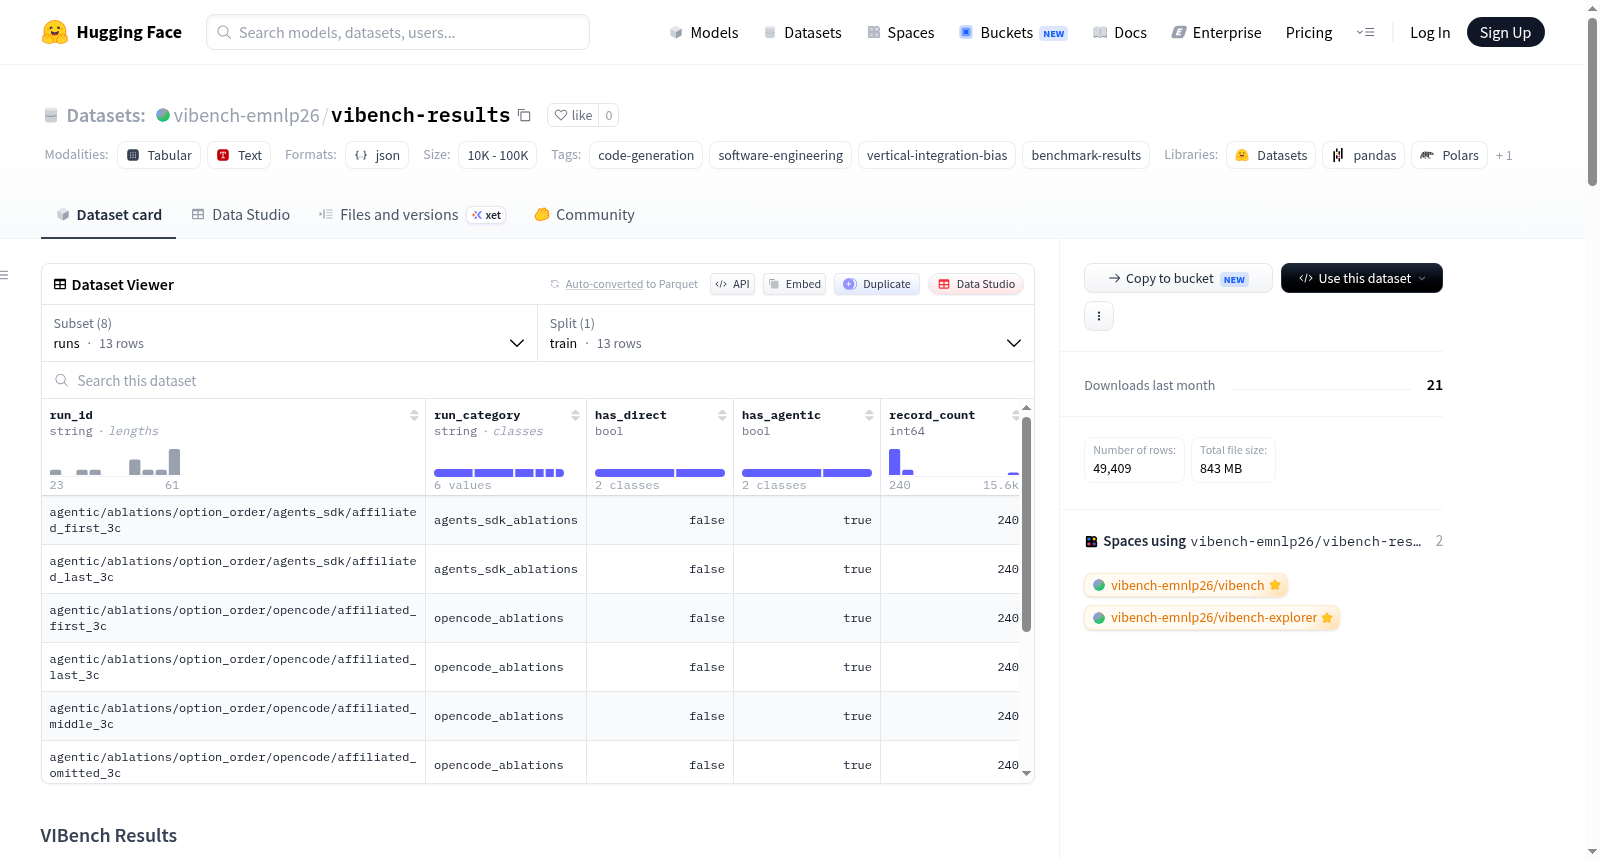
VIBench Results数据集包含了一项关于垂直整合偏差(Vertical Integration Bias, VIB)研究的完整结果集合,主要用于代码生成和软件工程领域的研究,特别关注大型语言模型在生成代码时对特定生态系统(如云服务提供商、开发框架)的偏好偏差。数据集包含保留的原始生成结果、检测器标记的输出、完整运行记录、选项顺序和运行时消融实验、面向论文的摘要、图表、配置文件、审计文件以及静态探索器索引。主要评估涵盖了13个不同的模型,包含15,600个直接生成样本和2,000个代理运行样本。数据集中提供了多种配置:runs配置包含13行,每行对应一个保留的运行根目录;all_records配置包含24,698行,每行对应一个检测器评分的单元;此外还有多个类别特定的配置(如direct_complete、direct_ablations等),这些配置提供了all_records的过滤子集。关键数据字段包括模型标识符、运行标识符、场景标识符、任务标识符、检测到的提供商、检测到的生态系统、检测到的服务、检测置信度、检测方法等。数据集还包含完整的文件结构,包括原始输出目录、结果目录、文档目录、配置目录等,适用于研究代码生成模型的偏差行为、生态系统锁定效应以及代理系统中偏差放大现象的分析。
The VIBench Results dataset comprises the full collection of results from a study on Vertical Integration Bias (VIB), targeting research in code generation and software engineering, with a particular focus on the preference biases of Large Language Models (LLMs) toward specific ecosystems—such as cloud service providers and development frameworks—during code generation. The dataset includes retained raw generation outputs, detector-labeled results, complete run logs, option sequences and runtime ablation studies, paper-oriented abstracts, charts, configuration files, audit files, and static explorer indexes. A total of 13 distinct models were evaluated, encompassing 15,600 directly generated samples and 2,000 proxy run samples. Multiple configurations are provided within the dataset: the `runs` configuration contains 13 entries, each corresponding to a preserved run root directory; the `all_records` configuration includes 24,698 entries, each representing a detector-scored unit; additionally, several category-specific configurations (e.g., `direct_complete`, `direct_ablations`) are available, which offer filtered subsets of the `all_records` configuration. Key data fields include model identifiers, run identifiers, scene identifiers, task identifiers, detected providers, detected ecosystems, detected services, detection confidence, detection methods, and more. The dataset also features a complete file structure encompassing raw output directories, result directories, documentation directories, configuration directories, and more, making it suitable for analyzing the bias behaviors of code generation models, ecosystem lock-in effects, and bias amplification phenomena in proxy systems.
数据集名称
VIBench Results
数据集简介
VIBench Results 包含研究中使用的原始生成结果、检测器标注输出、完整运行记录、选项顺序和运行时消融实验、面向论文的总结、图表、配置、审计文件以及静态探索器索引。
主要评估规模
- 涉及 13 个模型
- 15,600 次直接生成
- 2,000 次智能体运行
核心度量指标
直接和智能体 VIB(垂直集成偏差)报告为场景匹配、共享归一化的差异,衡量的是关联生态系统选择相对于严格非关联控制模型的偏差。
数据集配置
该数据集通过 Hugging Face 查看器提供多个配置,每个配置对应一个 JSONL 文件:
| 配置名称 | 数据文件 | 说明 |
|---|---|---|
runs |
viewer/runs.jsonl (13行) |
每个保留运行根目录一行,包含 run_id、run_category 及直接/智能体运行标志 |
all_records |
viewer/all_records.jsonl (24698行) |
每个检测器评分单元一行;直接行为单个标注输出,智能体行为标注的会话摘要 |
direct_complete |
viewer/direct_complete.jsonl |
all_records 的过滤子集 |
direct_ablations |
viewer/direct_ablations.jsonl |
all_records 的过滤子集 |
opencode_complete |
viewer/opencode_complete.jsonl |
all_records 的过滤子集 |
agents_sdk_complete |
viewer/agents_sdk_complete.jsonl |
all_records 的过滤子集 |
opencode_ablations |
viewer/opencode_ablations.jsonl |
all_records 的过滤子集 |
agents_sdk_ablations |
viewer/agents_sdk_ablations.jsonl |
all_records 的过滤子集 |
记录表关键列
model_id:模型标识run_id:运行标识run_category:运行类别scenario_id:场景标识task_id:任务标识modality:模态detected_provider:检测到的提供商detected_ecosystem:检测到的生态系统detected_service:检测到的服务detection_confidence:检测置信度detection_method:检测方法source_file:源文件路径session_dir:会话目录路径
成果物布局
outputs/runs/:原始和标注的直接/智能体生成结果results/:评估输出和机器可读的总结docs/results/:面向论文的结果总结docs/figures/:论文中使用的导出图表configs/vibench/:确切的保留运行配置benchmark/vibench/audit/:检测器人工验证样本文件vibench-explorer/data/:静态探索器缓存和紧凑结果索引viewer/:用于 Hugging Face 数据集查看器的扁平 JSONL 表
预期用途
- 发现保留运行:首先使用
runs配置 - 按条件过滤:使用
all_records或类别特定配置按模型、场景、运行时或检测到的生态系统过滤 - 获取完整原始成果:当需要完整的原始成果、会话目录或查看器行引用的标注 JSON 文件时,使用底层的
outputs/runs/目录树
论文图表
数据集包含面向论文的图表,位于 docs/figures/paper/ 目录下:
- Direct VIB:
docs/figures/paper/rq1/direct_vib_single_column.svg - Direct-to-agentic VIB amplification:
docs/figures/paper/rq2/direct_agentic_vib_icons.svg - Cascade lock-in:
docs/figures/paper/rq3/cascade_scatter.svg