
遇见数据集

genshin-voice

收藏
Hugging Face2026-08-09 更新2026-08-10 收录
官方服务:

资源简介:

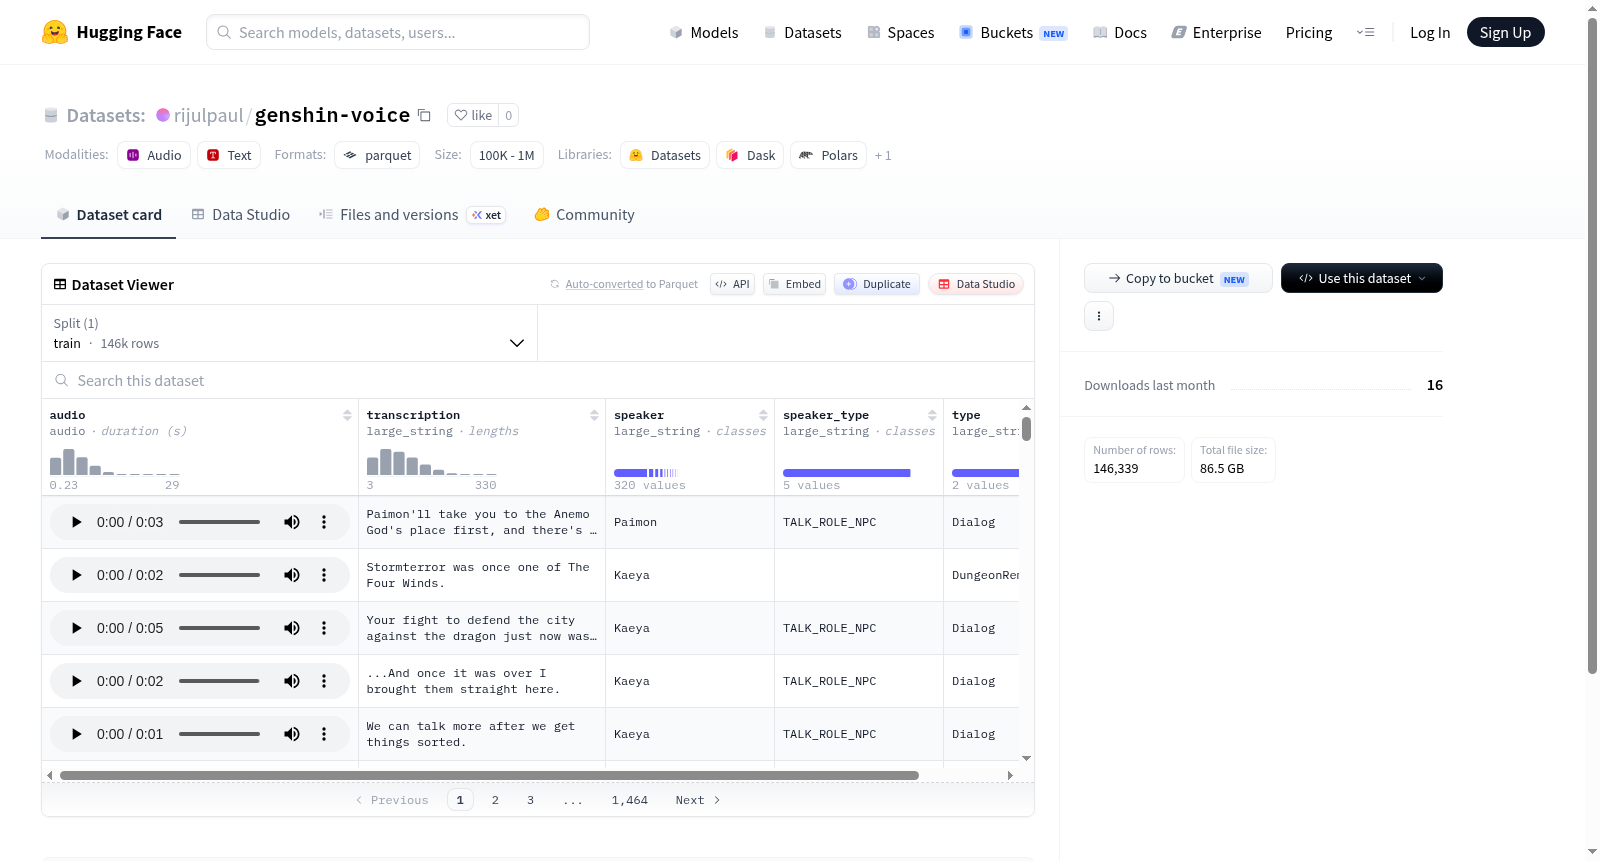
该数据集是一个多字段语音数据集,包含音频文件及其对应的转录文本、说话人标识、说话人类型和样本类型。训练集包含146,339个样本,总数据量约为86GB。音频字段以未解码的二进制格式存储,转录文本为字符串类型。该数据集可适用于语音识别、说话人识别、说话人分类等任务。

This dataset is a multi-field speech dataset containing audio files along with their corresponding transcribed text, speaker identifiers, speaker types, and sample types. The training set consists of 146,339 samples with a total data volume of approximately 86GB. Audio fields are stored in undecoded binary format, while transcribed text is of string type. This dataset is suitable for tasks such as speech recognition, speaker recognition, and speaker classification.

创建时间:
2026-08-08
原始信息汇总

数据集概述:genshin-voice

该数据集为《原神》游戏角色的语音数据集,由rijulpaul上传至Hugging Face平台,用于语音相关的研究与模型训练。

数据集基本信息

  • 数据集名称:genshin-voice
  • 数据集大小:约86.48 GB(下载大小86.48 GB,解压后大小86.48 GB)
  • 样本数量:共146,339条训练样本
  • 数据集格式:包含音频文件和对应的文本转录信息

数据特征字段

该数据集包含以下字段:

字段名 数据类型 说明
audio 音频 语音音频文件(未解码格式)
transcription large_string 音频对应的文本转录内容
speaker large_string 说话人(角色)名称
speaker_type large_string 说话人类型(如角色类型)
type large_string 数据类型或分类标签

数据划分

  • 训练集(train):包含146,339条样本,占用空间86.48 GB

数据用途

该数据集适用于语音识别、语音合成、说话人识别、角色语音分析等任务,特别是针对《原神》游戏角色的语音处理相关研究。

注意:数据集中仅包含训练集划分,未提供验证集或测试集,用户需要根据需求自行划分数据。
搜集汇总
数据集介绍
genshin-voice 数据集图片
构建方式
该数据集以《原神》游戏内语音为素材,系统化采集并整合了众多角色的音频样本。构建过程中,每个样本均配备对应的文本转写、角色标识(speaker)及角色类型(speaker_type)等元数据,形成了结构化的语音-文本对。数据分为单一的训练集,含超过14.6万个样本,总数据量逾86GB,音频文件以原始格式存储,便于后续解码处理。
特点
数据集规模庞大,覆盖了《原神》中丰富多样的角色语音,具有高度的领域针对性。每个音频样本附带精确的文本转写,有利于语音识别(ASR)模型的训练。同时,speaker和speaker_type属性为多说话人语音合成与说话人验证提供了细粒度标注,而type字段可能用于区分语音类型(如战斗、剧情等),增强了数据集的多样性和应用潜力。
使用方法
使用时,可通过HuggingFace的datasets库加载数据,音频特征以`decode: false`存储,允许用户按需解码以节省内存。典型的应用流程包括:利用`load_dataset`读取数据,再基于音频文件和转写文本构建语音识别模型,或结合说话人信息进行多说话人语音合成。鉴于数据量大,建议采用流式或分批次处理以适应计算资源限制。
背景与挑战
背景概述
《原神》作为一款全球现象级开放世界角色扮演游戏,其庞大的角色阵容和丰富的剧情对话构成了海量多语言语音数据资源。genshin-voice数据集由社区爱好者于近期整理发布,旨在系统性地提取并标注游戏中的语音片段,涵盖角色台词、剧情对白及战斗语音等多种类型。该数据集通过结构化字段(音频、转写文本、说话人及类型)组织,共包含超过14.6万个音频样本,总数据量约86.5GB,规模可观。其创建初衷在于为语音识别(ASR)、说话人识别、语音合成(TTS)以及多模态情感计算等研究领域提供高质量的、带文本标注的真实游戏语音语料。鉴于现有公开语音数据集多聚焦于日常对话或朗读场景,缺乏针对虚拟角色风格化语音的资源,genshin-voice填补了这一空白,为探索非真实说话人语音的建模、角色语音风格迁移及游戏智能交互等方向提供了宝贵数据支撑,对语音领域与数字娱乐交叉研究具有显著推动作用。
当前挑战
该数据集构建与利用面临多重挑战。一方面,从领域问题看,原始语音源自游戏音频,背景音乐、环境音效及角色特效声混叠严重,信噪比低,且角色语音常带有夸张情绪表现、特殊语速与风格化口音,这给语音识别模型的鲁棒性带来严峻考验;同时,同一角色在不同场景下语音风格差异显著,如何实现细粒度的说话人识别与风格解耦成为难题。另一方面,构建过程挑战重重:海量音频需从游戏资源中精确截取与对齐,依靠自动切分和人工校对结合,耗时费力且易引入标签噪声;各字段标注(如说话人、语音类型)依赖玩家社群对游戏剧情的深度理解,主观差异导致标注一致性问题;数据规模庞大,存储与传输成本高,对计算资源提出极高要求,且游戏版权限制使得数据合规性存疑,限制了其开放共享与商业应用。
常用场景
经典使用场景
该数据集汇集了游戏《原神》中角色的语音数据,共计14.6万余条音频样本,每一条都配有对应的文本转写、说话人标识及其分类。在语音合成与语音识别研究中,此类多说话人、多语种(若包含)语音数据是构建高自然度语音合成系统以及鲁棒性语音识别模型的宝贵资源。其丰富的角色类型、情感表达和生活化对话内容,为跨域声音克隆、语音风格迁移等前沿课题提供了坚实的实验基础。
衍生相关工作
基于该数据集,科研人员已衍生出若干经典工作,例如多说话人语音合成基线模型的构建、说话人验证预训练任务的设计,以及语音-文本跨模态表征学习的探索。此外,针对游戏语音中的噪声与口癖处理,还催生了语音增强与净化技术的研究。这些衍生工作不仅丰富了该数据集的价值,也为语音领域提供了可复用的实验范式与评测基准。
数据集最近研究
最新研究方向
在多模态语音处理与游戏角色配音合成领域,genshin-voice数据集的出现为研究者提供了前所未有的丰富资源。该数据集包含逾14.6万条训练样本,覆盖多元角色类型与说话人特征,其规模与精细标注为跨语言语音合成、情感语音转换及说话人验证等前沿课题奠定了坚实基础。尤其在开放世界游戏声学建模与个性化语音交互系统构建中,此数据集赋能了从文本到高保真拟真语音的端到端生成研究,并推动了针对游戏特定语境的语音识别与韵律建模方法的创新。其影响不仅局限于娱乐技术,更扩展至虚拟助手、无障碍交流等广泛的人机交互场景,成为连接语音学术研究与实际应用的关键纽带。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

