
遇见数据集

jablonkagroup/corral-QAs

收藏
Hugging Face2026-06-17 更新2026-06-21 收录
官方服务:

资源简介:

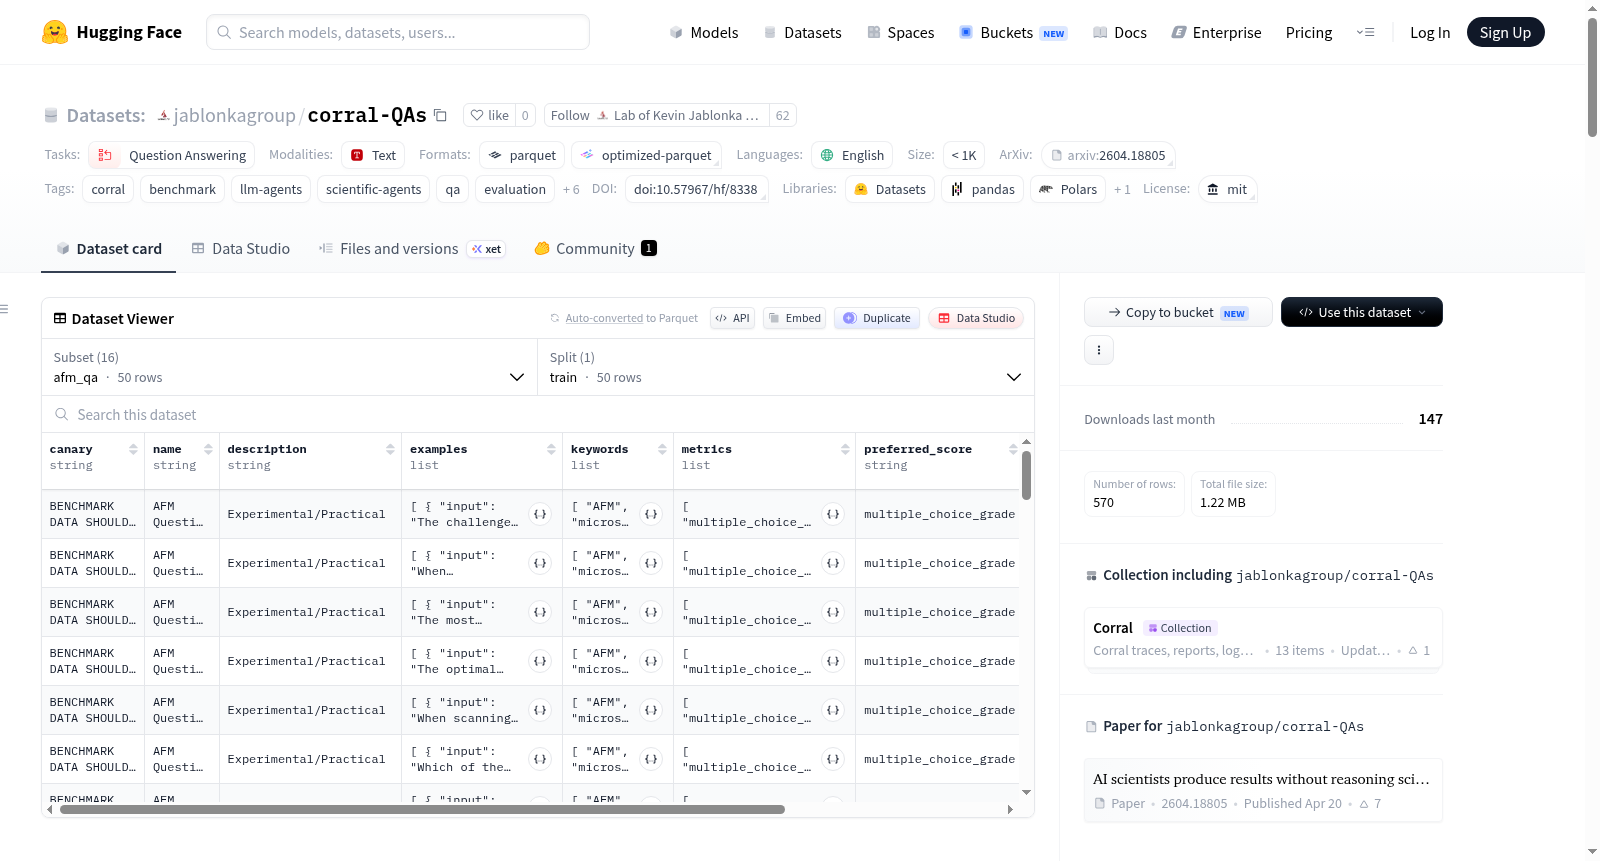
该数据集是Corral集合的一部分,包含用于测试模型在8个Corral环境中事实知识和推理能力的问题-答案对。数据集按16个配置组织,对应8个环境和两个评估维度(知识和推理)的笛卡尔积。这些QA对用于项目反应理论分析,作为潜在知识和推理因素的指标。数据集主要用于评估、心理测量建模和科学智能体能力分析,而非通用模型预训练。

This dataset is part of the Corral collection, containing question-answer pairs for testing models' factual knowledge and reasoning capabilities across 8 Corral environments. It is organized into 16 configurations, which correspond to the Cartesian product of the 8 environments and two evaluation dimensions: knowledge and reasoning. These QA pairs are used for Item Response Theory (IRT) analysis, serving as indicators of latent knowledge and reasoning factors. The dataset is primarily intended for evaluation, psychometric modeling, and scientific AI Agent capability analysis, rather than general-purpose model pre-training.
提供机构:
jablonkagroup
搜集汇总
数据集介绍
jablonkagroup/corral-QAs 数据集图片
构建方式
Corral–QAs数据集构建于Corral基准框架之上,旨在系统性地评估科学智能体(scientific agent)的领域知识与推理能力。数据集以Corral框架涵盖的8个科学环境(如光谱结构解析、逆合成规划、分子动力学模拟等)为基础,为每个环境分别生成两类问题:一类聚焦于事实性知识,另一类着重于多步推理过程。问题的设计基于各环境中的任务内容、领域知识及推理需求,确保其能够有效探测智能体在特定科学场景下的认知深度。构建完成后,这些问题被应用于项目反应理论(IRT)建模,作为考察知识与推理两个潜在维度的指标项。
特点
该数据集在结构上呈现出高度系统化的特征,共包含16个配置,对应8个环境与两个评价维度的笛卡尔积。每个配置均提供单一的训练集划分,并以parquet格式存储便于高效加载。数据集覆盖化学、物理、材料科学等多个科学领域,问题类型兼顾检索型知识与推理型问题,使评估不再局限于任务完成率,而是深入到智能体的认知结构层面。所有问答对均经由IRT框架验证,已作为论文中知识与推理潜在因素分析的核心数据来源,具有良好的方法学基础与可重复性。
使用方法
该数据集主要面向研究用途,尤其适合用于科学智能体能力评估、IRT建模复现以及认知因子分析。用户可通过Hugging Face Datasets库直接加载,调用load_dataset函数并指定配置名称如'afm_knowledge'或'retrosynthesis_reasoning'即可获取对应环境与维度的问答数据。每条数据为一个独立的问答对实例,可直接用于模型评估或心理测量分析。建议配合Corral框架中的任务定义、执行轨迹及推理注释一同使用,以获得更全面的科学智能体能力画像。数据集基于MIT协议发布,开放给学术界与工业界自由使用。
背景与挑战
背景概述
Corral-QAs数据集由Jablonka课题组于2026年创建,发表于arXiv预印本《AI scientists produce results without reasoning scientifically》,旨在通过项目反应理论(IRT)精准分离科学智能体的领域知识与推理能力。该数据集覆盖8个科学环境(涵盖化学、物理及材料科学实验、光谱解析、逆合成规划、机器学习属性预测等),共16个子集,分别针对各环境的知识问答与推理问答。作为Corral框架的核心评估组件,它为智能体能力剖析提供了标准化测试工具,推动了科学智能体可解释性评估的范式革新,在AI for Science领域中具有里程碑意义。
当前挑战
该数据集解决的关键领域挑战在于现有基准过度关注最终任务成功率而无法区分智能体究竟是基于事实知识还是逻辑推理完成任务。传统评估方法难以捕捉智能体在化学、材料科学等复杂科学场景中的认知结构差异。构建过程中面临的挑战包括:需在每个具体科学环境中设计能有效隔离知识与推理因子的问答对,确保题目既覆盖环境专属的领域知识又涵盖多步推理操作;同时要保证1600余个题项在IRT建模中具备良好的心理测量学特性(如难度、区分度),最终实现科学智能体潜变量的可靠估计。
常用场景
经典使用场景
在科学智能体评估领域,Corral-QAs数据集作为标杆性评测资源,其最经典的应用场景在于系统性地量化科学智能体在化学、材料科学等八类实验环境中的事实知识掌握程度与逻辑推理能力。通过将知识型与推理型问答对进行泾渭分明的划分,研究者得以借助项目反应理论(IRT)模型,科学地抽取出智能体内部潜藏的认知结构,从而实现对科学智能体能力图谱的精细刻画。该数据集所构建的标准化评估框架,为跨环境、跨任务的智能体性能比较提供了坚实、可复现的度量基准,是推动科学语言智能体从任务导向的成功率评价迈向认知导向的深度分析的关键基石。
衍生相关工作
围绕Corral-QAs数据集,学术界衍生了若干具有深远影响的研究脉络。最为核心的是催生了利用项目反应理论构建科学智能体心理测量模型的研究方向,研究者通过分析不同能力维度上的问答响应模式,揭示智能体认知能力的潜在结构与个体差异。此外,该数据集也推动了科学智能体元评估框架的建立,促使学界开发出专门用于评测评测数据质量与区分度的校准工具。在模型解释性方面,基于该数据集的细粒度能力剖面分析,启发了对科学智能体内部知识表征与推理路径的可视化与归因研究,特别是在理解大语言模型如何整合多模态科学信息进行因果推断这一前沿课题上,Corral-QAs提供了不可替代的实证基础。
数据集最近研究
最新研究方向
该数据集聚焦于构建用于评估科学智能体(AI科学家)事实知识储备与多步推理能力的标准化测评基准。依托Corral微服务架构下覆盖化学、物理、材料科学的八个实验环境,研究者采用项目反应理论(IRT)对知识-推理双维度的潜在能力因子进行数学建模,旨在量化揭示当前AI系统在科学任务中脱离严谨逻辑推理、仅凭模式匹配产生正确结果的局限性。这一数据集为跨环境的能力横向对比、心理计量模型在AI测评中的迁移应用,以及从认知维度解构科学智能体行为提供了关键支撑,引发了关于大型语言模型科学推理真实性评估的热议。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

