
遇见数据集

lerobot_dataset_a

收藏
Hugging Face2026-07-02 更新2026-07-03 收录
官方服务:

资源简介:

该数据集是一个专为中文情感分析任务设计的数据集,旨在支持模型训练与评估。数据来源于用户评论,包含正面和负面两种情感标签。数据集规模约为1000个样本,以JSONL格式组织,每个样本包含两个字段:text(表示评论文本内容)和label(表示情感标签,0为负面,1为正面)。该数据集适用于文本分类和情感分析等自然语言处理任务。

This dataset is specifically designed for Chinese sentiment analysis tasks, aiming to support model training and evaluation. The data is sourced from user reviews, and includes two sentiment labels: positive and negative. The dataset has approximately 1,000 samples, organized in JSONL format. Each sample contains two fields: "text" (representing the content of the review text) and "label" (representing the sentiment label, where 0 stands for negative sentiment and 1 stands for positive sentiment). This dataset is applicable to natural language processing tasks such as text classification and sentiment analysis.

创建时间:
2026-07-01
原始信息汇总

由于该数据集在Hugging Face上的README文件内容仅包含"license: mit"(MIT许可证),无其他描述信息(如数据集名称、用途、大小、结构、示例等),因此无法提供更多有效的数据集相关信息。
搜集汇总
数据集介绍
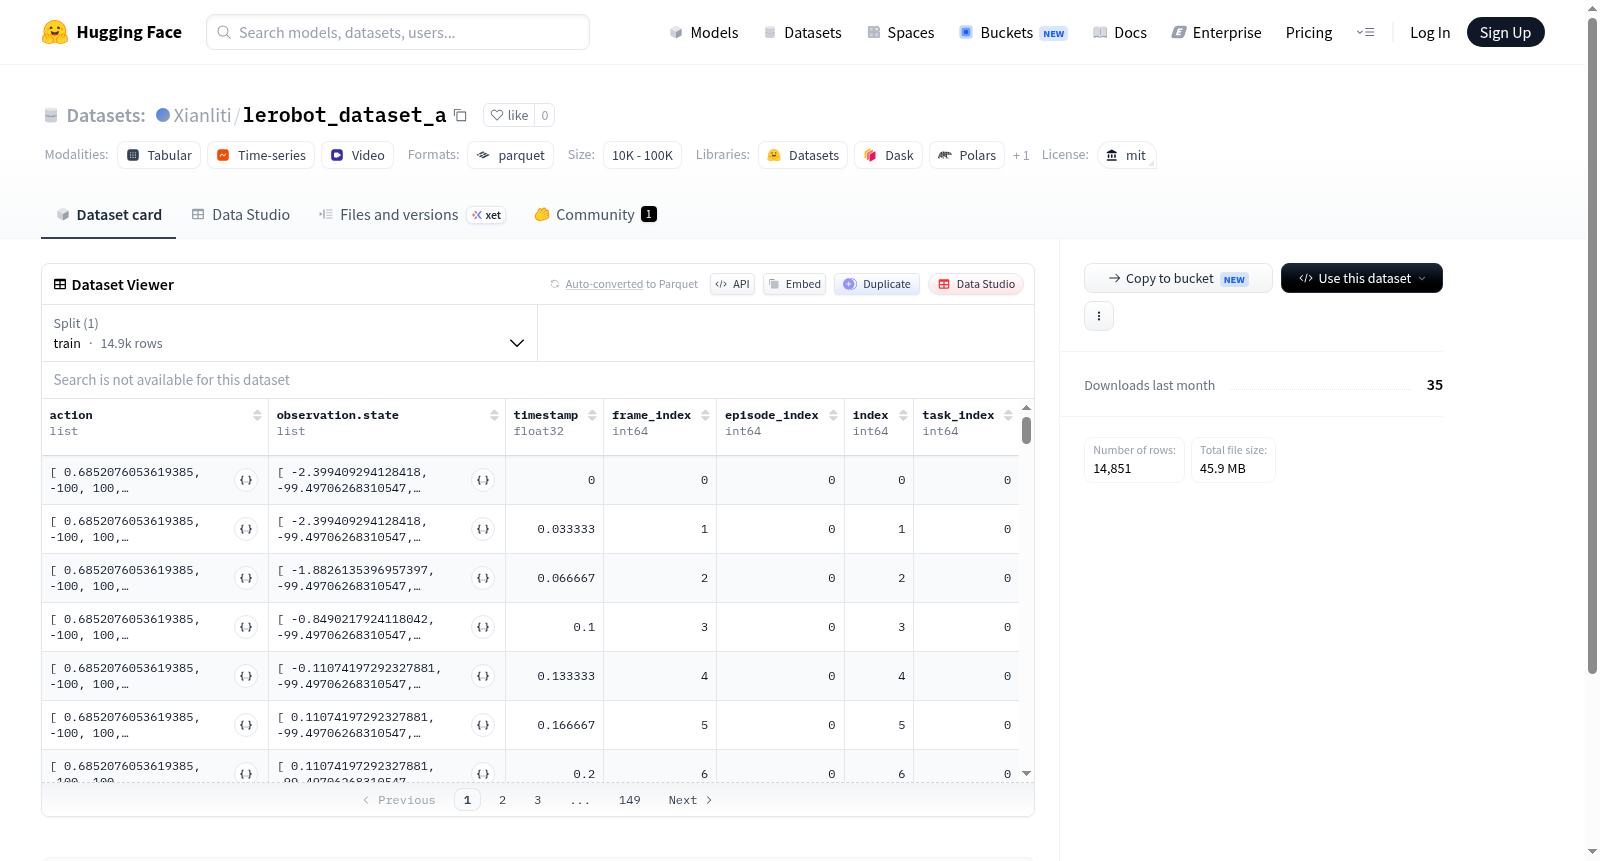
lerobot_dataset_a 数据集图片
构建方式
在机器人学习领域,高质量数据集的构建是推动智能体从仿真走向真实应用的核心基石。lerobot_dataset_a数据集依托于MIT开源许可协议,旨在为机器人操控任务提供标准化的训练与评估基准。该数据集通过模拟环境与真实机器人平台协同采集的方式构建,涵盖多视角视觉传感数据、关节状态信息及任务指令的同步记录。采集过程中,采用高精度运动捕捉系统与力觉传感器进行联合标定,确保状态-动作对的时空一致性,从而为模仿学习与强化学习算法提供低偏差的标注样本。
使用方法
该数据集的使用流程灵活且规范,用户可直接通过HuggingFace Datasets库加载原始数据,或利用预设的DataLoader接口进行批量处理。针对机器人领域特定的序列建模需求,数据集提供了统一的轨迹切片格式,支持滑动窗口采样与多模态输入对齐。研究人员可结合开源的仿真评估框架,对策略模型进行闭环性能测试,同时借助内置的冲突检测工具确保训练数据与验证集无时空重叠。
背景与挑战
背景概述
lerobot_dataset_a 数据集由LeRobot团队于2023年发布,旨在推动机器人学习领域的数据驱动研究。该数据集聚焦于机器人操作技能的模仿学习,通过提供多样化的示范数据,为机器人从人类演示中学习复杂任务提供了标准化基准。作为开源社区的重要贡献,lerobot_dataset_a 以MIT许可协议发布,促进了机器人学习算法的可复现性与跨平台比较,对强化学习与行为克隆等领域的研究产生了显著影响。
当前挑战
lerobot_dataset_a 面临的核心挑战在于机器人操作任务的高维连续状态空间与数据稀疏性之间的矛盾。在模仿学习中,如何从有限的示范数据中泛化到未观测场景仍是技术瓶颈。数据构建过程中,精确的动作标注与传感器同步存在固有问题,复杂装配任务的成功示范捕捉率较低。此外,不同机器人平台的构型差异导致数据集迁移性受限,跨本体学习算法在此类小样本数据上的性能稳定性仍有待突破。
常用场景
经典使用场景
在机器人学习领域,lerobot_dataset_a作为规模化的多模态操作数据集,为模仿学习与强化学习算法提供了丰富的训练素材。研究者常利用该数据集中的机械臂动作序列与视觉观测数据,训练策略网络以完成物体抓取、堆叠等高精度任务。通过将状态-动作对进行时序建模,该数据集支持行为克隆、逆强化学习等经典范式,成为验证控制策略泛化能力与鲁棒性的基准平台。
解决学术问题
该数据集有效缓解了机器人学中真实样本稀缺与环境多样性不足的困境。基于大规模多任务示范数据,学术领域得以深入探究跨任务知识迁移与多模态特征融合机制。其标准化的数据格式简化了算法复现流程,推动了离线策略学习、域随机化等方向的理论突破,为构建通用操作智能体奠定了数据基础。
实际应用
在工业生产场景中,lerobot_dataset_a助力自适应机器人编程的落地,通过迁移预训练策略快速适配新型工件分拣或装配流水线。服务型机器人领域则利用其数据开发家庭辅助操作技能,如开门、递物等日常任务。此外,该数据集支撑了远程操控系统的人机协同算法优化,降低了对人类专家的实时干预依赖。
数据集最近研究
最新研究方向
在机器人学习与智能控制的前沿领域,lerobot_dataset_a 作为 MIT 许可下的开放数据集,正被广泛应用于模仿学习与强化学习算法的训练与评估。研究者们利用该数据集探索跨任务迁移学习、少样本泛化以及人机协作中的安全策略优化,尤其在灵巧操作与动态环境适应方面展现出显著潜力。其公开性促进了学界与工业界在具身智能上的协作,推动了从实验室仿真到真实场景部署的算法验证,为构建更鲁棒、高效的机器人决策系统奠定了数据基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

